Descargar el archivo de flujo de trabajo en formato JSON
+Descargar archivo de flujo de trabajo en formato Json
También puedes descargar manualmente [ace_step_v1_3.5b.safetensors](https://huggingface.co/Comfy-Org/ACE-Step_ComfyUI_repackaged/blob/main/all_in_one/ace_step_v1_3.5b.safetensors) y guardarlo en la carpeta `ComfyUI/models/checkpoints` -### 2. Completa el flujo de trabajo paso a paso +### 2. Completar el flujo de trabajo paso a paso - + 1. Asegúrate de que el nodo `Load Checkpoints` haya cargado el modelo `ace_step_v1_3.5b.safetensors` -2. (Opcional) En el nodo `EmptyAceStepLatentAudio` puedes definir la duración de la música que se va a generar -3. (Opcional) En el nodo `LatentOperationTonemapReinhard` puedes ajustar el `multiplier` para controlar el volumen de la voz (valores más altos hacen que la voz destaque más) -4. (Opcional) Introduce los estilos musicales correspondientes, etc., en el campo `tags` de `TextEncodeAceStepAudio` +2. (Opcional) En el nodo `EmptyAceStepLatentAudio`, puedes establecer la duración de la música que se va a generar +3. (Opcional) En el nodo `LatentOperationTonemapReinhard`, puedes ajustar el `multiplier` para controlar el volumen de las voces (los números más altos dan como resultado voces más prominentes) +4. (Opcional) Introduce los estilos de música correspondientes, etc. en el campo `tags` de `TextEncodeAceStepAudio` 5. (Opcional) Introduce la letra correspondiente en el campo `lyrics` de `TextEncodeAceStepAudio` -6. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter`, para ejecutar la generación de audio -7. Cuando el flujo de trabajo termine,, puedes escuchar el audio generado en el nodo `Save Audio`. Puedes hacer clic para reproducirlo, y el audio también se guardará en `ComfyUI/output/audio` (el subdirectorio lo determina el nodo `Save Audio`). +6. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de audio +7. Cuando el flujo de trabajo termine, puedes previsualizar el audio generado en el nodo `Save Audio`. Puedes hacer clic para reproducirlo y escucharlo, y el audio también se guardará en `ComfyUI/output/audio` (el subdirectorio lo determina el nodo `Save Audio`). ## Flujo de trabajo de audio a audio con ACE-Step en ComfyUI -De forma similar a los flujos de trabajo de imagen a imagen, puedes ingresar un fragmento de música y usar el flujo de trabajo de abajo para remuestrear y generar música. También puedes ajustar la diferencia respecto al audio original controlando el parámetro `denoise` en el `Ksampler`. +De forma similar a los flujos de trabajo de imagen a imagen, puedes introducir una pieza musical y usar el flujo de trabajo de abajo para volver a muestrear y generar música. También puedes ajustar la diferencia respecto al audio original controlando el parámetro `denoise` del `Ksampler`. ### 1. Descargar el archivo del flujo de trabajo Haz clic en el botón de abajo para descargar el archivo del flujo de trabajo correspondiente. Arrástralo a ComfyUI para cargar la información del flujo de trabajo. -Descargar archivo de flujo de trabajo en formato JSON
+Descargar el archivo de flujo de trabajo en formato JSON
Descarga el siguiente archivo de audio como audio de entrada: -Descargar archivo de audio de ejemplo para la entrada
+Descargar el archivo de audio de ejemplo para la entrada
### 2. Completar el flujo de trabajo paso a paso - + 1. Asegúrate de que el nodo `Load Checkpoints` haya cargado el modelo `ace_step_v1_3.5b.safetensors` 2. Sube el archivo de audio proporcionado en el nodo `LoadAudio` -3. (Opcional) Ingresa los estilos musicales y la letra correspondientes en los campos `tags` y `lyrics` de `TextEncodeAceStepAudio`. Proporcionar la letra es muy importante para la edición de audio -4. (Opcional) Modifica el parámetro `denoise` del nodo `Ksampler` para ajustar el ruido que se añade durante el muestreo y así controlar la similitud con el audio original (los valores más pequeños dan como resultado una mayor similitud con el audio original; establecerlo en `1.00` equivale aproximadamente a no tener entrada de audio) +3. (Opcional) Introduce los estilos musicales y la letra correspondientes en los campos `tags` y `lyrics` de `TextEncodeAceStepAudio`. Proporcionar la letra es muy importante para la edición de audio +4. (Opcional) Modifica el parámetro `denoise` del nodo `Ksampler` para ajustar el ruido añadido durante el muestreo y controlar la similitud con el audio original (los valores más pequeños dan como resultado una mayor similitud con el audio original; establecerlo en `1.00` equivale aproximadamente a no tener entrada de audio) 5. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de audio 6. Cuando el flujo de trabajo termine, puedes previsualizar el audio generado en el nodo `Save Audio`. Puedes hacer clic para reproducirlo y escucharlo, y el audio también se guardará en `ComfyUI/output/audio` (el subdirectorio lo determina el nodo `Save Audio`). -También puedes usar la funcionalidad de modificación y edición de la letra de la página del proyecto ACE-Step, modificando la letra original para cambiar el efecto del audio. +También puedes implementar la funcionalidad de modificación y edición de la letra de la página del proyecto ACE-Step, modificando la letra original para cambiar el efecto del audio. ### 3. Notas adicionales sobre el flujo de trabajo -1. En el flujo de trabajo de ejemplo, puedes cambiar los `tags` de `TextEncodeAceStepAudio` de `male voice` a `female voice` para generar voces femeninas. -2. También puedes modificar los `lyrics` de `TextEncodeAceStepAudio` para cambiar la letra y, con ello, el audio generado. Consulta los ejemplos de la página del proyecto ACE-Step para más detalles. +1. En el flujo de trabajo de ejemplo, puedes cambiar `tags` en `TextEncodeAceStepAudio` de `male voice` a `female voice` para generar voces femeninas. +2. También puedes modificar `lyrics` en `TextEncodeAceStepAudio` para cambiar la letra y, con ello, el audio generado. Consulta los ejemplos de la página del proyecto ACE-Step para ver más detalles. ## Guía de prompts de ACE-Step -Actualmente, ACE usa dos tipos de prompts: `tags` y `lyrics`. +ACE actualmente usa dos tipos de prompts: `tags` y `lyrics`. -- `tags`: se usan principalmente para describir estilos musicales, escenas, etc. De forma similar a los prompts que usamos en otras generaciones, describen sobre todo el estilo general y los requisitos del audio, y se separan con comas en inglés. -- `lyrics`: se usan principalmente para describir la letra y admiten etiquetas de estructura como [verse], [chorus] y [bridge] para distinguir las distintas partes de la letra. También puedes escribir nombres de instrumentos para música puramente instrumental. +- `tags`: se usan principalmente para describir estilos musicales, escenas, etc. De forma similar a los prompts que usamos para otras generaciones, describen sobre todo el estilo general y los requisitos del audio, y se separan con comas en inglés. +- `lyrics`: se usan principalmente para describir la letra y admiten etiquetas de estructura como [verse], [chorus] y [bridge] para distinguir las distintas partes de la letra. También puedes introducir nombres de instrumentos para música puramente instrumental. -Puedes encontrar abundantes ejemplos de `tags` y `lyrics` en la [página del modelo ACE-Step](https://ace-step.github.io/). Puedes consultar esos ejemplos para probar los prompts correspondientes. La guía de prompts de este documento está organizada a partir del proyecto para ayudarte a probar combinaciones rápidamente y lograr el efecto que buscas. +Puedes encontrar abundantes ejemplos de `tags` y `lyrics` en la [página principal del modelo ACE-Step](https://ace-step.github.io/). Puedes consultar estos ejemplos para probar los prompts correspondientes. La guía de prompts de este documento está organizada a partir del proyecto para ayudarte a probar combinaciones rápidamente y conseguir el efecto que deseas. ### Etiquetas (prompt) -#### Estilos musicales populares +#### Estilos musicales convencionales -Usa combinaciones cortas de etiquetas para generar estilos musicales concretos +Usa combinaciones cortas de etiquetas para generar estilos musicales específicos - electronic - rock @@ -131,8 +133,8 @@ Combina situaciones de uso y atmósferas concretas para generar música que enca - clean vocals #### Términos profesionales -Usa algunos términos habituales del mundo de la música para controlar con precisión el resultado musical -- 110 bpm (110 pulsaciones por minuto) +Usa algunos términos profesionales habituales en la música para controlar con precisión el resultado musical +- 110 bpm (beats per minute is 110) - fast tempo - slow tempo @@ -145,9 +147,9 @@ Usa algunos términos habituales del mundo de la música para controlar con prec - variance=0.3 (controla el grado de diferencia entre la música generada y el estilo original) */} {/* - Edición de la letra: - - editar la letra: 'When I was young' -> 'When you were kid' (ejemplo de edición de la letra) */} + - edit lyrics: 'When I was young' -> 'When you were kid' (ejemplo de edición de la letra) */} -### Letras +### Letra #### Etiquetas de estructura de la letra @@ -158,9 +160,9 @@ Usa algunos términos habituales del mundo de la música para controlar con prec #### Soporte multilingüe -- ACE-Step V1 admite varios idiomas. Al usarlo, ACE-Step convierte los distintos idiomas a letras del alfabeto inglés y luego genera la música. -- En ComfyUI, todavía no hemos implementado por completo la conversión de todos los idiomas a letras del alfabeto inglés. Por ahora, solo están implementados los [caracteres japoneses hiragana y katakana](https://github.com/Comfy-Org/ComfyUI/commit/5d3cc85e13833aeb6ef9242cdae243083e30c6fc). -Así que, si necesitas usar varios idiomas para generar música, primero debes convertir el idioma correspondiente a letras del alfabeto inglés y luego escribir la abreviatura del código de idioma al comienzo de `lyrics`, como el chino `[zh]`, el coreano `[ko]`, etc. +- ACE-Step V1 admite varios idiomas. Al usarlo, ACE-Step convierte los distintos idiomas a letras del alfabeto inglés y después genera la música. +- En ComfyUI no hemos implementado por completo la conversión de todos los idiomas a letras del alfabeto inglés. Actualmente solo están implementados los [caracteres japoneses hiragana y katakana](https://github.com/Comfy-Org/ComfyUI/commit/5d3cc85e13833aeb6ef9242cdae243083e30c6fc). +Así que si necesitas usar varios idiomas para generar música, primero debes convertir el idioma correspondiente a letras del alfabeto inglés y luego introducir la abreviatura del código de idioma al principio de `lyrics`, por ejemplo chino `[zh]`, coreano `[ko]`, etc. Por ejemplo: @@ -193,7 +195,7 @@ Por ejemplo: [fr]un amour profond qui ne s'éloignera jamais ``` -Actualmente, ACE-Step admite 19 idiomas, pero los siguientes diez tienen mejor soporte: +Actualmente, ACE-Step admite 19 idiomas, pero los diez siguientes tienen mejor soporte: - Inglés - Chino: [zh] - Ruso: [ru] diff --git a/es/tutorials/audio/minimax/minimax-music-3.mdx b/es/tutorials/audio/minimax/minimax-music-3.mdx index e073e34608..40e0a6f30d 100644 --- a/es/tutorials/audio/minimax/minimax-music-3.mdx +++ b/es/tutorials/audio/minimax/minimax-music-3.mdx @@ -2,19 +2,21 @@ title: "MiniMax Music 3 en ComfyUI: generación de música con IA" description: "Aprende a usar MiniMax Music 3 en ComfyUI para generar canciones completas de hasta 5 minutos a partir de un caption musical estructurado y una letra." sidebarTitle: "MiniMax Music 3" -translationSourceHash: dd9d217b +translationSourceHash: 02b650c1 translationFrom: tutorials/audio/minimax/minimax-music-3.mdx translationBlockHashes: "_intro": 883223ea "Key features": 7a913ea4 "Getting started": e1d3e891 + "MiniMax Music 3 Text to Music workflow": 822050b7 "Output": a0e21d03 --- + import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"; -[MiniMax Music 3](https://github.com/MiniMax-AI/MiniMax-Music3) es el modelo de generación musical de MiniMax para crear canciones completas de hasta **cinco minutos** de duración. Condicionado por una letra y una descripción musical detallada, produce canciones estructuralmente coherentes con voces expresivas, arreglos que evolucionan y una calidad de audio estable en formatos largos. Puedes explorar ejemplos generados en la [página de demostración oficial](https://minimax-ai.github.io/music3-demo/).
+[MiniMax Music 3](https://github.com/MiniMax-AI/MiniMax-Music3) es el modelo de generación musical de MiniMax para crear canciones completas de hasta **cinco minutos** de duración. Condicionado por una letra y una descripción musical detallada, produce canciones estructuralmente coherentes con voces expresivas, arreglos que evolucionan y una calidad de audio estable en piezas largas. Puedes explorar ejemplos generados en la [página de demostración oficial](https://minimax-ai.github.io/music3-demo/).
MiniMax Music 3 utiliza una arquitectura autoregresiva jerárquica con un LLM global de 8B para la estructura musical de largo alcance, un LLM local de 0.6B para el detalle acústico a nivel de fotograma y un sistema de síntesis de estados ocultos continuos basado en Flow Matching y un Flow-VAE. Genera audio estéreo de 32 kHz y 16 bits. Los pesos del modelo están disponibles bajo la [Licencia Comunitaria de MiniMax-Music3](https://huggingface.co/MiniMaxAI/MiniMax-Music3/blob/main/LICENSE).
@@ -30,7 +32,7 @@ La [Licencia Comunitaria](https://huggingface.co/MiniMaxAI/MiniMax-Music3/blob/m
- **Canciones completas**: Genera pistas completas de hasta 5 minutos con intro, verso, preestribillo, estribillo, puente, interludio instrumental y outro
- **Control de dos entradas**: Una **Caption** estructurada define el estilo musical, el estado de ánimo, las voces y el arreglo, mientras que **Lyrics**, con etiquetas de sección (`[Intro]`, `[Verse]`, `[Chorus]`, `[Bridge]`, `[Instrumental]`, `[Outro]`), controla la estructura de la canción
- **Coherencia de largo alcance**: Mantiene los temas musicales, el ritmo, la identidad vocal y la progresión del arreglo a lo largo de secuencias largas
-- **Voces expresivas**: Síntesis vocal natural con control sobre la melodía, la pronunciación y las armonías superpuestas
+- **Voces expresivas**: Síntesis vocal natural con control sobre la melodía, la pronunciación y las armonías por capas
- **Pesos abiertos**: Ejecútalo localmente en ComfyUI con control total sobre cada parámetro
## Primeros pasos
@@ -39,13 +41,13 @@ MiniMax Music 3 es compatible con ComfyUI con pesos abiertos. Para empezar:
1. Actualiza ComfyUI a la última versión
2. Ve a **Biblioteca de plantillas** > **Audio** > elige el flujo de trabajo **MiniMax Music 3**
-3. Sigue la ventana emergente para descargar los modelos y ejecutar el flujo de trabajo
+3. Sigue las indicaciones de la ventana emergente para descargar los modelos y ejecutar el flujo de trabajo
Los archivos de modelo listos para ComfyUI (modelo de difusión reempaquetado, text encoder y VAE) están alojados en Hugging Face en el repositorio [Comfy-Org/MiniMax-Music-3](https://huggingface.co/Comfy-Org/MiniMax-Music-3). Los pesos originales del modelo están disponibles en el repositorio [MiniMaxAI/MiniMax-Music3](https://huggingface.co/MiniMaxAI/MiniMax-Music3).
## Flujo de trabajo de texto a música de MiniMax Music 3
-Genera una canción completa a partir de un caption musical estructurado y una letra.
+Genera una canción completa a partir de una descripción musical estructurada y una letra.
 @@ -54,21 +56,21 @@ Genera una canción completa a partir de un caption musical estructurado y una l
Abrir en Comfy Cloud
 +
 +
 +
 -
 +
 +
 -### 1. Flujo de trabajo y recurso de outpainting
+### 1. Flujo de trabajo de outpainting y recursos
### 2. Pasos para ejecutar el flujo de trabajo
-
+
1. Asegúrate de que el nodo `Load Diffusion Model` tenga cargado `flux1-fill-dev.safetensors`.
2. Asegúrate de que el nodo `DualCLIPLoader` tenga cargados los siguientes modelos:
diff --git a/es/tutorials/flux/flux-1-kontext-dev.mdx b/es/tutorials/flux/flux-1-kontext-dev.mdx
index c196d2edc8..d9952f2eaf 100644
--- a/es/tutorials/flux/flux-1-kontext-dev.mdx
+++ b/es/tutorials/flux/flux-1-kontext-dev.mdx
@@ -2,15 +2,17 @@
title: "FLUX.1 Kontext Dev en ComfyUI: edición de imágenes en local"
description: "Edita imágenes en local en ComfyUI con FLUX.1 Kontext Dev, el modelo de 12B de Black Forest Labs para ediciones consistentes, estilo y refinado iterativo."
sidebarTitle: "FLUX.1 Kontext Dev"
-translationSourceHash: 391031ed
+translationSourceHash: 6b87ee9a
translationFrom: tutorials/flux/flux-1-kontext-dev.mdx
translationBlockHashes:
"_intro": 51c48128
"About FLUX.1 Kontext Dev": bb2f00f7
+ "Model Download": e6b40970
"FLUX.1 Kontext Dev Workflow": 8408eb0d
---
+
import PromptTechniques from "/snippets/es/tutorials/flux/prompt-techniques.mdx";
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
## Descarga de modelos
-Para ejecutar correctamente los flujos de trabajo de esta guía, primero necesitas descargar los siguientes archivos de modelo. También puedes obtener directamente los enlaces de descarga de los modelos desde los flujos de trabajo correspondientes, que ya incluyen la información de descarga de los archivos de modelo.
+Para ejecutar los flujos de trabajo de esta guía correctamente, primero necesitas descargar los siguientes archivos de modelo. También puedes obtener directamente los enlaces de descarga de los modelos desde los flujos de trabajo correspondientes, que ya incluyen la información de descarga de los archivos de modelo.
**Modelo de difusión**
- [flux1-dev-kontext_fp8_scaled.safetensors](https://huggingface.co/Comfy-Org/flux1-kontext-dev_ComfyUI/blob/main/split_files/diffusion_models/flux1-dev-kontext_fp8_scaled.safetensors)
 +
 -**Salida de ejemplo**
+**Ejemplo de salida**
-
 +
 +
 +
 @@ -50,16 +52,16 @@ Genera una imagen solo a partir de un prompt, sin archivos de entrada. El flujo
 +
 @@ -110,22 +112,22 @@ Sube este archivo al nodo `LoadImage` correspondiente:
1. Carga tu imagen fuente en el nodo `LoadImage`
2. Conéctala a `Set Reference Multi Latent`. La primera referencia es `
 -
 +
 +
 +
 @@ -110,9 +113,9 @@ Genera imágenes a partir de prompts de texto con el modelo turbo ERNIE-Image. I
**Salida de ejemplo**
-
+
-### Descargas de modelos de ERNIE-Image-Turbo
+### Descargas del modelo ERNIE-Image-Turbo
 +
 @@ -157,7 +159,7 @@ Genera imágenes con el modelo Krea-2 Turbo tomando como referencia el estilo de
Abrir en Comfy Cloud
 +
 @@ -143,13 +145,13 @@ Qwen-Image-Edit-2509 es la siguiente iteración de Qwen-Image-Edit. Mantiene la
Abrir en Comfy Cloud
 @@ -83,20 +85,19 @@ Sube este archivo al nodo `LoadImage` **74**:
│ └── 📂 vae/
│ └── qwen_image_layered_vae.safetensors
```
-
## Versión FP8
-De forma predeterminada usamos bf16, que requiere mucha VRAM. Si quieres reducir el uso de VRAM, puedes usar la versión fp8:
+Por defecto usamos bf16, que requiere mucha VRAM. Si necesitas un uso de VRAM menor, puedes usar la versión fp8:
- [qwen_image_layered_fp8mixed.safetensors](https://huggingface.co/Comfy-Org/Qwen-Image-Layered_ComfyUI/blob/main/split_files/diffusion_models/qwen_image_layered_fp8mixed.safetensors)
-Luego, actualiza el nodo **Cargar modelo de difusión** dentro del [Subgraph](/es/interface/features/subgraph) para usarla.
+Después, actualiza el nodo **Load Diffusion model** dentro del [Subgraph](/es/interface/features/subgraph) para usarla.
## Capas y salida
-El número de capas lo define el widget `layers` del nodo **Empty Qwen Image Layered Latent**, dentro del [Subgraph](/es/interface/features/subgraph).
+El número de capas lo define el widget `layers` del nodo **Latente Qwen Image en capas vacío**, dentro del [Subgraph](/es/interface/features/subgraph).
-Este modelo regenera la imagen completa además de las capas, así que una generación siempre se decodifica en `layers + 1` imágenes:
+Este modelo regenera la imagen completa además de las capas, así que una generación siempre decodifica `layers + 1` imágenes:
| `layers` | Imágenes decodificadas | Contenido |
| --- | --- | --- |
@@ -104,28 +105,28 @@ Este modelo regenera la imagen completa además de las capas, así que una gener
| `2` (valor predeterminado de la plantilla) | 3 | La imagen completa y luego 2 capas |
| `5` | 6 | La imagen completa y luego 5 capas |
-**La primera imagen es la imagen completa, no una capa.** El flujo de trabajo de imagen a capas la descarta automáticamente con un nodo `LatentCut` (`dim` `t`, `index` `1`) antes de la división del lote, de modo que la plantilla genera `layers` imágenes. Si construyes un gráfico personalizado sin ese nodo, descarta la primera imagen cuando solo quieras las capas. `layers` acepta `0`, lo que te da esa imagen por sí sola.
+**La primera imagen es la imagen completa, no una capa.** El flujo de trabajo de imagen a capas la descarta automáticamente con un nodo `Cortar latente` (`dim` `t`, `index` `1`) antes de la división del lote, por lo que la plantilla genera `layers` imágenes. Si construyes un gráfico personalizado sin ese nodo, descarta la primera imagen cuando solo quieras las capas. `layers` acepta `0`, lo que te da esa imagen por sí sola.
-**Si compones todas las capas de nuevo, vuelves a crear la imagen completa.** Úsalo como comprobación: si al apilar las capas no se reproduce la primera imagen, la descomposición no hizo lo que buscabas.
+**Recomponer todas las capas vuelve a crear la imagen completa.** Úsalo como comprobación: si al apilar las capas no se reproduce la primera imagen, la descomposición no hizo lo que querías.
-### Cómo se convierten las capas en imágenes separadas
+### Cómo las capas se convierten en imágenes separadas
-El nodo **Empty Qwen Image Layered Latent** asigna un latente 5D con forma `[batch_size, 16, layers + 1, height // 8, width // 8]`. Las capas ocupan el tercer eje, el mismo eje temporal que los modelos de video usan para los fotogramas. El nodo **LatentCutToBatch** con `dim` en `t` mueve ese eje a la dimensión del lote, así que después de **VAE Decode** cada capa es una imagen separada dentro del lote. La plantilla inserta un nodo `LatentCut` (`dim` `t`, `index` `1`) antes de `LatentCutToBatch` para descartar la entrada de la imagen completa, de modo que el lote decodificado solo contiene las capas.
+El nodo **Latente Qwen Image en capas vacío** asigna un latente 5D con forma `[batch_size, 16, layers + 1, height // 8, width // 8]`. Las capas ocupan el tercer eje, el mismo eje temporal que los modelos de video usan para los fotogramas. El nodo **Cortar latente a lote** con `dim` en `t` mueve ese eje a la dimensión del lote, de modo que después de la **Decodificación VAE** cada capa es una imagen separada dentro del lote. La plantilla inserta un nodo `Cortar latente` (`dim` `t`, `index` `1`) antes de **Cortar latente a lote** para descartar la entrada de la imagen completa, así que el lote decodificado contiene solo las capas.
-Por lo tanto, la posición de una capa en la pila es su índice en el lote, contando desde la imagen completa en el índice 0. No hay campo de z-index ni metadatos por capa que lleven ese orden, así que reordenar o filtrar el lote reordena las capas.
+La posición de una capa en la pila es, por lo tanto, su índice en el lote, contando desde la imagen completa en el índice 0. No existe un campo de z-index ni metadatos por capa que lleven ese orden, así que reordenar o filtrar el lote reordena las capas.
-El VAE de Qwen-Image-Layered decodifica a 4 canales, así que las capas decodificadas llevan un canal alfa.
+El VAE de Qwen-Image-Layered decodifica a 4 canales, por lo que las capas decodificadas llevan un canal alfa.
## Configuraciones del flujo de trabajo
### Configuraciones del sampler
-Este modelo es lento. Las configuraciones de muestreo originales son steps: 50 y CFG: 4.0, lo que al menos duplicará el tiempo de generación.
+Este modelo es lento. Las configuraciones de muestreo originales son steps: 50 y CFG: 4.0, lo que como mínimo duplica el tiempo de generación.
### Tamaño de entrada
-Para el tamaño de entrada, se recomienda 640px. Usa 1024px para una salida de alta resolución.
+Para el tamaño de entrada se recomienda 640px. Usa 1024px para una salida de alta resolución.
### Prompt (opcional)
-El prompt de texto está pensado para describir el contenido general de la imagen de entrada, incluidos los elementos que pueden estar parcialmente ocultos (por ejemplo, puedes especificar el texto que está detrás de un objeto en primer plano). No está diseñado para controlar explícitamente el contenido semántico de cada capa.
+El prompt de texto sirve para describir el contenido general de la imagen de entrada, incluidos los elementos que pueden estar parcialmente ocluidos (por ejemplo, puedes especificar el texto oculto detrás de un objeto en primer plano). No está diseñado para controlar de forma explícita el contenido semántico de cada capa.
diff --git a/es/tutorials/image/z-image/z-image-turbo.mdx b/es/tutorials/image/z-image/z-image-turbo.mdx
index 0d0a554811..6a80d5c559 100644
--- a/es/tutorials/image/z-image/z-image-turbo.mdx
+++ b/es/tutorials/image/z-image/z-image-turbo.mdx
@@ -2,21 +2,24 @@
title: "Z-Image-Turbo en ComfyUI: texto a imagen en 8 pasos"
description: "Un modelo destilado de texto a imagen de 6B que renderiza en 8 pasos con 16GB de VRAM, con renderizado preciso de texto en chino e inglés en ComfyUI."
sidebarTitle: "Z-Image-Turbo"
-translationSourceHash: 3ba96151
+translationSourceHash: 33113227
translationFrom: tutorials/image/z-image/z-image-turbo.mdx
translationBlockHashes:
"_intro": 7084d4ab
+ "Z-Image-Turbo text-to-image workflow": b88a686f
+ "Z-Image-Turbo Fun Union ControlNet workflow": abab6a04
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
**Z-Image (造相)** es un modelo de generación de imágenes potente y muy eficiente con **6B** parámetros, desarrollado por Tongyi Lab de Alibaba. Utiliza una arquitectura **Scalable Single-Stream DiT** (S3-DiT) en la que los tokens de texto, los tokens semánticos visuales y los tokens del VAE de imagen se concatenan a nivel de secuencia para formar un único flujo de entrada, maximizando la eficiencia de los parámetros.
**Variantes del modelo**:
-- 🚀 **Z-Image-Turbo**: una versión destilada que iguala o supera a los principales competidores con solo **8 NFE** (Number of Function Evaluations). Ofrece una **latencia de inferencia inferior a un segundo** en GPUs H800 de clase empresarial y cabe en **dispositivos de consumo con 16 GB de VRAM**.
+- 🚀 **Z-Image-Turbo**: una versión destilada que iguala o supera a los principales competidores con solo **8 NFE** (Number of Function Evaluations). Ofrece una **latencia de inferencia inferior a un segundo** en GPUs H800 de clase empresarial y cabe en **dispositivos de consumo con 16GB de VRAM**.
- 🧱 **Z-Image-Base**: el modelo base sin destilar, pensado para el ajuste fino impulsado por la comunidad y el desarrollo personalizado.
-- ✍️ **Z-Image-Edit**: una variante ajustada para tareas de edición de imágenes, con una capacidad notable para seguir instrucciones.
+- ✍️ **Z-Image-Edit**: una variante ajustada para tareas de edición de imágenes, con una notable capacidad para seguir instrucciones.
**Aspectos destacados del modelo**:
- **Calidad fotorrealista**: ofrece una sólida generación de imágenes fotorrealistas sin perder una excelente calidad estética
@@ -30,28 +33,28 @@ import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
 +
 +
 @@ -55,14 +57,14 @@ La base para la libertad creativa. Estética diversa con una calidad fotorrealis
Codificador de texto para Z-Image.
 @@ -71,36 +73,36 @@ Este flujo de trabajo demuestra las capacidades principales de **generación de
- **Prompt de texto**: tu pregunta o instrucción
- **Imagen** (opcional): para tareas de comprensión visual (OCR, detección de objetos, lectura de gráficos, etc.)
- **Audio** (opcional): para reconocimiento de voz o transcripción
-- **Video** (opcional): la plantilla carga el video y lo divide con **Get Video Components**, pero esos fotogramas no están conectados al generador de texto, así que el video no afecta a la salida
+- **Video** (opcional): la plantilla carga el video y lo divide con **Obtener componentes de video**, pero esos fotogramas no están conectados al generador de texto, así que el video no afecta la salida
**Controles principales**:
- **Longitud máxima**: número máximo de tokens a generar (256 por defecto)
- **Modo de muestreo**: activa o desactiva el muestreo y ajusta temperatura, top-k, top-p, penalización por repetición y semilla
-- **Modo de razonamiento**: activa el razonamiento paso a paso antes de la respuesta final
+- **Modo de pensamiento**: activa el razonamiento paso a paso antes de la respuesta final
- **Usar plantilla predeterminada**: aplica el prompt de sistema integrado del modelo
**Salida**:
- **Texto generado**: la respuesta del modelo como una cadena de texto sin formato
 +
-  +
Este flujo de trabajo demuestra las capacidades de **generación de texto y comprensión de imágenes** de Qwen3.5. Acepta un prompt de texto y una imagen opcional, y genera texto descriptivo o análisis estructurado a partir de la entrada.
**Entradas**:
- **Prompt de texto**: tu pregunta, instrucción o descripción de la tarea
-- **Imagen** (opcional): para tareas de comprensión visual (captioning de imágenes, ingeniería inversa de prompts, optimización de prompts, etc.)
+- **Imagen** (opcional): para tareas de comprensión visual (descripción de imágenes, ingeniería inversa de prompts, optimización de prompts, etc.)
**Controles clave**:
- **Max length**: número máximo de tokens a generar (256 por defecto)
-- **Sampling mode**: activa o desactiva el muestreo y ajusta temperature, top-k, top-p, repetition penalty y seed
-- **Use default template**: aplica el system prompt integrado del modelo
+- **Sampling mode**: activa o desactiva el muestreo y ajusta temperature, top-k, top-p, repetition penalty y semilla
+- **Use default template**: aplica el prompt de sistema integrado del modelo
**Salida**:
- **Texto generado**: la respuesta del modelo como una cadena de texto plano
-
+
 +
+
 +
+
+
+
+ Descargar imagen de entrada de ejemplo
+
+
+
+
+## Empezar
+
+1. Actualiza ComfyUI a la versión 0.37.3 o posterior
+2. Ve a Template Library y busca `Seedream 5.0 Flash`
diff --git a/es/tutorials/partner-nodes/bytedance/seedream-5-pro.mdx b/es/tutorials/partner-nodes/bytedance/seedream-5-pro.mdx
index b5022f3620..3dc5b5947f 100644
--- a/es/tutorials/partner-nodes/bytedance/seedream-5-pro.mdx
+++ b/es/tutorials/partner-nodes/bytedance/seedream-5-pro.mdx
@@ -2,7 +2,7 @@
title: "ByteDance Seedream 5.0 Pro - Generación profesional de imágenes con IA"
description: "Genera imágenes de alta calidad con mejor seguimiento de instrucciones, edición precisa y resultados profesionales con Seedream 5.0 Pro en ComfyUI"
sidebarTitle: "Seedream 5 Pro"
-translationSourceHash: 2ea701f2
+translationSourceHash: 1a800b2f
translationFrom: tutorials/partner-nodes/bytedance/seedream-5-pro.mdx
translationBlockHashes:
"_intro": 7da8abcf
@@ -10,9 +10,10 @@ translationBlockHashes:
"Example outputs": 8e9ad94f
"Seedream 5.0 Pro text-to-image workflow": 87df7263
"Seedream 5.0 Pro image edit workflow": faaa6452
- "Seedream 5.0 Pro layer separation workflow": a6084e3e
+ "Seedream 5.0 Pro layer separation workflow": 245a59fb
"Get started": 709ac7fd
---
+
import ReqHint from "/snippets/es/tutorials/partner-nodes/req-hint.mdx";
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
@@ -94,7 +95,7 @@ Descarga esta imagen de entrada de ejemplo para probar el flujo de trabajo:
## Flujo de trabajo de separación de capas de Seedream 5.0 Pro
-La separación de capas es el pilar de descomposición por capas de la edición interactiva de precisión de Seedream 5.0 Pro. Divide una sola imagen plana en una pila editable: una imagen base (placa de fondo) más hasta 16 capas transparentes independientes, cada una con su orden de apilamiento, coordenadas de caja delimitadora, nombre y descripción semántica. El modelo rellena mediante inpainting las regiones ocultas detrás de los sujetos extraídos, de modo que cada capa y la base que queda debajo es un recurso de diseño completo e independiente, listo para arrastrar, escalar y recomponer.
+La separación de capas es el pilar de descomposición por capas de la edición interactiva de precisión de Seedream 5.0 Pro. Divide una sola imagen plana en una pila editable: una imagen base (placa de fondo) más hasta 16 capas transparentes independientes, cada una con su orden de apilamiento, coordenadas de caja delimitadora, nombre y descripción semántica. Las regiones ocultas detrás de los sujetos extraídos se rellenan con inpainting de forma imperceptible, así que cada capa y la base que queda debajo es un recurso de diseño completo e independiente, listo para arrastrar, escalar y recomponer.
Sin ningún prompt, el modelo identifica automáticamente todos los elementos principales: bloques de texto, sujetos, decoraciones y fondo. Un solo póster puede generar más de 10 capas, con una separación de texto de calidad de diseño que admite titulares multilingües y fuentes CJK. También puedes describir los elementos en lenguaje natural para controlar la separación, o apuntar a regiones exactas con etiquetas de caja delimitadora. Este flujo de trabajo es ideal para diseño de marca, creación de recursos de comercio electrónico, iteración de pósters y cualquier tarea en la que un mapa de bits plano deba convertirse en un documento por capas editable. La plantilla incluye el modelo **Seedream 5.0 Flash** seleccionado. Cambia el modelo en el nodo a `seedream 5.0 pro` para ejecutar la separación con Seedream 5.0 Pro.
diff --git a/es/tutorials/partner-nodes/fishaudio/drama-3.mdx b/es/tutorials/partner-nodes/fishaudio/drama-3.mdx
index 2ba7ea514b..dd560fdbfd 100644
--- a/es/tutorials/partner-nodes/fishaudio/drama-3.mdx
+++ b/es/tutorials/partner-nodes/fishaudio/drama-3.mdx
@@ -90,7 +90,7 @@ She looked at the menu and said Materiales de entrada
+ +Descarga esta imagen de entrada de ejemplo para probar el flujo de trabajo: + + +
 -## Completar la ejecución del flujo de trabajo paso a paso
+## Completa la ejecución del flujo de trabajo paso a paso

@@ -73,11 +75,11 @@ En la plantilla correspondiente, hemos creado un prompt para analizar y generar
Puedes guiarte por los números de la imagen para completar la ejecución básica del flujo de trabajo de texto a imagen:
1. En el nodo `Load Image`, carga la imagen que necesitas que la IA interprete
-2. (Opcional) Si es necesario, puedes modificar el prompt en `Google Gemini` para que la IA ejecute tareas específicas
-3. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la conversación.
+2. (Opcional) Si lo necesitas, puedes modificar el prompt en `Google Gemini` para que la IA ejecute tareas específicas
+3. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la conversación.
4. Después de esperar a que la API devuelva los resultados, puedes ver el contenido correspondiente devuelto por la IA en el nodo `Preview Any`.
## Notas adicionales
-- Actualmente, el nodo de entrada de archivos `Gemini Input Files` requiere que primero cargues los archivos en el directorio `ComfyUI/input/`. Este nodo está en proceso de mejora y modificaremos la plantilla después de las actualizaciones
-- El flujo de trabajo incluye un ejemplo que usa `Batch Images` como entrada. Si tienes varias imágenes que necesitan interpretación de la IA, puedes consultar el diagrama de pasos y usar el clic derecho para establecer el modo del nodo correspondiente en `Always` y habilitarlo
+- Actualmente, el nodo de entrada de archivos `Gemini Input Files` requiere que primero cargues los archivos en el directorio `ComfyUI/input/`. Este nodo se está mejorando y modificaremos la plantilla después de las actualizaciones.
+- El flujo de trabajo incluye un ejemplo que usa `Batch Images` como entrada. Si tienes varias imágenes que necesitan la interpretación de la IA, puedes consultar el diagrama de pasos y usar el clic derecho para establecer el modo del nodo correspondiente en `Always` y habilitarlo.
diff --git a/es/tutorials/partner-nodes/ideogram/ideogram-v3.mdx b/es/tutorials/partner-nodes/ideogram/ideogram-v3.mdx
new file mode 100644
index 0000000000..c4f94d033b
--- /dev/null
+++ b/es/tutorials/partner-nodes/ideogram/ideogram-v3.mdx
@@ -0,0 +1,53 @@
+---
+title: "Ideogram 3.0 en ComfyUI: texto a imagen y edición de imágenes"
+description: "Ejecuta Ideogram 3.0 con los Nodos asociados de ComfyUI: genera imágenes fotorrealistas con texto preciso o edita un área enmascarada desde un prompt."
+sidebarTitle: "Ideogram 3.0"
+translationSourceHash: 452067eb
+translationFrom: tutorials/partner-nodes/ideogram/ideogram-v3.mdx
+---
+
+import ReqHint from "/snippets/es/tutorials/partner-nodes/req-hint.mdx";
+import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
+
+Ideogram 3.0 es un potente modelo de texto a imagen de Ideogram, conocido por su calidad fotorrealista, su representación precisa del texto y su control de estilo constante.
+
+El nodo Ideogram V3 actualmente admite dos modos:
+- Modo texto a imagen
+- Modo edición de imágenes (cuando proporcionas las entradas de imagen y máscara)
+
+
 +
 @@ -102,7 +103,7 @@ Sube un video para generar una secuencia de profundidad por fotograma. Dentro de
Abrir en Comfy Cloud
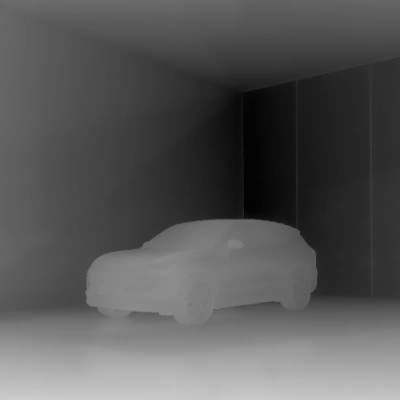 @@ -59,7 +63,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
### 1. Pasos para ejecutar
1. Carga tu imagen de entrada en el nodo `LoadImage`
-2. Encola el flujo de trabajo: el modelo base se ejecuta con la LoRA de profundidad y el nodo Marigold V2 Post-Process normaliza la predicción decodificada
+2. Pon en cola el flujo de trabajo: el modelo base se ejecuta con el LoRA de profundidad y el nodo Posprocesado de Marigold V2 normaliza la predicción decodificada
3. Guarda o previsualiza el mapa de profundidad resultante
### 2. Descargas de modelos
@@ -71,7 +75,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
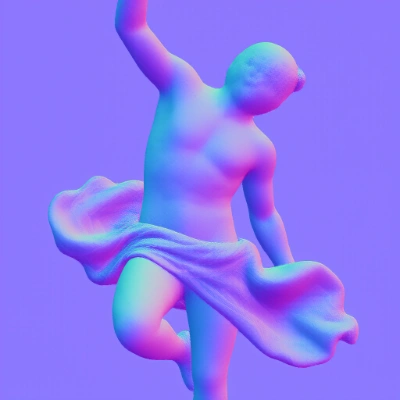 @@ -115,7 +118,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
### 1. Pasos para ejecutar
1. Carga tu imagen de entrada en el nodo `LoadImage`
-2. Encola el flujo de trabajo con la LoRA de normales cargada
+2. Encola el flujo de trabajo con el LoRA de normales cargado
3. Guarda o previsualiza el mapa de normales resultante
### 2. Descargas de modelos
@@ -127,7 +130,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
 @@ -171,7 +173,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
### 1. Pasos para ejecutar
1. Carga tu imagen de entrada en el nodo `LoadImage`
-2. Encola el flujo de trabajo con la LoRA de albedo cargada
+2. Pon el flujo de trabajo en cola con el LoRA de albedo cargado
3. Guarda o previsualiza la imagen de albedo resultante
### 2. Descargas de modelos
@@ -183,7 +185,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
 +
 -### SDPose: Video Multi-Person Detection {#utility_sdpose_multi_person_video}
+### SDPose: detección de varias personas en video {#utility_sdpose_multi_person_video}
-Sube un video para detectar poses humanas. Admite la detección de una sola persona y de varias personas en la misma escena.
+Sube un video para detectar poses humanas. Admite la detección tanto de una sola persona como de varias personas dentro de la misma escena.
-
 +
 +
 -
 +
 +
 +
 +
 -
 +
 +
 +
 +
ComfyUI/models/text_encoders/
+ qwen_2.5_vl_7b_fp8_scaled.safetensors: guárdalo en ComfyUI/models/text_encoders/
ComfyUI/models/text_encoders/
+ byt5_small_glyphxl_fp16.safetensors: guárdalo en ComfyUI/models/text_encoders/
ComfyUI/models/vae/
+ hunyuanvideo15_vae_fp16.safetensors: guárdalo en ComfyUI/models/vae/
ComfyUI/models/diffusion_models/
+ hunyuanvideo1.5_720p_t2v_fp16.safetensors — guarda el archivo en ComfyUI/models/diffusion_models/
ComfyUI/models/clip_vision/
+ sigclip_vision_patch14_384.safetensors: guárdalo en ComfyUI/models/clip_vision/
ComfyUI/models/diffusion_models/
+ hunyuanvideo1.5_720p_i2v_fp16.safetensors: guárdalo en ComfyUI/models/diffusion_models/
ComfyUI/models/diffusion_models/
+ hunyuanvideo1.5_1080p_sr_distilled_fp16.safetensors: guárdalo en ComfyUI/models/diffusion_models/
@@ -141,10 +143,10 @@ Actualmente, el modelo Hunyuan Image-to-Video tiene dos versiones:
### Modelo compartido para las versiones v1 y v2
- Guardar en ComfyUI/models/clip_vision
+ Guarda en ComfyUI/models/clip_vision
-### Flujo de trabajo imagen a video V1 "concat"
+### Flujo de trabajo de imagen a video V1 "concat"
#### 1. Flujo de trabajo y recursos
@@ -161,9 +163,9 @@ Descarga la imagen del flujo de trabajo que aparece a continuación y arrástral
Descarga la imagen a continuación y úsala como fotograma inicial para la generación de imagen a video:
- Guárdala y úsala como imagen de entrada para la generación I2V
+ Guarda y usa como imagen de entrada para la generación I2V
-#### 2. Instalación manual de los modelos relacionados
+#### 2. Instalación manual de modelos relacionados
Guarda en ComfyUI/models/diffusion_models
@@ -181,12 +183,12 @@ ComfyUI/
│ ├── vae/
│ │ └── hunyuan_video_vae_bf16.safetensors // Modelo compartido
│ └── diffusion_models/
-│ └── hunyuan_video_image_to_video_720p_bf16.safetensors // Modelo de la versión I2V v1 "concat"
+│ └── hunyuan_video_image_to_video_720p_bf16.safetensors // Modelo de la versión "concat" de I2V v1
```
#### 3. Pasos para ejecutar el flujo de trabajo
-
+
1. Asegúrate de que `DualCLIPLoader` haya cargado estos modelos:
- clip_name1: clip_l.safetensors
@@ -199,13 +201,13 @@ ComfyUI/
### Flujo de trabajo de imagen a video v2 "replace"
-El flujo de trabajo v2 es esencialmente el mismo que el del v1. Solo necesitas descargar el modelo **replace** y usarlo en el nodo `Load Diffusion Model`.
+El flujo de trabajo v2 es esencialmente igual al flujo de trabajo v1. Solo necesitas descargar el modelo **replace** y usarlo en el nodo `Load Diffusion Model`.
#### 1. Flujo de trabajo y recursos
-Descarga la imagen del flujo de trabajo de abajo y arrástrala a ComfyUI para cargarlo:
+Descarga la imagen del flujo de trabajo que aparece a continuación y arrástrala a ComfyUI para cargar el flujo de trabajo:
-
+
@@ -213,12 +215,12 @@ Descarga la imagen del flujo de trabajo de abajo y arrástrala a ComfyUI para ca
-Descarga la imagen de abajo y úsala como fotograma inicial para la generación de imagen a video:
+Descarga la imagen que aparece a continuación y úsala como fotograma inicial para la generación de imagen a video:
- Guarda y usa como imagen de entrada para la generación I2V
+ Guárdala y úsala como imagen de entrada para la generación de I2V
-#### 2. Instalación manual de modelos relacionados
+#### 2. Instalación manual de los modelos relacionados
Guárdalo en ComfyUI/models/diffusion_models
@@ -241,22 +243,22 @@ ComfyUI/
#### 3. Pasos para ejecutar el flujo de trabajo
-
+
-1. Asegúrate de que el nodo `DualCLIPLoader` haya cargado estos modelos:
+1. Asegúrate de que el nodo `DualCLIPLoader` tenga cargados estos modelos:
- clip_name1: clip_l.safetensors
- clip_name2: llava_llama3_fp8_scaled.safetensors
-2. Asegúrate de que el nodo `Load CLIP Vision` haya cargado `llava_llama3_vision.safetensors`
-3. Asegúrate de que el nodo `Load Image Model` haya cargado `hunyuan_video_image_to_video_720p_bf16.safetensors`
-4. Asegúrate de que el nodo `Load VAE` haya cargado `hunyuan_video_vae_bf16.safetensors`
-5. Asegúrate de que el nodo `Load Diffusion Model` haya cargado `hunyuan_video_v2_replace_image_to_video_720p_bf16.safetensors`
+2. Asegúrate de que el nodo `Load CLIP Vision` tenga cargado `llava_llama3_vision.safetensors`
+3. Asegúrate de que el nodo `Load Image Model` tenga cargado `hunyuan_video_image_to_video_720p_bf16.safetensors`
+4. Asegúrate de que el nodo `Load VAE` tenga cargado `hunyuan_video_vae_bf16.safetensors`
+5. Asegúrate de que el nodo `Load Diffusion Model` tenga cargado `hunyuan_video_v2_replace_image_to_video_720p_bf16.safetensors`
6. Haz clic en el botón `Queue` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar el flujo de trabajo
## Pruébalo tú mismo
Aquí tienes algunas imágenes y prompts que proporcionamos. Úsalos tal cual o ajústalos para crear tu propio video.
-
+
```
Futuristic robot dancing ballet, dynamic motion, fast motion, fast shot, moving scene
@@ -264,7 +266,7 @@ Futuristic robot dancing ballet, dynamic motion, fast motion, fast shot, moving
---
-
+
```
Samurai waving sword and hitting the camera. camera angle movement, zoom in, fast scene, super fast, dynamic
@@ -272,7 +274,7 @@ Samurai waving sword and hitting the camera. camera angle movement, zoom in, fas
---
-
+
```
flying car fastly moving and flying through the city
@@ -280,7 +282,7 @@ flying car fastly moving and flying through the city
---
-
+
```
cyberpunk car race in night city, dynamic, super fast, fast shot
diff --git a/es/tutorials/video/kandinsky/kandinsky-5.mdx b/es/tutorials/video/kandinsky/kandinsky-5.mdx
index 0c36c06627..ebadca8656 100644
--- a/es/tutorials/video/kandinsky/kandinsky-5.mdx
+++ b/es/tutorials/video/kandinsky/kandinsky-5.mdx
@@ -2,33 +2,36 @@
title: "Kandinsky 5.0 en ComfyUI: texto a video e imagen a video"
description: "Usa Kandinsky 5.0 Video Lite en ComfyUI: texto a video de hasta 10 segundos e imagen a video de 5 segundos, con variantes SFT de 2B, no-CFG y destilada."
sidebarTitle: "Kandinsky 5.0"
-translationSourceHash: 0766e01c
+translationSourceHash: e0a46d75
translationFrom: tutorials/video/kandinsky/kandinsky-5.mdx
translationBlockHashes:
"_intro": cd71d0f9
"Overview": dead89b1
"Model variants": 3bdbc0cb
+ "Text-to-Video workflow": 8641d2fb
+ "Image-to-Video workflow": b945bc9a
"Resources": fa8f3352
---
+
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
-[Kandinsky 5.0](https://huggingface.co/kandinskylab/Kandinsky-5.0-I2V-Lite-5s) es una familia de modelos de difusión para la generación de video e imágenes desarrollada por [Kandinsky Lab](https://huggingface.co/kandinskylab). Kandinsky 5.0 T2V Lite es un modelo ligero de 2B parámetros que se ubica entre los mejores modelos de generación de video de código abierto, capaz de generar videos de hasta 10 segundos de duración.
+[Kandinsky 5.0](https://huggingface.co/kandinskylab/Kandinsky-5.0-I2V-Lite-5s) es una familia de modelos de difusión para la generación de video e imágenes, desarrollada por [Kandinsky Lab](https://huggingface.co/kandinskylab). Kandinsky 5.0 T2V Lite es un modelo ligero de 2B de parámetros que figura entre los mejores modelos de generación de video de código abierto y es capaz de generar videos de hasta 10 segundos de duración.
 +
@@ -63,18 +66,18 @@ Un modelo ligero de 2B que genera videos a partir de prompts en inglés y ruso c
**Codificadores de texto**
-
+
Codificador de texto Qwen2.5-VL 7B (FP8). Colócalo en
-
+
Codificador de texto CLIP-L. Colócalo en
**Modelo de difusión**
-
- Modelo de difusión Kandinsky 5.0 T2V Lite SFT (5 s). Colócalo en
+ Modelo de difusión Kandinsky 5.0 T2V Lite SFT (5s). Colócalo en
**VAE**
@@ -99,7 +102,7 @@ ComfyUI/
Un modelo ligero de 2B que genera videos a partir de prompts en inglés y ruso con alta calidad visual.
- +
@@ -140,7 +143,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
**Modelo de difusión**
- Modelo de difusión Kandinsky 5.0 I2V Lite (5 s). Colócalo en
**VAE**
@@ -161,7 +164,7 @@ ComfyUI/
## Recursos
-- [Colección de modelos de Hugging Face](https://huggingface.co/collections/kandinskylab/kandinsky-50-video-lite)
+- [Colección de modelos de HuggingFace](https://huggingface.co/collections/kandinskylab/kandinsky-50-video-lite)
- [Repositorio de GitHub](https://github.com/ai-forever/Kandinsky-5)
- [Integración con ComfyUI](https://github.com/ai-forever/Kandinsky-5/blob/main/comfyui/README.md)
- [Página del proyecto](https://kandinskylab.github.io/kandinsky-5/)
diff --git a/es/tutorials/video/ltx/ltx-2-3.mdx b/es/tutorials/video/ltx/ltx-2-3.mdx
index 4d7e6dcbea..93be578611 100644
--- a/es/tutorials/video/ltx/ltx-2-3.mdx
+++ b/es/tutorials/video/ltx/ltx-2-3.mdx
@@ -2,18 +2,20 @@
title: "LTX-2.3 en ComfyUI: flujos de video y audio"
description: "Usa LTX-2.3 en ComfyUI con flujos nativos para texto a video, imagen a video, FLF2V, video controlado por audio, control IC-LoRA y personalización ID-LoRA."
sidebarTitle: "LTX-2.3"
-translationSourceHash: 0519dac5
+translationSourceHash: 2e21405a
translationFrom: tutorials/video/ltx/ltx-2-3.mdx
translationBlockHashes:
"_intro": 2afce33d
"Key features": 3ddea9bd
"Getting started": 8bd36b77
+ "ComfyUI Native Workflows": fb09a224
"Prompting tips": f92227b7
"Resources": 3f045765
---
+
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
-[LTX-2.3](https://huggingface.co/Lightricks/LTX-2.3) es la última evolución del modelo de generación de audio y video de código abierto de Lightricks, ahora compatible de forma nativa con ComfyUI. Sobre la base de LTX-2, esta versión ofrece mejoras importantes de calidad en detalles finos, video de retratos, calidad de audio, consistencia de imagen a video, comprensión de prompts y renderizado de texto.
+[LTX-2.3](https://huggingface.co/Lightricks/LTX-2.3) es la última evolución del modelo de generación de audio y video de código abierto de Lightricks, ahora compatible de forma nativa con ComfyUI. Tomando como base LTX-2, esta versión ofrece mejoras importantes de calidad en los detalles finos, el video de retrato, la calidad de audio, la consistencia de imagen a video, la comprensión de prompts y el renderizado de texto.
ComfyUI incluye seis flujos de trabajo nativos para LTX-2.3, cada uno diseñado para un modo de generación específico:
@@ -29,11 +31,11 @@ ComfyUI incluye seis flujos de trabajo nativos para LTX-2.3, cada uno diseñado
## Características clave
- **Detalles más finos**: nuevo espacio latente y VAE actualizado para texturas más nítidas, bordes más limpios y visuales más precisos
-- **Soporte para formato vertical 9:16**: calidad muy mejorada en videos verticales
-- **Mejor audio**: sonido más limpio con menos ruido y diálogos mejorados
+- **Soporte para 9:16 vertical**: calidad muy mejorada en videos en formato retrato
+- **Mejor audio**: sonido más limpio, con menos ruido y diálogos mejorados
- **Imagen a video mejorado**: movimiento más consistente y menos fallos
- **Comprensión de prompts más inteligente**: codificador de texto mejorado para una interpretación más precisa
-- **Soporte nativo en ComfyUI**: todos los flujos de trabajo son integrados, no se requieren Nodos personalizados
+- **Soporte nativo en ComfyUI**: todos los flujos de trabajo están integrados y no necesitas nodos personalizados
## Primeros pasos
@@ -41,21 +43,21 @@ LTX-2.3 es compatible de forma nativa con ComfyUI. Para empezar:
1. Actualiza ComfyUI a la última versión
2. Ve a **Biblioteca de plantillas** > **Video** > elige cualquier flujo de trabajo de LTX-2.3
-3. Sigue la ventana emergente para descargar los modelos y ejecutar el flujo de trabajo
+3. Sigue las indicaciones de la ventana emergente para descargar los modelos y ejecutar el flujo de trabajo
## Flujos de trabajo nativos de ComfyUI
### LTX-2.3 Texto a video (T2V)
-Genera videos a partir de prompts de texto con mejor comprensión de prompts y mejor renderizado de texto.
+Genera videos a partir de prompts de texto con una mejor comprensión de los prompts y renderizado de texto.
### LTX-2.3 Texto a video {#video_ltx2_3_t2v}
-Genera videos a partir de prompts de texto con mejor comprensión de prompts y mejor renderizado de texto.
+Genera videos a partir de prompts de texto con mejor comprensión de prompts y renderizado de texto.
- +
@@ -66,7 +68,7 @@ Genera videos a partir de prompts de texto con mejor comprensión de prompts y m
-#### Descarga de modelos
+#### Descargas de modelos
@@ -78,7 +80,7 @@ Genera videos a partir de prompts de texto con mejor comprensión de prompts y m
Colócalo en
-
+
Colócalo en
@@ -106,7 +108,7 @@ ComfyUI/
1. **Acciones principales**: Describe los eventos y las acciones tal como ocurren a lo largo del tiempo
2. **Detalles visuales**: Describe todos los detalles visuales que quieres que aparezcan en el video
-3. **Audio**: Describe los sonidos y el diálogo que necesita la escena
+3. **Audio**: Describe los sonidos y el diálogo necesarios para la escena
---
@@ -120,7 +122,7 @@ Genera videos a partir de una imagen de entrada con un movimiento más consisten
Genera videos a partir de una imagen de entrada con una consistencia de movimiento mejorada.
- +
@@ -137,9 +139,9 @@ Genera videos a partir de una imagen de entrada con una consistencia de movimien
-#### Descarga de modelos
+#### Descargas de modelos
-El flujo de trabajo I2V usa el mismo conjunto de modelos que el de texto a video.
+El flujo de trabajo I2V usa el mismo conjunto de modelos que texto a video.
@@ -151,7 +153,7 @@ El flujo de trabajo I2V usa el mismo conjunto de modelos que el de texto a video
Colócalo en
-
+
Colócalo en
@@ -179,22 +181,22 @@ ComfyUI/
### LTX-2.3 FLF2V
-Interpola entre una imagen inicial y una imagen final para generar una transición de video fluida.
+Interpola entre una imagen inicial y una imagen final para generar una transición de video suave.
-### LTX-2.3 Primer y último fotograma a video {#video_ltx2_3_flf2v}
+### LTX-2.3: convertir de primer y último fotograma a video {#video_ltx2_3_flf2v}
Interpola entre una imagen inicial y una final.
- +
Abrir en Comfy Cloud
- Descarga el JSON o busca "LTX-2.3 FLF2V" en la Biblioteca de plantillas
+ Descarga el JSON o busca "LTX-2.3 FLF2V" en la biblioteca de plantillas
@@ -207,15 +209,15 @@ Interpola entre una imagen inicial y una final.
-#### Descarga de modelos
+#### Descargas de modelos
-El flujo de trabajo FLF2V usa el checkpoint distilled en lugar del checkpoint dev.
+El flujo de trabajo FLF2V usa el checkpoint destilado en lugar del checkpoint dev.
Colócalo en
-
+
Colócalo en
@@ -231,23 +233,21 @@ ComfyUI/
│ └── gemma_3_12B_it_fp4_mixed.safetensors
```
----
-
### LTX-2.3 Imagen y audio a video (IA2V)
-Sube una imagen y un archivo de audio para generar un video de alta calidad con movimientos labiales sincronizados.
+Sube una imagen y un archivo de audio para generar un video de alta calidad con movimientos de labios sincronizados.
### LTX-2.3 Imagen y audio a video {#video_ltx2_3_ia2v}
-Genera videos con sincronización labial a partir de una imagen y audio.
+Genera videos con sincronización de labios a partir de una imagen y un audio.
- +
- Abrir en Comfy Cloud
+ Abre en Comfy Cloud
Descarga el JSON o busca "LTX-2.3 IA2V" en la Biblioteca de plantillas
@@ -259,29 +259,29 @@ Genera videos con sincronización labial a partir de una imagen y audio.
Imagen de referencia para el personaje que habla.
- Pista de audio para la sincronización labial.
+ Pista de audio para la sincronización de labios.
-#### Descarga de modelos
+#### Descargas de modelos
El flujo de trabajo IA2V usa el mismo conjunto de modelos que el de texto a video.
- Colócalo en
-
- Colócalo en
+ Coloca en
- Colócalo en
-
- Colócalo en
+ Coloca en
- Colócalo en
@@ -303,9 +303,9 @@ ComfyUI/
---
-### LTX-2.3 IC-LoRA Union Control
+### Control Union con IC-LoRA de LTX-2.3
-Genera videos con LTX-2.3 e IC-LoRA usando entradas de control alineadas como profundidad, pose o bordes. IC-LoRA es un LoRA in-context entrenado sobre LTX-2.3 que aplica la guía estructural de un video de referencia. Acepta señales de control de varios preprocesadores, incluidos mapas de profundidad, bordes de Canny y esqueletos de pose. Este flujo de trabajo usa un Subgraph para el procesamiento modular.
+Genera videos de LTX-2.3 con IC-LoRA usando entradas de control alineadas como profundidad, pose o bordes. IC-LoRA es un LoRA en contexto entrenado sobre LTX-2.3 que aplica orientación estructural a partir de un video de referencia. Acepta señales de control de varios preprocesadores, incluidos mapas de profundidad, bordes Canny y esqueletos de pose. Este flujo de trabajo usa un subgrafo para el procesamiento modular.
@@ -318,7 +318,7 @@ Genera videos con LTX-2.3 e IC-LoRA usando entradas de control alineadas como pr
-
+
Este flujo de trabajo usa un nodo Subgraph para el procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y ampliar el flujo de trabajo.
@@ -326,14 +326,14 @@ Genera videos con LTX-2.3 e IC-LoRA usando entradas de control alineadas como pr
- Video guía del que se extrae la señal de control.
+ Video guía para extraer la señal de control.
Imagen de referencia para el estilo y el contenido.
-#### Descarga de modelos
+#### Descargas de modelos
@@ -345,10 +345,10 @@ Genera videos con LTX-2.3 e IC-LoRA usando entradas de control alineadas como pr
Colócalo en
-
+
Colócalo en
-
+
Colócalo en
@@ -373,7 +373,7 @@ ComfyUI/
### Edición de video con IC-LoRA
-Los pesos IC-LoRA no se limitan al control de la generación. La Biblioteca de plantillas incluye flujos de trabajo IC-LoRA de LTX-2.3 ya preparados para editar material existente, y cada uno se ejecuta en Comfy Cloud o de forma local en ComfyUI. Los checkpoints IC-LoRA de la comunidad entrenados sobre LTX-2.3 (por ejemplo, la familia [LTX2.3-ICEdit-Insight](https://huggingface.co/joyfox/LTX2.3-ICEdit-Insight)) también son compatibles con el modelo nativo LTX-2.3.
+Los pesos IC-LoRA no se limitan al control de la generación. La Biblioteca de plantillas incluye flujos de trabajo LTX-2.3 IC-LoRA listos para editar material existente, y cada uno se ejecuta en Comfy Cloud o de forma local en ComfyUI. Los checkpoints IC-LoRA de la comunidad entrenados sobre LTX-2.3 (por ejemplo, la familia [LTX2.3-ICEdit-Insight](https://huggingface.co/joyfox/LTX2.3-ICEdit-Insight)) también son compatibles con el modelo nativo LTX-2.3.
#### Eliminar subtítulos de un video
@@ -393,18 +393,18 @@ Elimina subtítulos, rótulos, marcas de agua u otras superposiciones de texto d
-
- Descarga el video de entrada de ejemplo
+
+ Descargar video de entrada de muestra
#### Eliminar un objeto de un video
-Elimina un objeto concreto del primer plano de un video describiéndolo en el prompt:
+Elimina un objeto específico del primer plano de un video describiéndolo en el prompt:
 @@ -420,11 +420,11 @@ Elimina un objeto concreto del primer plano de un video describiéndolo en el pr
-
- Descarga el video de entrada de ejemplo
+
+ Descargar video de entrada de muestra
@@ -447,18 +447,18 @@ Restaura material de archivo antiguo o degradado:
-
- Descarga el video de entrada de ejemplo
+
+ Descargar video de entrada de muestra
#### Outpainting de video
-Amplía un video en cualquier dirección con el IC-LoRA Video Outpainting de LTX-2.3:
+Expande un video en cualquier dirección con el IC-LoRA Video Outpainting de LTX-2.3:
 @@ -474,18 +474,18 @@ Amplía un video en cualquier dirección con el IC-LoRA Video Outpainting de LTX
-
- Descarga el video de entrada de ejemplo
+
+ Descargar video de entrada de muestra
-#### Googly Eyes
+#### Ojos saltones
-Aplica el LoRA Googlyeyes de LTX-2.3 a un video de entrada para poner ojos saltones a todas las personas del fotograma:
+Aplica el LoRA Googlyeyes de LTX-2.3 a un video de entrada para darle ojos saltones a todos los que aparecen en el encuadre:
 @@ -494,7 +494,7 @@ Aplica el LoRA Googlyeyes de LTX-2.3 a un video de entrada para poner ojos salto
Abrir en Comfy Cloud
- Descarga el JSON o busca "Googly Eyes" en la Biblioteca de plantillas
+ Descargar JSON o buscar "Googly Eyes" en la biblioteca de plantillas
@@ -505,12 +505,12 @@ Descarga este video de entrada de ejemplo para probar el flujo de trabajo:
- Descarga el video de entrada de ejemplo
+ Descargar video de entrada de ejemplo
-Para los IC-LoRA de la comunidad, coloca el LoRA de edición en `ComfyUI/models/loras/` y cárgalo con un cargador de LoRA junto al checkpoint de LTX-2.3; después ejecuta el flujo de trabajo con tu video como entrada y un prompt como:
+Para los IC-LoRA de la comunidad, coloca el LoRA de edición en `ComfyUI/models/loras/` y cárgalo con un LoRA loader junto al checkpoint LTX-2.3; luego ejecuta el flujo de trabajo con tu video como entrada y un prompt como este:
```text
Remove subtitles, captions, and related text occlusions from the video, restoring a clean and natural underlying image.
@@ -528,7 +528,7 @@ Genera videos personalizados con audio sincronizado a partir de un prompt de tex
Genera videos personalizados con audio sincronizado a partir de una imagen de referencia y un clip de audio.
- +
@@ -548,7 +548,7 @@ Genera videos personalizados con audio sincronizado a partir de una imagen de re
-#### Descarga de modelos
+#### Descargas de modelos
@@ -560,7 +560,7 @@ Genera videos personalizados con audio sincronizado a partir de una imagen de re
Colócalo en
-
+
Colócalo en
@@ -584,12 +584,12 @@ ComfyUI/
│ └── ltx-2.3-spatial-upscaler-x2-1.1.safetensors
```
-## Consejos para escribir prompts
+## Consejos para los prompts
-Cuando escribas prompts para LTX-2.3, céntrate en descripciones detalladas y cronológicas de acciones y escenas:
+Cuando escribas prompts para LTX-2.3, enfócate en descripciones detalladas y cronológicas de las acciones y las escenas:
1. **Acciones principales**: Describe los eventos y las acciones tal como ocurren a lo largo del tiempo
-2. **Detalles visuales**: Describe todos los detalles visuales que quieres que aparezcan en el video
+2. **Detalles visuales**: Describe todos los detalles visuales que quieras que aparezcan en el video
3. **Audio**: Describe los sonidos y el diálogo que necesita la escena
## Recursos
diff --git a/es/tutorials/video/ltx/ltx-2-5-dfr.mdx b/es/tutorials/video/ltx/ltx-2-5-dfr.mdx
index 14cd89b24d..58c8025ffd 100644
--- a/es/tutorials/video/ltx/ltx-2-5-dfr.mdx
+++ b/es/tutorials/video/ltx/ltx-2-5-dfr.mdx
@@ -2,15 +2,17 @@
title: "LTX-2.5 DFR en ComfyUI: imagen a video con audio"
description: "Ejecuta el flujo de trabajo LTX-2.5 DFR en ComfyUI: tres etapas Diffusion Fidelity Rendering que generan video con audio sincronizado desde una imagen."
sidebarTitle: "LTX-2.5 DFR"
-translationSourceHash: 525f6be2
+translationSourceHash: 6958a6c7
translationFrom: tutorials/video/ltx/ltx-2-5-dfr.mdx
translationBlockHashes:
"_intro": 950d68f0
"The three stages": 1ccaf9c8
"Model downloads": c2c37fb4
+ "Model storage": d7c0900c
"Workflow controls": 2cf64b86
"Prompting tips": c40b888a
---
+
Genera un video con audio sincronizado a partir de una sola imagen mediante la ruta Diffusion Fidelity Rendering de LTX-2.5. DFR es la receta con calidad de producción: un transformer destilado combinado con un IC-LoRA de detallado, con keyframes generados dentro del clip y reutilizados como guías por las pasadas posteriores. Activa `Switch to T2V` para ejecutar el mismo pipeline solo desde texto.
Para los demás flujos de trabajo de LTX-2.5, consulta la [descripción general de LTX-2.5](/es/tutorials/video/ltx/ltx-2-5).
@@ -36,17 +38,17 @@ Para los demás flujos de trabajo de LTX-2.5, consulta la [descripción general
| Etapa | Se ejecuta a | Pasos | Qué hace |
| :---- | :------ | :---- | :----------- |
-| 1. Generar | La mitad del tamaño de salida | 8 | Aplica denoising al video, con un fotograma clave de detalle por segundo, y al audio juntos en una sola pasada |
-| 2. Espacial x2 | El tamaño de salida | 3 | Aplica upscale al latent de la etapa 1 y lo vuelve a muestrear con el IC-LoRA de detalle espacial de píxeles, usando el latent de media resolución como referencia |
-| 3. Temporal x2 | 241 fotogramas a 48 fps | 4 | Duplica la frecuencia de fotogramas en la misma duración, con los fotogramas clave de la etapa 2 fijados como guías |
+| 1. Generar | La mitad del tamaño de salida | 8 | Aplica denoise al video, con un fotograma clave de detalle por segundo, y al audio juntos en una sola pasada |
+| 2. Espacial x2 | El tamaño de salida | 3 | Hace upscale del latente de la etapa 1 y lo vuelve a muestrear con el IC-LoRA de detalle espacial de píxeles, usando el latente de media resolución como referencia |
+| 3. Temporal x2 | 241 fotogramas a 48 fps | 4 | Duplica la frecuencia de cuadros durante la misma duración, con los fotogramas clave de la etapa 2 fijados como guías |
Todas las etapas muestrean con el sampler `euler`, `cfg` 1.0 y una programación fija de `ManualSigmas`. El checkpoint está destilado, así que el número de pasos y las programaciones son parte de la receta: cambiarlos cambia el aspecto del resultado.
-La tercera etapa es opcional. Desactiva `Run 3rd stage - Temporal Upscale` para saltarla y obtener en su lugar un clip con la frecuencia de fotogramas de la etapa 2. El audio se arrastra desde la etapa 1 por todo el pipeline, así que el sonido no cambia cuando se ejecuta la pasada temporal.
+La tercera etapa es opcional. Desactiva `Run 3rd stage - Temporal Upscale` para saltarla y obtener en su lugar un clip con la frecuencia de cuadros de la etapa 2. El audio se conserva desde la etapa 1 en todo el pipeline, así que el sonido no cambia cuando se ejecuta la pasada temporal.
## Descargas de modelos
-El flujo de trabajo DFR carga el codificador de texto de precisión completa y añade el IC-LoRA de detallado más el escalador temporal, por lo que su conjunto de modelos difiere del de los demás flujos de trabajo de LTX-2.5.
+El flujo de trabajo DFR carga el codificador de texto de precisión completa y añade el IC-LoRA de detallado más el upscaler temporal, por lo que su conjunto de modelos difiere del de los demás flujos de trabajo de LTX-2.5.
@@ -97,15 +99,15 @@ ComfyUI/
## Controles del flujo de trabajo
-- `Start image (I2V)`: el primer fotograma. Se ignora mientras `Switch to T2V` esté activado
-- `Output size (aspect / megapixels)`: la relación de aspecto y el presupuesto de píxeles objetivo, redondeados a múltiplos de 32. La etapa 1 se ejecuta a la mitad de este tamaño
-- `Switch to T2V`: ejecuta el pipeline solo a partir de texto, sin una imagen inicial
-- `Float (fps)` y `Float (Duration)`: 24 fps durante 5 segundos por defecto, lo que da 121 fotogramas
-- `Enable Prompt Enhancer`: reescribe y amplía el prompt con el pequeño codificador Gemma 4 antes del muestreo
-- `Enable Tiled Decode`: decodifica el VAE en mosaicos para reducir el uso de VRAM, con un pequeño costo en el detalle fino
+- `Start image (I2V)`: el primer fotograma. Se ignora mientras `Switch to T2V` está activado.
+- `Output size (aspect / megapixels)`: la relación de aspecto y el presupuesto de píxeles objetivo, redondeados a múltiplos de 32. La etapa 1 se ejecuta a la mitad de este tamaño.
+- `Switch to T2V`: ejecuta el pipeline solo a partir de texto, sin una imagen inicial.
+- `Float (fps)` y `Float (Duration)`: 24 fps durante 5 segundos de forma predeterminada, lo que equivale a 121 fotogramas.
+- `Enable Prompt Enhancer`: reescribe y amplía el prompt con el pequeño codificador Gemma 4 antes del muestreo.
+- `Enable Tiled Decode`: decodifica el VAE por mosaicos para reducir el uso de VRAM, a costa de un pequeño sacrificio en el detalle fino.
## Consejos para escribir prompts
-1. **Escribe para un solo plano continuo**: DFR construye el clip a partir de fotogramas clave generados, así que describe una escena que se desarrolla en una sola toma en lugar de una secuencia de cortes
+1. **Escribe para una sola toma continua**: DFR construye el clip a partir de keyframes generados, así que describe una escena que se desarrolla en una sola toma en lugar de una secuencia de cortes
2. **Audio en la misma pasada**: pon las líneas habladas entre comillas y describe el ambiente y los efectos; el modelo genera el audio junto con el video
-3. **Mantén los movimientos de cámara suaves**: los movimientos rápidos sobre texturas con ruido y degradados suaves son donde el pipeline tiene más probabilidades de mostrar ebullición o banding
+3. **Mantén los movimientos de cámara suaves**: los movimientos rápidos sobre texturas con ruido y degradados suaves son donde el pipeline es más propenso a mostrar ebullición o banding
diff --git a/es/tutorials/video/ltxv.mdx b/es/tutorials/video/ltxv.mdx
index 21999ebd3e..79d540fb4f 100644
--- a/es/tutorials/video/ltxv.mdx
+++ b/es/tutorials/video/ltxv.mdx
@@ -2,13 +2,14 @@
title: "LTX-Video 0.9.5 en ComfyUI: T2V, I2V, control de múltiples fotogramas"
sidebarTitle: "LTX-0.9.5"
description: "Ejecuta LTX-Video 0.9.5 en ComfyUI para texto a video, imagen a video y control multifotograma desde imágenes inicial y final, con descarga y configuración."
-translationSourceHash: b2aad3a7
+translationSourceHash: b4e3cee7
translationFrom: tutorials/video/ltxv.mdx
translationBlockHashes:
"_intro": 354083fd
"Multi Frame Control": 0fe2f937
"Image to Video": 1072ef32
"Text to Video": 664fc166
+ "Requirements": 4d0884e2
---
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
@@ -85,14 +86,14 @@ Arrastra el video directamente a ComfyUI para ejecutar el flujo de trabajo.
## Requisitos
-Descarga los siguientes modelos y colócalos en las ubicaciones que se indican a continuación:
+Descarga los siguientes modelos y colócalos en las ubicaciones indicadas a continuación:
- Descarga y guárdalo en ComfyUI/models/checkpoints/
+ Descarga y coloca en ComfyUI/models/checkpoints/
- Descarga y guárdalo en ComfyUI/models/text_encoders/
+ Descarga y coloca en ComfyUI/models/text_encoders/
```
@@ -101,3 +102,4 @@ Descarga los siguientes modelos y colócalos en las ubicaciones que se indican a
└── text_encoders/
└── t5xxl_fp16.safetensors
```
+
diff --git a/es/tutorials/video/minimax/minimax-h3-fastvideo.mdx b/es/tutorials/video/minimax/minimax-h3-fastvideo.mdx
index 0dadd530c0..99eb4726c1 100644
--- a/es/tutorials/video/minimax/minimax-h3-fastvideo.mdx
+++ b/es/tutorials/video/minimax/minimax-h3-fastvideo.mdx
@@ -2,25 +2,27 @@
title: "FastVideo FastH3: ejemplos de flujos de trabajo de ComfyUI"
description: "FastVideo FastH3 genera video MiniMax H3 con audio sincronizado en 8 pasos de muestreo en ComfyUI, para flujos de texto a video y de primer/último fotograma."
sidebarTitle: "FastVideo FastH3"
-translationSourceHash: c9534724
+translationSourceHash: cb542dfa
translationFrom: tutorials/video/minimax/minimax-h3-fastvideo.mdx
translationBlockHashes:
"_intro": 096c332e
"Requirements": bcdeb37e
- "FastH3 Text to Video": e9a7420a
+ "FastH3 Text to Video": 1c4cb909
"FastH3 Image to Video": ec7d82bf
- "Workflow structure notes": 77b7c476
+ "Model downloads": b88037db
+ "Workflow structure notes": 8f5d2153
---
-[FastVideo FastH3](https://huggingface.co/FastVideo/FastVideo-FastH3-8-Step-V2) es un checkpoint de MiniMax H3 destilado con DMD2 por el equipo de FastVideo que genera video con audio nativo sincronizado en **8 pasos de muestreo** en lugar de la programación completa del modelo base. Reutiliza el codificador de texto de H3, el VAE de video y el VAE de audio, así que el resultado coincide con la configuración del modelo base mientras el muestreo termina en una fracción de los pasos.
-El trabajo de la versión de vista previa de FastH3 se desarrolló en colaboración con Nuva Lab y el equipo de NVIDIA FastGen; consulta el [anuncio de FastH3](https://haoailab.com/blogs/fasth3-preview/) para conocer los detalles de la destilación. ComfyUI incluye el checkpoint V2 de 8 pasos, reempaquetado por Comfy-Org en el [repositorio FastVideo-FastH3-Comfy](https://huggingface.co/FastVideo/FastVideo-FastH3-Comfy).
+[FastVideo FastH3](https://huggingface.co/FastVideo/FastVideo-FastH3-8-Step-V2) es un checkpoint de MiniMax H3 destilado con DMD2 por el equipo de FastVideo que genera video con audio nativo sincronizado en **8 pasos de muestreo** en lugar del programa de muestreo completo del modelo base. Reutiliza el codificador de texto de H3, el VAE de video y el VAE de audio, así que el resultado coincide con la configuración del modelo base mientras el muestreo termina en una fracción de los pasos.
+
+El trabajo de vista previa de FastH3 se desarrolló en colaboración con Nuva Lab y el equipo de NVIDIA FastGen; consulta el [anuncio de FastH3](https://haoailab.com/blogs/fasth3-preview/) para conocer los detalles de la destilación. ComfyUI incluye el checkpoint V2 de 8 pasos, reempaquetado por Comfy-Org en el [repositorio FastVideo-FastH3-Comfy](https://huggingface.co/FastVideo/FastVideo-FastH3-Comfy).
FastH3 sacrifica algo de fidelidad de movimiento y audio a cambio de velocidad. Úsalo para borradores, iteración y entregas rápidas; usa los flujos de trabajo base de MiniMax H3 cuando la máxima calidad sea lo importante.
-El checkpoint destilado solo admite texto a video e imagen a video con primer y último fotograma. Ref2VA (conditioning con múltiples referencias) no se destiló; usa los [flujos de trabajo base de MiniMax H3](/es/tutorials/video/minimax/minimax-h3-native) para la generación basada en referencias.
+El checkpoint destilado solo admite texto a video e imagen a video con primer y último fotograma. Ref2VA (acondicionamiento con múltiples referencias) no se destiló; usa los [flujos de trabajo base de MiniMax H3](/es/tutorials/video/minimax/minimax-h3-native) para la generación basada en referencias.
## Requisitos
@@ -49,17 +51,17 @@ Genera video y audio sincronizados a partir de un prompt de texto en 8 pasos.
### Consejos para escribir prompts
-1. **Describe toda la escena**: Indica primero la escena general (lugar, personaje, qué ocurre) y luego divídela en tomas con duración
+1. **Describe toda la escena**: Indica primero la escena general (lugar, personaje, qué ocurre) y luego divídela en tomas con tiempos definidos
2. **Tomas, cámara y audio**: Describe las tomas, los movimientos de cámara y el audio que las acompaña (diálogo, SFX, música) en un solo bloque de prompt
-3. **Resolución**: El lienzo nativo de H3 tiene un borde corto de 768px y un área de 768×1344, y las resoluciones se redondean a un múltiplo de 32. El nodo acepta tamaños mayores, pero se renderizan más lento sin añadir detalle
+3. **Resolución**: El lienzo nativo de H3 tiene un borde corto de 768px y un área de 768×1344, y las resoluciones se redondean a un múltiplo de 32. El nodo acepta tamaños mayores, pero tardan más en renderizarse sin añadir detalle
4. **Duración**: La entrada de duración se ajusta a la cuadrícula del modelo de 17 fotogramas por bloque (17k+5) a 24fps
-5. **Los pasos son fijos en 8**: El checkpoint destilado está entrenado para exactamente 8 pasos; cambiar la cantidad de pasos en el scheduler degrada la calidad
+5. **Los pasos son fijos en 8**: El checkpoint destilado está entrenado para exactamente 8 pasos; cambiar el número de pasos en el scheduler degrada la calidad
-Para obtener recursos sobre cómo escribir prompts, consulta la [guía de prompts](/es/tutorials/video/minimax/minimax-h3-prompt-guide).
+Para ver recursos sobre cómo escribir prompts, consulta la [guía de prompts](/es/tutorials/video/minimax/minimax-h3-prompt-guide).
## FastH3: imagen a video
-Anima una imagen fija con audio sincronizado y con control opcional de primer y último fotograma.
+Anima una imagen fija con audio sincronizado y con control opcional del primer y último fotograma.
@@ -88,7 +90,7 @@ Sube este archivo al nodo `LoadImage` correspondiente, o usa tu propia imagen:
### Modo de primer y último fotograma
-Conecta imágenes a `first_frame` y/o `last_frame` en el nodo `MiniMaxH3ImageToVideo` para generar el movimiento entre dos fotogramas clave. Deja ambos desconectados para texto a video.
+Conecta imágenes a `first_frame` y/o `last_frame` en el nodo `MiniMaxH3ImageToVideo` para generar el movimiento entre dos fotogramas clave. Deja ambos desconectados para el modo texto a video.
### Consejos para el prompt
@@ -96,15 +98,15 @@ Conecta imágenes a `first_frame` y/o `last_frame` en el nodo `MiniMaxH3ImageToV
2. **Duración**: La entrada de duración se ajusta a la cuadrícula del modelo de 17 fotogramas por bloque (17k+5) a 24fps
3. **Los pasos están fijos en 8**: Mantén el scheduler en 8 pasos; el checkpoint está destilado para esa programación
-## Descarga de modelos
+## Descargas de modelos
-El modelo de difusión viene del repositorio de FastVideo; el codificador de texto y los VAE se comparten con el modelo base MiniMax H3.
+El modelo de diffusion proviene del repositorio FastVideo; el text encoder y los VAE se comparten con el modelo base MiniMax H3.
-
+
Colócalo en
-
+
Colócalo en
@@ -131,11 +133,11 @@ ComfyUI/
## Notas sobre la estructura del flujo de trabajo
-Ambos flujos de trabajo FastH3 comparten estos nodos con la configuración base de H3, con configuraciones específicas de destilación:
+Ambos flujos de trabajo de FastH3 comparten estos nodos con la configuración base de H3, con configuraciones específicas de destilación:
-- **BlockSparseAttention**: ejecuta Video Sparse Attention (VSA) con `keep_percent` 10, iniciando al 20% de la programación, lo que reduce el costo de atención mientras preserva la calidad
-- **MiniMaxH3SigmaShift**: aplica el desplazamiento sigma de H3 (10 para video, 3 para audio) que coincide con la programación destilada
-- **ComfyMathExpression**: convierte la entrada de duración en una `length` de fotogramas válida en la cuadrícula de 17k+5 a 24fps
-- **Sampler**: sampler `res_multistep` con el scheduler `simple` a 8 pasos
+- **BlockSparseAttention**: Ejecuta Video Sparse Attention (VSA) con `keep_percent` 10, a partir del 20% del programa, lo que reduce el costo de atención mientras preserva la calidad
+- **MiniMaxH3SigmaShift**: Aplica el desplazamiento sigma de H3 (10 para video, 3 para audio) que coincide con el programa destilado
+- **ComfyMathExpression**: Convierte la entrada de duración en una `length` de fotogramas válida en la cuadrícula 17k+5 a 24fps
+- **Sampler**: sampler `res_multistep` con el scheduler `simple` en 8 pasos
-Los pesos de FastH3 incluyen capas de compuerta `to_gate_compress`, que VSA lee para su rama gruesa. Los checkpoints base de H3 no las tienen. Para comparar métodos, establece `method` en `sol-attn` en el nodo **Model Sparse Attention** y mantén la misma seed. `sol-attn` no necesita pesos coincidentes y se ejecuta en cualquier checkpoint H3 con el `tau` que establezcas.
+Los pesos de FastH3 incluyen capas de compuerta `to_gate_compress`, que VSA lee para su rama gruesa. Los checkpoints base de H3 no las tienen. Para comparar métodos, establece `method` en `sol-attn` en el nodo **Model Sparse Attention** y mantén la misma semilla. `sol-attn` no necesita pesos coincidentes y funciona con cualquier checkpoint de H3 con el `tau` que establezcas.
diff --git a/es/tutorials/video/minimax/minimax-h3-fun-controlnet.mdx b/es/tutorials/video/minimax/minimax-h3-fun-controlnet.mdx
index 273cef655d..918bc97d5e 100644
--- a/es/tutorials/video/minimax/minimax-h3-fun-controlnet.mdx
+++ b/es/tutorials/video/minimax/minimax-h3-fun-controlnet.mdx
@@ -2,14 +2,16 @@
title: "ComfyUI MiniMax H3 Fun ControlNet Union: video con control de pose, profundidad y Canny"
description: "Guía el movimiento de video de MiniMax H3 en ComfyUI con videos de control Canny, Depth, HED, MLSD o Pose, además de relleno inteligente con máscaras usando el parche Fun ControlNet Union."
sidebarTitle: "Fun ControlNet Union"
-translationSourceHash: d4c42cef
+translationSourceHash: e9538916
translationFrom: tutorials/video/minimax/minimax-h3-fun-controlnet.mdx
translationBlockHashes:
"_intro": a84faa25
"Model downloads": 5310815d
+ "Model storage": b507229f
"Prompting tips": 39f67d41
---
-Controla el movimiento de un video de MiniMax H3 con un video de control en lugar de solo texto. El parche Fun ControlNet Union ([alibaba-pai/MiniMax-H3-Fun-Controlnet-Union](https://huggingface.co/alibaba-pai/MiniMax-H3-Fun-Controlnet-Union), empaquetado en [Comfy-Org/MiniMax-H3](https://huggingface.co/Comfy-Org/MiniMax-H3)) es un único checkpoint que condiciona H3 con videos de control Canny, Profundidad, HED, MLSD o Pose, y también ejecuta relleno inteligente de video con una máscara. Funciona con ambos archivos transformer `fl2va` y `ref2va`.
+
+Controla el movimiento de un video de MiniMax H3 con un video de control en lugar de usar solo texto. El parche Fun ControlNet Union ([alibaba-pai/MiniMax-H3-Fun-Controlnet-Union](https://huggingface.co/alibaba-pai/MiniMax-H3-Fun-Controlnet-Union), empaquetado en [Comfy-Org/MiniMax-H3](https://huggingface.co/Comfy-Org/MiniMax-H3)) es un único checkpoint que condiciona H3 con videos de control Canny, Profundidad, HED, MLSD o Pose, y también ejecuta relleno inteligente de video con una máscara. Funciona con los archivos transformer `fl2va` y `ref2va`.
@@ -32,7 +34,7 @@ Sube este archivo al nodo `Load Video` correspondiente:
-Esta plantilla requiere ComfyUI 0.35.0 o una versión posterior. El ejemplo usa un video de control de pose: un subgrafo SDPose integrado extrae el esqueleto de la pose del video de entrada, por lo que la salida reproduce el movimiento del bailarín. También puedes conectar cualquier video de control preprocesado directamente a la entrada `control_video` del nodo `Apply MiniMax H3 Fun ControlNet`.
+Esta plantilla requiere ComfyUI 0.35.0 o una versión posterior. El ejemplo usa un video de control de pose: un subgrafo SDPose integrado extrae el esqueleto de la pose del video de entrada, así que la salida reproduce el movimiento del bailarín. También puedes conectar cualquier video de control preprocesado directamente a la entrada `control_video` del nodo `Apply MiniMax H3 Fun ControlNet`.
## Descargas de modelos
@@ -53,7 +55,7 @@ Esta plantilla requiere ComfyUI 0.35.0 o una versión posterior. El ejemplo usa
Coloca en
- Habilita el modo turbo opcional con el Lightning LoRA. Coloca en
Extractor de pose que usa el subgrafo SDPose integrado. Coloca en
- Habilita el modo turbo opcional con el Lightning LoRA. Colócalo en
@@ -76,12 +78,12 @@ ComfyUI/
## Consejos para el prompt
-1. **Haz referencia por etiqueta**: `` es la imagen conectada a la primera ranura de `ref_images`, `` a la segunda, y así sucesivamente. En este flujo de trabajo, `` es tanto el bloqueo de identidad como el primer fotograma del video
-2. **Anclajes de la línea de tiempo frente a referencias**: las imágenes conectadas solo a nodos Add Guide anclan composiciones en fotogramas específicos, pero no son visibles para el codificador de texto. Conéctalas también a ranuras `ref_images` adicionales si quieres que el prompt las vea como ``
-3. **Índice de fotograma**: cada Add Guide toma `frame_idx` en fotogramas a 24 fps; la plantilla lo calcula a partir de segundos con `round(seconds * 24)`. Los valores negativos cuentan desde el final del video. El índice más la longitud de la guía deben quedar dentro de la duración generada
-4. **Añade más fotogramas clave**: copia un bloque de guía (Load Image + Frame Index + Math Expression + Add Guide for MiniMax H3) y mantén las salidas `positive` encadenadas en serie hacia el Basic Guider
-5. **Modo turbo (opcional)**: activa la casilla **Lightning LoRA** para usar el LoRA turbo de 4 pasos y lograr una generación mucho más rápida, con una calidad de audio y movimiento ligeramente inferior
+1. **Referencia por etiqueta**: `` es la imagen conectada a la primera ranura `ref_images`, `` la segunda, y así sucesivamente. En este flujo de trabajo, `` es a la vez el bloqueo de identidad y el primer fotograma del video
+2. **Anclajes de línea de tiempo vs referencias**: Las imágenes conectadas solo a nodos Añadir guía para MiniMax H3 anclan composiciones en fotogramas específicos, pero no son visibles para el codificador de texto. Conéctalas también a ranuras `ref_images` adicionales si el prompt debe verlas como ``
+3. **Índice de fotogramas**: Cada Añadir guía para MiniMax H3 toma `frame_idx` en fotogramas a 24fps; la plantilla lo calcula a partir de segundos con `round(seconds * 24)`. Los valores negativos cuentan desde el final del video. El índice más la longitud de la guía deben mantenerse dentro de la duración generada
+4. **Añadir más fotogramas clave**: Copia un bloque de guía (Cargar imagen + Índice de fotogramas + Expresión matemática + Añadir guía para MiniMax H3) y mantén las salidas `positive` encadenadas en serie hasta la Guía básica
+5. **Modo turbo (opcional)**: Activa la casilla **Lightning LoRA** para usar el LoRA turbo de 4 pasos y obtener una generación mucho más rápida, con una calidad de audio y movimiento ligeramente inferior
## Guía para escribir prompts
-El prompt de la plantilla sigue la [guía de prompts del modo de referencia completa](https://huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/docs/VIDEO_PROMPT_WRITING_GUIDE_ref_en.md): define cada sujeto, asigna cada `` al primer fotograma o fotograma clave de un plano y corta entre planos en marcas de tiempo explícitas. Usa la misma estructura cuando escribas tus propios prompts de varios planos. La guía está resumida en la [guía de prompts](/es/tutorials/video/minimax/minimax-h3-prompt-guide).
+El prompt de la plantilla sigue la [guía de prompts del modo de referencia completa](https://huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/docs/VIDEO_PROMPT_WRITING_GUIDE_ref_en.md): define cada sujeto, asigna cada `` al primer fotograma o al fotograma clave de un plano, y corta entre planos en marcas de tiempo explícitas. Usa la misma estructura cuando escribas tus propios prompts de varios planos. La guía está resumida en la [guía de prompts](/es/tutorials/video/minimax/minimax-h3-prompt-guide).
diff --git a/es/tutorials/video/minimax/minimax-h3-prompt-guide.mdx b/es/tutorials/video/minimax/minimax-h3-prompt-guide.mdx
index 2a9accf37c..7d48c43bc4 100644
--- a/es/tutorials/video/minimax/minimax-h3-prompt-guide.mdx
+++ b/es/tutorials/video/minimax/minimax-h3-prompt-guide.mdx
@@ -2,16 +2,17 @@
title: "Guía de prompts de ComfyUI MiniMax H3: guías oficiales, consejos y embeddings de prompt"
description: "Escribe mejores prompts de MiniMax H3 en ComfyUI: guías oficiales, consejos generales, reglas de diálogo y hablantes, y embeddings de estilo."
sidebarTitle: "Guía de prompts"
-translationSourceHash: 0d858ae8
+translationSourceHash: 0f1ded35
translationFrom: tutorials/video/minimax/minimax-h3-prompt-guide.mdx
translationBlockHashes:
"_intro": da22cc9d
"Official guides": 3d762c67
- "General tips": 91822299
+ "General tips": fab4ad35
"Shots and cuts": 8184dae6
"Dialogue and speakers": 4985438e
"Prompt embeddings": 9c899169
---
+
H3 espera planos, cámara, diálogo y SFX en un solo prompt multimodal. Esta página reúne guías oficiales, consejos entre flujos de trabajo, reglas de planos y diálogo, y embeddings de estilo.
## Guías oficiales
@@ -21,7 +22,7 @@ H3 espera planos, cámara, diálogo y SFX en un solo prompt multimodal. Esta pá
El paquete instalable de [habilidades H3](https://github.com/MiniMax-AI/MiniMax-H3/tree/main/skills) reúne estos contenidos para los agentes.
-Aplicado por plantilla: [T2V/I2V](/es/tutorials/video/minimax/minimax-h3-native), [R2V](/es/tutorials/video/minimax/minimax-h3-native#minimax-h3-referencia-a-video-r2v), [Multiframe](/es/tutorials/video/minimax/minimax-h3-multiframe#guía-para-escribir-prompts), [Fun ControlNet](/es/tutorials/video/minimax/minimax-h3-fun-controlnet#consejos-para-los-prompts).
+Aplicado por plantilla: [T2V/I2V](/es/tutorials/video/minimax/minimax-h3-native), [R2V](/es/tutorials/video/minimax/minimax-h3-native#minimax-h3-referencia-a-video-r2v), [Multiframe](/es/tutorials/video/minimax/minimax-h3-multiframe#guía-para-escribir-prompts), [Fun ControlNet](/es/tutorials/video/minimax/minimax-h3-fun-controlnet#consejos-para-escribir-prompts).
## Consejos generales
@@ -41,7 +42,7 @@ Escribe los prompts en **inglés**. Los diálogos y las letras de canciones van
4. **Longitud**: `length` son fotogramas a 24fps (predeterminado **124** ≈ 5s), ajustado a **17k+5**
5. **Texto en pantalla**: comillas dobles en inglés para cada cadena, literal (p. ej., `A red neon sign reading "营业中"`). Las líneas habladas usan ``, no comillas
6. **Marcadores de audio de R2V**: en el análisis de retención, marca cada referencia de audio como `fully_copy`, `partially_copy`, `reference` o `weak_reference` según cómo se use el clip (consulta la tabla de la guía oficial de referencias)
-7. **Campos de audio**: `overall_soundscape` = sonido ambiente/SFX/no verbal (1–4 frases; `N/A` solo si hay silencio real). Los diálogos y la música diegética se mantienen en los planos. `non_diegetic_music` = solo banda sonora (1–3 frases; `N/A` si no hay). Si aparece habla no deseada, rellena ambos campos de forma explícita
+7. **Campos de audio**: `overall_soundscape` = sonido ambiente/SFX/no verbal (1–4 frases; `N/A` solo si hay silencio real). Los diálogos y la música diegética se mantienen en los planos. `non_diegetic_music` = solo banda sonora musical (1–3 frases; `N/A` si no hay). Si aparece habla no deseada, rellena ambos campos de forma explícita
8. **Sin negativos**: `BasicGuider` funciona con `cfg` 1 y sin rama negativa. Las listas de prohibiciones añaden conceptos no deseados. Indica lo que debería aparecer (o usa los campos de retención de R2V: `fully_preserved`, `partially_preserved`, etc.)
9. **Hojas de referencia (R2V)**: una imagen puede contener varios paneles. Asigna a la hoja su propio `` (no solo dentro de ``), describe los paneles y dirige los planos a un panel (p. ej., vista frontal completa de ``). Etiqueta los paneles con claridad
diff --git a/es/tutorials/video/wan/fun-camera.mdx b/es/tutorials/video/wan/fun-camera.mdx
index 44669c4aad..45a71045d2 100644
--- a/es/tutorials/video/wan/fun-camera.mdx
+++ b/es/tutorials/video/wan/fun-camera.mdx
@@ -2,16 +2,18 @@
title: "Ejemplos oficiales de ComfyUI Wan2.1 Fun Camera"
description: "Esta guía muestra cómo usar Wan2.1 Fun Camera en ComfyUI para generar video"
sidebarTitle: "Wan2.1 Fun Camera"
-translationSourceHash: 6173f2a1
+translationSourceHash: f2b906a8
translationFrom: tutorials/video/wan/fun-camera.mdx
translationBlockHashes:
"_intro": 59d5e57d
"About Wan2.1 Fun Camera": 98c0ae00
+ "Model Installation": 65ab0da5
"ComfyUI Wan2.1 Fun Camera 1.3B Workflow": 4ddf8882
"ComfyUI Wan2.1 Fun Camera 14B Workflow": ea99a5f1
"Performance Reference": 2dc2f8f0
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
Wan2.1 Fun Camera es un modelo de generación de video con movimiento de cámara del proyecto VideoX-Fun de Alibaba, con soporte nativo en ComfyUI. Genera videos cuyo movimiento de cámara sigue tus condiciones de control, así puedes dirigir cómo se mueve la cámara en el resultado en lugar de describir cada plano en el prompt.
@@ -19,27 +21,27 @@ El modelo forma parte de la familia Wan2.1-Fun y se distribuye en dos tamaños:
## Acerca de Wan2.1 Fun Camera
-**Wan2.1 Fun Camera** es un proyecto de generación de video lanzado por el equipo de Alibaba, centrado en controlar los efectos de generación de video mediante el movimiento de cámara.
+**Wan2.1 Fun Camera** es un proyecto de generación de video lanzado por el equipo de Alibaba, centrado en controlar los efectos de la generación de video mediante el movimiento de cámara.
-**Descargar los pesos del modelo**:
+**Descarga de los pesos del modelo**:
- [Versión 14B](https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-14B-Control-Camera)
- [Versión 1.3B](https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-1.3B-Control-Camera)
**Repositorio de código**: [VideoX-Fun](https://github.com/aigc-apps/VideoX-Fun)
-**ComfyUI ahora es compatible de forma nativa con el modelo Wan2.1 Fun Camera**.
+**ComfyUI ya es compatible de forma nativa con el modelo Wan2.1 Fun Camera**.
@@ -50,7 +52,7 @@ Elige entre 1.3B o 14B:
-Si ya has usado modelos de Wan2.1, deberías tener ya los siguientes modelos. Si no es así, descárgalos:
+Si ya has usado modelos relacionados con Wan2.1 antes, ya deberías tener los siguientes modelos. Si no es así, descárgalos:
### Codificadores de texto
@@ -61,7 +63,7 @@ Elige uno de los siguientes:
Codificador de texto de precisión completa
- Codificador de texto cuantizado FP8 (recomendado para menos VRAM)
+ Codificador de texto cuantizado FP8 (RECOMENDADO para menos VRAM)
@@ -69,7 +71,7 @@ Elige uno de los siguientes:
- Modelo VAE de Wan2.1
+ Modelo VAE Wan2.1
@@ -77,7 +79,7 @@ Elige uno de los siguientes:
- Codificador CLIP Vision
+ Codificador de visión CLIP
@@ -110,7 +112,7 @@ Genera videos dinámicos con movimientos de cámara cinematográficos usando el
Abrir en Comfy Cloud
- Descarga el JSON o busca "Wan 2.1 Fun Camera 1.3B" en la biblioteca de plantillas
+ Descarga el JSON o busca "Wan 2.1 Fun Camera 1.3B" en la Biblioteca de plantillas
@@ -144,12 +146,12 @@ Sube este archivo al nodo `LoadImage` correspondiente:

-1. Verifica que se haya cargado la versión correcta del archivo del modelo:
+1. Asegúrate de que esté cargada la versión correcta del archivo del modelo:
- Versión 1.3B: `wan2.1_fun_camera_v1.1_1.3B_bf16.safetensors`
- Versión 14B: `wan2.1_fun_camera_v1.1_14B_bf16.safetensors`
-2. Verifica que el nodo `Load CLIP` tenga cargado `umt5_xxl_fp8_e4m3fn_scaled.safetensors`
-3. Verifica que el nodo `Load VAE` tenga cargado `wan_2.1_vae.safetensors`
-4. Verifica que el nodo `Load CLIP Vision` tenga cargado `clip_vision_h.safetensors`
+2. Asegúrate de que el nodo `Load CLIP` tenga cargado `umt5_xxl_fp8_e4m3fn_scaled.safetensors`
+3. Asegúrate de que el nodo `Load VAE` tenga cargado `wan_2.1_vae.safetensors`
+4. Asegúrate de que el nodo `Load CLIP Vision` tenga cargado `clip_vision_h.safetensors`
5. Sube el fotograma inicial al nodo `Load Image`
6. Modifica el prompt si vas a usar tu propia imagen de entrada
7. Configura el movimiento de cámara en el nodo `WanCameraEmbedding`
@@ -159,7 +161,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
### Wan 2.1 Fun Camera 14B {#video_wan2.1_fun_camera_v1.1_14B}
-Genera videos de alta calidad con control de cámara avanzado usando el modelo completo de 14B.
+Genera videos de alta calidad con control de cámara avanzado usando el modelo completo 14B.
 @@ -184,7 +186,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
- nodo `LoadImage` 52 · `video_wan2.1_fun_camera_v1.1_14B_start_image.jpg`
+ Nodo `LoadImage` 52 · `video_wan2.1_fun_camera_v1.1_14B_start_image.jpg`
@@ -195,7 +197,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
## Referencia de rendimiento
**Versión 1.3B**:
-- A 512x512 de resolución, una RTX 4090 tarda unos 72 segundos en generar 81 frames
+- Con una resolución de 512x512 en una RTX 4090, generar 81 fotogramas tarda unos 72 segundos
**Versión 14B**:
-- Una RTX 4090 de 24 GB de VRAM puede quedarse sin memoria al generar a 512x512 de resolución, y también han aparecido problemas de memoria en una A100 al usar tamaños mayores
+- La RTX 4090 de 24 GB de VRAM puede quedarse sin memoria al generar a una resolución de 512x512, y también se han producido problemas de memoria en la A100 al usar tamaños mayores
diff --git a/es/tutorials/video/wan/fun-control.mdx b/es/tutorials/video/wan/fun-control.mdx
index fc40179236..199cf3a256 100644
--- a/es/tutorials/video/wan/fun-control.mdx
+++ b/es/tutorials/video/wan/fun-control.mdx
@@ -2,32 +2,34 @@
title: "Ejemplos de video con Wan2.1 Fun Control en ComfyUI"
description: "Esta guía muestra cómo usar Wan2.1 Fun Control en ComfyUI para generar videos con videos de control"
sidebarTitle: "Wan2.1 Fun Control"
-translationSourceHash: 2ce972d6
+translationSourceHash: 8b293934
translationFrom: tutorials/video/wan/fun-control.mdx
translationBlockHashes:
"_intro": b7cb8b6d
"About Wan2.1-Fun-Control": 2e562079
+ "Model Installation": 6ee9c5c6
"ComfyUI Native Workflow": 01fc65b5
"Workflow Using Custom Nodes": 8f081a21
"Usage Tips": 9e74c201
---
+
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
Wan2.1-Fun-Control es un modelo de generación de video de código abierto del proyecto VideoX-Fun de Alibaba que sigue condiciones de control predefinidas en lugar de depender únicamente del texto del prompt. Puedes guiar la salida con mapas de bordes Canny, mapas de profundidad, esqueletos OpenPose, bordes geométricos MLSD o trayectorias de puntos.
-El modelo está disponible en dos tamaños: la versión de 1.3B (unos 19 GB) para un despliegue local ligero con menores requisitos de VRAM, y la versión de 14B (unos 47 GB de almacenamiento total del modelo, con los pesos de difusión en unos 32.8 GB) para resultados de mayor calidad. Ambas admiten predicción de video multirresolución a 512, 768 y 1024 píxeles, generan hasta 81 fotogramas (unos 5 segundos) a 16 fotogramas por segundo y aceptan prompts multilingües. ComfyUI ofrece soporte nativo para Wan2.1-Fun-Control.
+El modelo se ofrece en dos tamaños: la versión de 1.3B (unos 19 GB) para un despliegue local ligero con menores requisitos de VRAM, y la versión de 14B (unos 47 GB de almacenamiento total del modelo, con los pesos de diffusion en unos 32.8 GB) para obtener resultados de mayor calidad. Ambas admiten predicción de video multirresolución a 512, 768 y 1024 píxeles, generan hasta 81 fotogramas (unos 5 segundos) a 16 fotogramas por segundo y aceptan prompts multilingües. ComfyUI ofrece soporte nativo para Wan2.1-Fun-Control.
## Acerca de Wan2.1-Fun-Control
**Wan2.1-Fun-Control** es un proyecto de generación y control de video de código abierto desarrollado por el equipo de Alibaba.
-Introduce mecanismos innovadores de códigos de control (Control Codes) combinados con aprendizaje profundo y entradas condicionales multimodales para generar videos de alta calidad que cumplen con condiciones de control predefinidas. El proyecto se centra en guiar con precisión el contenido del video generado mediante condiciones de control multimodales.
+Introduce mecanismos innovadores de Control Codes combinados con aprendizaje profundo y entradas condicionales multimodales para generar videos de alta calidad que se ajustan a condiciones de control predefinidas. El proyecto se centra en guiar con precisión el contenido del video generado mediante condiciones de control multimodales.
-Actualmente, el modelo Fun Control admite diversas condiciones de control, como **Canny (arte lineal), Depth, OpenPose (postura humana), MLSD (bordes geométricos) y control de trayectoria.**
-El modelo también admite predicción de video multirresolución con opciones de 512, 768 y 1024 de resolución a 16 fotogramas por segundo, generando videos de hasta 81 fotogramas (aproximadamente 5 segundos) de duración.
+Actualmente, el modelo Fun Control admite diversas condiciones de control, entre ellas **Canny (arte lineal), Profundidad, OpenPose (postura humana), MLSD (bordes geométricos) y control de trayectoria.**
+El modelo también admite predicción de video multirresolución con opciones de resolución de 512, 768 y 1024 a 16 fotogramas por segundo, generando videos de hasta 81 fotogramas (aproximadamente 5 segundos) de duración.
Versiones del modelo:
-- **1.3B** Ligero: ideal para el despliegue local y la inferencia rápida con **requisitos de VRAM más bajos**
-- **14B** Alto rendimiento: el tamaño del modelo alcanza los 32 GB o más, ofrece mejores resultados pero **requiere más VRAM**
+- **1.3B** Ligera: adecuada para el despliegue local y la inferencia rápida con **requisitos de VRAM más bajos**
+- **14B** De alto rendimiento: el tamaño del modelo alcanza 32GB+, ofrece mejores resultados pero **requiere más VRAM**
**Descarga de los pesos del modelo**:
@@ -36,52 +38,52 @@ Versiones del modelo:
Versión ligera, requisitos de VRAM más bajos
- Versión de alto rendimiento, tamaño del archivo de 32 GB o más, requisitos de VRAM más altos
+ Versión de alto rendimiento, tamaño del archivo de 32GB+, requisitos de VRAM más altos
**Repositorio de código**: [VideoX-Fun](https://github.com/aigc-apps/VideoX-Fun)
-ComfyUI ahora **es compatible de forma nativa** con el modelo Wan2.1 Fun Control. Antes de comenzar este tutorial, actualiza tu ComfyUI para asegurarte de usar una versión posterior a [este commit](https://github.com/Comfy-Org/ComfyUI/commit/3661c833bcc41b788a7c9f0e7bc48524f8ee5f82).
+ComfyUI ahora **es compatible de forma nativa** con el modelo Wan2.1 Fun Control. Antes de comenzar este tutorial, actualiza tu ComfyUI para asegurarte de que usas una versión posterior a [este commit](https://github.com/Comfy-Org/ComfyUI/commit/3661c833bcc41b788a7c9f0e7bc48524f8ee5f82).
En esta guía proporcionamos dos flujos de trabajo:
1. Un flujo de trabajo que usa solo nodos nativos de Comfy Core
-2. Un flujo de trabajo que usa nodos personalizados
+2. Un flujo de trabajo que usa Nodos Personalizados
-Debido a las limitaciones actuales de los nodos nativos para el soporte de video, el flujo de trabajo solo con nodos nativos permite completar el proceso sin instalar nodos personalizados.
+Debido a las limitaciones actuales de los nodos nativos para el soporte de video, el flujo de trabajo solo con nodos nativos garantiza que los usuarios puedan completar el proceso sin instalar nodos personalizados.
Sin embargo, hemos comprobado que ofrecer una buena experiencia de usuario para la generación de video es complicado sin nodos personalizados, así que en esta guía incluimos ambas versiones del flujo de trabajo.
- Modelo de difusión Wan2.1 Fun Control 1.3B -- ligero, requiere menos VRAM
+ Modelo de difusión Wan2.1 Fun Control 1.3B: ligero, con menores requisitos de VRAM
- Modelo de difusión Wan2.1 Fun Control 14B. Cámbiale el nombre a
-**Codificadores de texto** -- elige uno de los siguientes modelos (la precisión fp16 tiene un tamaño mayor y requiere más rendimiento):
+**Codificadores de texto**: elige uno de los siguientes modelos (la precisión fp16 tiene un tamaño mayor y mayores requisitos de rendimiento):
- Codificador de texto UMT5 XXL -- precisión fp16, tamaño mayor, mayor rendimiento
+ Codificador de texto UMT5 XXL: precisión fp16, mayor tamaño, mayor rendimiento
- Codificador de texto UMT5 XXL -- precisión fp8, tamaño menor, requiere menos rendimiento
+ Codificador de texto UMT5 XXL: precisión fp8, menor tamaño, menores requisitos de rendimiento
@@ -95,7 +97,7 @@ Haz clic en los enlaces correspondientes para descargar. Si ya has usado flujos
Modelo CLIP Vision para procesar imágenes de referencia
-Ubicación de almacenamiento de archivos:
+Ubicación de almacenamiento de los archivos:
```
📂 ComfyUI/
├── 📂 models/
@@ -112,12 +114,12 @@ Ubicación de almacenamiento de archivos:
## Flujo de trabajo nativo de ComfyUI
-En este flujo de trabajo usamos videos convertidos a **formato WebP**, ya que el nodo `Load Image` no admite actualmente el formato mp4. También usamos **Canny Edge** para preprocesar el video original.
-Como muchos usuarios se topan con fallos de instalación y problemas de entorno al instalar nodos personalizados, esta versión del flujo de trabajo usa solo nodos nativos para garantizar una experiencia más fluida.
+En este flujo de trabajo usamos videos convertidos a **formato WebP**, ya que el nodo `Load Image` todavía no admite el formato mp4. También usamos **Canny Edge** para preprocesar el video original.
+Como muchos usuarios se encuentran con fallos de instalación y problemas de entorno al instalar nodos personalizados, esta versión del flujo de trabajo usa solo nodos nativos para garantizar una experiencia más fluida.
-Gracias a nuestros potentes autores de ComfyUI, que ofrecen nodos con muchas funciones. Si quieres consultar directamente la versión relacionada, mira [Flujo de trabajo con nodos personalizados](#flujo-de-trabajo-con-nodos-personalizados).
+Gracias a nuestros grandes autores de ComfyUI, que ofrecen nodos con muchas funciones. Si quieres consultar directamente la versión relacionada, ve a [Flujo de trabajo con nodos personalizados](#flujo-de-trabajo-con-nodos-personalizados).
-### 1. Descarga del archivo del flujo de trabajo
+### 1. Descargar el archivo del flujo de trabajo
@@ -141,7 +143,7 @@ Gracias a nuestros potentes autores de ComfyUI, que ofrecen nodos con muchas fun
-### 2. Completa el flujo de trabajo paso a paso
+### 2. Completar el flujo de trabajo paso a paso

@@ -150,37 +152,37 @@ Gracias a nuestros potentes autores de ComfyUI, que ofrecen nodos con muchas fun
3. Asegúrate de que el nodo `Load VAE` haya cargado `wan_2.1_vae.safetensors`
4. Asegúrate de que el nodo `Load CLIP Vision` haya cargado `clip_vision_h.safetensors`
5. Sube el fotograma inicial al nodo `Load Image` (renombrado como `Start_image`)
-6. Sube el video de control al segundo nodo `Load Image`. Nota: este nodo actualmente no admite mp4, solo videos WebP
-7. (Opcional) Modifica el prompt (se admite inglés y chino)
+6. Sube el video de control al segundo nodo `Load Image`. Nota: este nodo no admite mp4 por ahora, solo videos WebP
+7. (Opcional) Modifica el prompt (se admiten inglés y chino)
8. (Opcional) Ajusta el tamaño del video en `WanFunControlToVideo`, evitando dimensiones demasiado grandes
-9. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video
+9. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación del video
### 3. Notas de uso
-- Como debemos introducir en el nodo `WanFunControlToVideo` el mismo número de fotogramas que tiene el video de control, si el número de fotogramas especificado supera los fotogramas reales del video de control, los fotogramas sobrantes pueden mostrar escenas que no se ajustan a las condiciones de control. Abordaremos este problema en [Flujo de trabajo con nodos personalizados](#flujo-de-trabajo-con-nodos-personalizados)
-- Evita establecer dimensiones demasiado grandes, ya que esto puede hacer que el muestreo sea muy lento. Prueba primero con imágenes más pequeñas y luego haz upscale
+- Como debemos introducir en el nodo `WanFunControlToVideo` el mismo número de fotogramas que tiene el video de control, si la cantidad de fotogramas especificada supera la del video de control real, los fotogramas sobrantes pueden mostrar escenas que no se ajustan a las condiciones de control. Abordaremos este problema en [Flujo de trabajo con nodos personalizados](#flujo-de-trabajo-con-nodos-personalizados)
+- Evita establecer dimensiones demasiado grandes, ya que esto puede hacer que el muestreo lleve mucho tiempo. Prueba a generar primero imágenes más pequeñas y luego escálalas
- Usa tu imaginación para ampliar este flujo de trabajo añadiendo flujos de texto a imagen u otros tipos, y lograr así generación directa de texto a video o transferencia de estilo
-- Usa herramientas como [ComfyUI-comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux) para obtener opciones de control más ricas
+- Usa herramientas como [ComfyUI-comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux) para tener opciones de control más variadas
-## Flujo de trabajo con nodos personalizados
+## Flujo de trabajo con Nodos Personalizados
-Necesitaremos instalar los siguientes dos nodos personalizados:
+Necesitas instalar los siguientes dos nodos personalizados:
-- [ComfyUI-VideoHelperSuite](https://github.com/Kosinkadink/ComfyUI-VideoHelperSuite)
+- [ComfyUI-VideoHelperSuite](https://github.com/Kosinkadink/ComfyUI-VideoHelperSuite)
- [ComfyUI-comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux)
-Puedes usar [ComfyUI Manager](https://github.com/Comfy-Org/ComfyUI-Manager) para instalar los nodos faltantes o seguir las instrucciones de instalación de cada paquete de nodos personalizados.
+Puedes usar [ComfyUI Manager](https://github.com/Comfy-Org/ComfyUI-Manager) para instalar nodos faltantes o seguir las instrucciones de instalación de cada paquete de nodos personalizados.
### 1. Descargar el archivo del flujo de trabajo
-
+
- Abrir en Comfy Cloud
+ Open in Comfy Cloud
- Descarga el JSON o busca "Wan 2.1 ControlNet" en la biblioteca de plantillas
+ Descarga el JSON o busca “Wan 2.1 ControlNet” en la Biblioteca de plantillas
@@ -188,7 +190,7 @@ Puedes usar [ComfyUI Manager](https://github.com/Comfy-Org/ComfyUI-Manager) para
- Fotograma inicial de entrada para el flujo de trabajo con nodos personalizados. Descarga y usa esta imagen, o reemplázala por una propia.
+ Fotograma inicial de entrada para el flujo de trabajo con nodos personalizados. Descarga y usa esta imagen, o reemplázala por la tuya.
Video de control de entrada en formato MP4 para el flujo de trabajo con nodos personalizados. El nodo personalizado Load Video admite el formato mp4.
@@ -197,18 +199,18 @@ Puedes usar [ComfyUI Manager](https://github.com/Comfy-Org/ComfyUI-Manager) para
### 2. Completar el flujo de trabajo paso a paso
-
+
-> La parte del modelo es esencialmente la misma. Si ya probaste el flujo de trabajo solo con nodos nativos, puedes subir directamente las imágenes correspondientes y ejecutarlo.
+> La parte de los modelos es prácticamente la misma. Si ya probaste el flujo de trabajo con nodos nativos, puedes subir directamente las imágenes correspondientes y ejecutarlo.
-1. Asegúrate de que el nodo `Load Diffusion Model` haya cargado `wan2.1_fun_control_1.3B_bf16.safetensors`
-2. Asegúrate de que el nodo `Load CLIP` haya cargado `umt5_xxl_fp8_e4m3fn_scaled.safetensors`
-3. Asegúrate de que el nodo `Load VAE` haya cargado `wan_2.1_vae.safetensors`
-4. Asegúrate de que el nodo `Load CLIP Vision` haya cargado `clip_vision_h.safetensors`
+1. Asegúrate de que el nodo `Load Diffusion Model` tenga cargado `wan2.1_fun_control_1.3B_bf16.safetensors`
+2. Asegúrate de que el nodo `Load CLIP` tenga cargado `umt5_xxl_fp8_e4m3fn_scaled.safetensors`
+3. Asegúrate de que el nodo `Load VAE` tenga cargado `wan_2.1_vae.safetensors`
+4. Asegúrate de que el nodo `Load CLIP Vision` tenga cargado `clip_vision_h.safetensors`
5. Sube el fotograma inicial al nodo `Load Image`
6. Sube un video en formato mp4 al nodo personalizado `Load Video(Upload)`. Ten en cuenta que el flujo de trabajo ha ajustado el `frame_load_cap` predeterminado
-7. Para la imagen actual, el `DWPose Estimator` solo usa la opción `detect_face`
-8. (Opcional) Modifica el prompt (se admiten tanto inglés como chino)
+7. Para la imagen actual, `DWPose Estimator` solo usa la opción `detect_face`
+8. (Opcional) Modifica el prompt (se admiten inglés y chino)
9. (Opcional) Ajusta el tamaño del video en `WanFunControlToVideo`, evitando dimensiones demasiado grandes
10. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video
@@ -216,7 +218,7 @@ Puedes usar [ComfyUI Manager](https://github.com/Comfy-Org/ComfyUI-Manager) para
Gracias a los autores de la comunidad de ComfyUI por sus paquetes de nodos personalizados:
- Este ejemplo usa `Load Video(Upload)` para admitir videos mp4
-- El `video_info` que se obtiene de `Load Video(Upload)` nos permite mantener los mismos `fps` en el video de salida
+- El `video_info` que se obtiene de `Load Video(Upload)` permite mantener el mismo `fps` en el video de salida
- Puedes reemplazar `DWPose Estimator` por otros preprocesadores del paquete de nodos `ComfyUI-comfyui_controlnet_aux`
- Los prompts admiten varios idiomas
@@ -224,10 +226,10 @@ Gracias a los autores de la comunidad de ComfyUI por sus paquetes de nodos perso

-- Un consejo útil es que puedes combinar varias técnicas de preprocesamiento de imágenes y luego usar el nodo `Image Blend` para lograr el objetivo de aplicar varios métodos de control al mismo tiempo.
-- Puedes usar el nodo `Video Combine` de `ComfyUI-VideoHelperSuite` para guardar videos en formato mp4
-- Usamos `SaveAnimatedWEBP` porque actualmente no admitimos incrustar el flujo de trabajo en **mp4** y algunos Nodos personalizados también pueden no admitir la incrustación del flujo de trabajo. Para conservar el flujo de trabajo en el video, elegimos el nodo `SaveAnimatedWEBP`.
-- En el nodo `WanFunControlToVideo`, `control_video` no es obligatorio, así que a veces puedes Saltar el uso de un video de control, primero Generar un video de tamaño muy pequeño como 320x320 y luego usarlo como Entrada de video de control para lograr resultados consistentes.
+- Un consejo útil: puedes combinar varias técnicas de preprocesamiento de imágenes y luego usar el nodo `Image Blend` para aplicar varios métodos de control al mismo tiempo.
+- Puedes usar el nodo `Video Combine` de `ComfyUI-VideoHelperSuite` para guardar videos en formato mp4.
+- Usamos `SaveAnimatedWEBP` porque actualmente no admitimos incrustar el flujo de trabajo en **mp4** y es posible que algunos nodos personalizados tampoco lo admitan. Para conservar el flujo de trabajo en el video, elegimos el nodo `SaveAnimatedWEBP`.
+- En el nodo `WanFunControlToVideo`, `control_video` no es obligatorio, así que a veces puedes omitir el video de control: primero genera un video de tamaño muy pequeño, como 320x320, y luego úsalo como entrada de video de control para obtener resultados consistentes.
- [ComfyUI-WanVideoWrapper](https://github.com/kijai/ComfyUI-WanVideoWrapper)
- [ComfyUI-KJNodes](https://github.com/kijai/ComfyUI-KJNodes)
diff --git a/es/tutorials/video/wan/wan-animate-2.mdx b/es/tutorials/video/wan/wan-animate-2.mdx
index 07a6b5786a..b8136aa32c 100644
--- a/es/tutorials/video/wan/wan-animate-2.mdx
+++ b/es/tutorials/video/wan/wan-animate-2.mdx
@@ -2,17 +2,19 @@
title: "Wan Animate 2: transferencia de movimiento"
description: "Anima un personaje estático con Wan Animate 2 en ComfyUI: transfiere el movimiento desde un video guía directamente, sin extracción de poses ni preprocesamiento de esqueleto."
sidebarTitle: "Wan Animate 2"
-translationSourceHash: ae4a191b
+translationSourceHash: 3eded645
translationFrom: tutorials/video/wan/wan-animate-2.mdx
translationBlockHashes:
"_intro": 358b6914
"Model Highlights": ab20a214
+ "Wan Animate 2 workflow": c684e48e
---
+
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
-Wan Animate 2 es un framework de animación de personajes de extremo a extremo del equipo de Wan que consume directamente videos guía en un Diffusion Transformer rediseñado. Logra una generación de movimiento de alta fidelidad y una fuerte preservación de la identidad al eliminar los extractores de movimiento intermedios: no se necesita extracción de pose ni preprocesamiento de esqueletos.
+Wan Animate 2 es un framework de animación de personajes de extremo a extremo del equipo de Wan que consume directamente videos de referencia en un Diffusion Transformer rediseñado. Logra una generación de movimiento de alta fidelidad y una fuerte preservación de la identidad al eliminar los extractores de movimiento intermedios: no se necesita extracción de pose ni preprocesamiento de esqueletos.
-El modelo también añade control de perspectiva impulsado por texto, lo que desacopla la perspectiva de la cámara de salida del video de conducción. Esto te permite animar a un personaje estático usando un video de conducción mientras controlas la cámara de forma independiente, e incluso generar un fondo nuevo a partir de tu prompt de texto.
+El modelo también añade control de punto de vista impulsado por texto, lo que desacopla la perspectiva de la cámara de salida del video de referencia. Esto te permite animar un personaje estático usando un video de referencia mientras controlas la cámara de forma independiente, e incluso generar un fondo nuevo a partir de tu prompt de texto.
- Descarga el JSON o busca "Wan Animate 2" en la Biblioteca de plantillas
+ Descarga el JSON o busca "Wan Animate 2" en la biblioteca de plantillas
@@ -45,38 +47,38 @@ Sube estos archivos a los nodos correspondientes:
- Nodo `LoadImage`: pink_hair_mech_arms_ref.png (el personaje que se va a animar)
+ Nodo `LoadImage`: pink_hair_mech_arms_ref.png (el personaje a animar)
Nodo `LoadVideo`: street_dance_drive.mp4 (la fuente del movimiento)
-### Descarga de modelos
+### Descargas de modelos
-Este flujo de trabajo usa el modelo de difusión `wan_animate_2_int8_convrot.safetensors`. El repositorio también incluye variantes BF16 y destiladas; si prefieres usarlas, cambia la selección de modelo en el nodo `UNETLoader`. Todos los archivos están disponibles en el repositorio [Comfy-Org/Wan-Animate-2](https://huggingface.co/Comfy-Org/Wan-Animate-2):
+Este flujo de trabajo usa el modelo de difusión `wan_animate_2_int8_convrot.safetensors`. El repositorio también incluye variantes BF16 y destiladas; si quieres usar esas en su lugar, cambia la selección de modelo en el nodo `UNETLoader`. Todos los archivos están disponibles en el repositorio [Comfy-Org/Wan-Animate-2](https://huggingface.co/Comfy-Org/Wan-Animate-2):
-
- wan_animate_2_int8_convrot.safetensors: Modelo de difusión cuantizado INT8 convrot que usa este flujo de trabajo
+
+ wan_animate_2_int8_convrot.safetensors: modelo de difusión cuantizado INT8 convrot que usa este flujo de trabajo
- wan_animate_2_bf16.safetensors: Modelo base de precisión completa. Requiere cambiar la selección de modelo en UNETLoader.
+ wan_animate_2_bf16.safetensors: modelo base de precisión completa. Requiere cambiar la selección de modelo en UNETLoader.
-
- wan_animate_2_distill_int8_convrot.safetensors: Variante INT8 destilada. Requiere cambiar la selección de modelo en UNETLoader.
+
+ wan_animate_2_distill_int8_convrot.safetensors: variante INT8 destilada. Requiere cambiar la selección de modelo en UNETLoader.
-
- wan_animate_2_distill_bf16.safetensors: Variante BF16 destilada. Requiere cambiar la selección de modelo en UNETLoader.
+
+ wan_animate_2_distill_bf16.safetensors: variante BF16 destilada. Requiere cambiar la selección de modelo en UNETLoader.
lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors: LoRA de aceleración LightX2V
- umt5_xxl_fp8_e4m3fn_scaled.safetensors: Codificador de texto UMT5-XXL FP8
+ umt5_xxl_fp8_e4m3fn_scaled.safetensors: codificador de texto UMT5-XXL FP8
- clip_vision_h.safetensors: Codificador CLIP Vision
+ clip_vision_h.safetensors: codificador CLIP Vision
Wan2_1_VAE_bf16.safetensors: VAE de Wan2.1 para codificar y decodificar
@@ -105,20 +107,21 @@ Coloca los archivos en los siguientes directorios:
### Instrucciones del flujo de trabajo
-1. Asegúrate de que todos los modelos se cargan correctamente
+1. Asegúrate de que todos los modelos se carguen correctamente
2. Sube la imagen de referencia: el personaje de esta imagen es el personaje objetivo que se va a animar
-3. Sube el video guía: su movimiento se transfiere al personaje de referencia
+3. Sube el video de conducción: su movimiento se transfiere al personaje de referencia
4. Actualiza el prompt para describir la escena, el fondo y el movimiento de cámara que quieres
5. Haz clic en `Run` o usa el atajo `Ctrl(cmd) + Enter` para generar el video
### Extender a videos más largos
-Los videos más largos se gestionan dentro del flujo de trabajo: el Subgraph `Motion Transfer (Wan Animate 2)` itera (`StartLoop` / `EndLoop`) y sigue generando hasta cubrir todo el video guía, así que con un solo Subgraph es suficiente. No hay que duplicar ni recablear nada.
+Los videos más largos se manejan dentro del flujo de trabajo: el subgrafo `Motion Transfer (Wan Animate 2)` hace un bucle (`StartLoop` / `EndLoop`) y sigue generando hasta cubrir todo el video de origen, así que con un solo subgrafo basta. No hay que duplicar ni recablear nada.
+
+Cada iteración del bucle genera 81 fotogramas, unos 3.4 segundos a 24 fps. Ese es el valor de `Int (fragment_length)` dentro del subgrafo. Puedes aumentarlo, pero debe seguir siendo una longitud válida de Wan: 81, 85, 89, etcétera, es decir, `4n + 1`.
-Cada iteración del bucle genera 81 fotogramas, unos 3.4 segundos a 24 fps. Ese es el valor `Int (fragment_length)` dentro del Subgraph. Puedes aumentarlo, pero debe mantenerse en una longitud válida de Wan: 81, 85, 89, etcétera, es decir, `4n + 1`.
+El cálculo del bucle lee la cantidad de fotogramas del video de origen, determina cuántas continuaciones hacen falta y recorta el final para que la salida tenga exactamente la misma cantidad de fotogramas que el video de origen. Cada continuación repite el último fotograma del segmento anterior y ese duplicado se elimina, así que cada segmento adicional añade `fragment_length - 1` fotogramas nuevos.
-El cálculo del bucle lee el número de fotogramas del video guía, determina cuántas continuaciones hacen falta y recorta el final para que la salida tenga exactamente los mismos fotogramas que el video guía. Cada continuación repite el último fotograma del segmento anterior y ese duplicado se elimina, así que cada segmento adicional añade `fragment_length - 1` fotogramas nuevos.
+El bucle usa los nodos de bucle del núcleo, así que el flujo de trabajo necesita ComfyUI 0.36.0 o posterior.
-El bucle usa los nodos de bucle del núcleo, así que el flujo de trabajo necesita ComfyUI 0.36.0 o superior.
+El subgrafo `Video Stitch` es la vista previa comparativa: coloca el video generado junto al video de origen. No forma parte del proceso de extensión.
-El Subgraph `Video Stitch` es la vista previa comparativa: coloca el video generado junto al video guía. No forma parte de la ruta de extensión.
diff --git a/es/tutorials/video/wan/wan-causal-forcing.mdx b/es/tutorials/video/wan/wan-causal-forcing.mdx
index 342ce69dae..271280192a 100644
--- a/es/tutorials/video/wan/wan-causal-forcing.mdx
+++ b/es/tutorials/video/wan/wan-causal-forcing.mdx
@@ -2,17 +2,19 @@
title: "Causal Forcing en ComfyUI: imagen a video con Wan2.1 en 1 a 4 pasos"
description: "Genera video temporalmente consistente desde una sola imagen en ComfyUI con Causal Forcing o Causal Forcing++ sobre Wan2.1, usando tan solo 1 a 4 pasos."
sidebarTitle: "Causal Forcing I2V"
-translationSourceHash: 4cd31faf
+translationSourceHash: e94bf5dc
translationFrom: tutorials/video/wan/wan-causal-forcing.mdx
translationBlockHashes:
"_intro": 3da76367
"How it works": a3348b35
"Using the workflow": 5e6245a2
"Steps to run": 3202924b
+ "Model downloads": c6ce079e
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-**Causal Forcing** es una técnica de generación de video que aplica **conditioning recurrente** durante la inferencia, en la que cada fotograma generado se devuelve al modelo para predecir el siguiente fotograma. Así se obtienen videos suaves y coherentes en el tiempo a partir de una sola imagen inicial en tan solo **1 a 4 pasos de inferencia**.
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
+
+**Causal Forcing** es una técnica de generación de video que aplica **acondicionamiento recurrente** durante la inferencia, donde cada fotograma generado se devuelve al modelo para predecir el siguiente fotograma. Esto produce videos suaves y coherentes en el tiempo a partir de una sola imagen inicial en tan solo **1 a 4 pasos de inferencia**.
Este flujo de trabajo usa **Wan2.1** y admite tanto el modo **Causal Forcing** (estándar) como **Causal Forcing++** (mejorado).
@@ -33,7 +35,7 @@ Este flujo de trabajo usa **Wan2.1** y admite tanto el modo **Causal Forcing** (
- Imagen de entrada para el primer fotograma. Descárgala y úsala, o reemplázala por una tuya.
+ Imagen de entrada para el primer fotograma. Descarga y usa esta imagen, o reemplázala con una tuya.
@@ -48,15 +50,15 @@ A diferencia de la generación de video estándar, que procesa todos los fotogra
Este enfoque recurrente crea una **fuerte consistencia temporal**: cada fotograma surge de forma natural del anterior. Esto puede producir resultados de alta calidad con muy pocos pasos de inferencia (de 1 a 4).
-
+
Este flujo de trabajo usa un nodo Subgraph para el procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y extender el flujo de trabajo.
### Causal Forcing vs Causal Forcing++
| Modo | Descripción |
|---|---|
-| **Causal Forcing** | conditioning recurrente estándar. Buena calidad con 2–4 pasos. |
-| **Causal Forcing++** | Modo mejorado que aplica conditioning adicional para una mejor coherencia temporal. Funciona bien con solo 1–2 pasos. |
+| **Causal Forcing** | Acondicionamiento recurrente estándar. Buena calidad con 2–4 pasos. |
+| **Causal Forcing++** | Modo mejorado que aplica acondicionamiento adicional para una mejor coherencia temporal. Funciona bien con solo 1–2 pasos. |
## Usar el flujo de trabajo
@@ -67,12 +69,12 @@ El flujo de trabajo acepta una sola imagen de entrada (el primer fotograma) y un
| Ajuste | Descripción |
|---|---|
| **first_frame** (requerido) | La imagen inicial del video. Carga un PNG/JPG con el nodo **LoadImage**. |
-| **positive_prompt** (opcional) | Una descripción de texto del contenido de video deseado. Déjalo vacío para no aplicar conditioning. |
+| **positive_prompt** (opcional) | Una descripción de texto del contenido de video deseado. Déjalo vacío para no aplicar acondicionamiento. |
| **duration** (opcional) | El número de fotogramas a generar. Predeterminado: el número de fotogramas de la salida esperada del modelo. |
### Parámetros del subgrafo WAN I2V
-Se exponen como controles en el nodo del subgrafo del plano:
+El nodo del subgrafo del plano los expone como controles:
| Parámetro | Predeterminado | Descripción |
|---|---|---|
@@ -86,15 +88,15 @@ Se exponen como controles en el nodo del subgrafo del plano:
## Pasos para ejecutar
1. **Carga una imagen**: usa el nodo **LoadImage** para cargar tu fotograma inicial
-2. **Escribe un prompt** (opcional): describe el contenido de video que deseas
+2. **Escribe un prompt** (opcional): describe el contenido del video que deseas
3. **Establece la duración**: cuántos fotogramas generar
4. **Selecciona los modelos**: elige el checkpoint, CLIP y VAE de Wan2.1 I2V
5. **Elige el modo**: Causal Forcing o Causal Forcing++ (configúralo mediante la configuración interna del subgrafo o una entrada específica de Causal Forcing si está disponible)
6. **Ejecuta**: los fotogramas se generarán de forma secuencial y se guardarán en `ComfyUI/output/`
-## Descarga de modelos
+## Descargas de modelos
-Descarga el modelo Wan2.1 I2V y los archivos necesarios. Colócalos en los subdirectorios correspondientes de `models/`.
+Descarga el modelo Wan2.1 I2V y los archivos requeridos. Colócalos en las subcarpetas correspondientes de `models/`.
### Wan2.1 I2V
@@ -118,7 +120,7 @@ Descarga el modelo Wan2.1 I2V y los archivos necesarios. Colócalos en los subdi
-### Ubicación de almacenamiento de modelos
+### Ubicación de almacenamiento de los modelos
```
📂 ComfyUI/
@@ -130,3 +132,4 @@ Descarga el modelo Wan2.1 I2V y los archivos necesarios. Colócalos en los subdi
│ └── 📂 vae/
│ └── Wan2.1_VAE_bf16.safetensors
```
+
diff --git a/es/tutorials/video/wan/wan-move.mdx b/es/tutorials/video/wan/wan-move.mdx
index 205659fc86..9f5a576d9a 100644
--- a/es/tutorials/video/wan/wan-move.mdx
+++ b/es/tutorials/video/wan/wan-move.mdx
@@ -2,26 +2,28 @@
title: "Ejemplo de flujo de trabajo Wan-Move en ComfyUI"
description: "Genera video con movimiento controlable usando Wan-Move en ComfyUI: guía el movimiento de objetos con trayectorias de puntos para imagen a video."
sidebarTitle: "Wan-Move"
-translationSourceHash: 78cfc130
+translationSourceHash: 6e632abd
translationFrom: tutorials/video/wan/wan-move.mdx
translationBlockHashes:
"_intro": 67a26359
"Wan-Move image-to-video workflow": 78aef00b
+ "Model links": 8e0ef166
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-**Wan-Move** es un framework de generación de video con control de movimiento desarrollado por Tongyi Lab de Alibaba. Permite controlar el movimiento de los objetos en los videos generados especificando trayectorias de puntos sobre la imagen de entrada, lo que hace que la generación de imagen a video sea más precisa y controlable.
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
+
+**Wan-Move** es un framework de generación de video con control de movimiento desarrollado por Tongyi Lab de Alibaba. Te permite controlar el movimiento de los objetos en los videos generados especificando trayectorias de puntos sobre la imagen de entrada, lo que hace que la generación de imagen a video sea más precisa y controlable.
**Características principales**:
-- **Control de movimiento en 480p y 5 s de alta calidad**: genera videos de 5 segundos en 480p con una controlabilidad de movimiento de grano fino
-- **Orientación por trayectorias latent**: representa las condiciones de movimiento propagando las características del primer fotograma a lo largo de las trayectorias
-- **Control de grano fino a nivel puntual**: los movimientos de los objetos se representan con trayectorias de puntos densas, lo que permite un control preciso a nivel de región
+- **Control de movimiento de alta calidad en 5 s y 480p**: genera videos de 5 segundos en 480p con una controlabilidad de movimiento de grano fino
+- **Orientación por trayectorias latentes**: representa las condiciones de movimiento propagando las características del primer fotograma a lo largo de las trayectorias
+- **Control de grano fino a nivel puntual**: el movimiento de los objetos se representa con trayectorias de puntos densas, lo que permite un control preciso a nivel de región
- **Sin cambios en la arquitectura**: se integra sin problemas en Wan-I2V-14B sin módulos de movimiento adicionales
**Enlaces relacionados**:
- [GitHub](https://github.com/ali-vilab/Wan-Move)
- [Hugging Face](https://huggingface.co/Ruihang/Wan-Move-14B-480P)
-- [Paper](https://arxiv.org/abs/2512.08765)
+- [Artículo](https://arxiv.org/abs/2512.08765)
## Flujo de trabajo de imagen a video Wan-Move
@@ -58,23 +60,23 @@ Sube este archivo al nodo `LoadImage` correspondiente:
- Colócalo en
- Colócalo en
-
- Colócalo en
+ Coloca el archivo en
- Colócalo en
- Colócalo en
-**Ubicación de almacenamiento de modelos**
+**Ubicación de almacenamiento de los modelos**
```
📂 ComfyUI/
@@ -90,3 +92,4 @@ Sube este archivo al nodo `LoadImage` correspondiente:
│ └── 📂 vae/
│ └── wan_2.1_vae.safetensors
```
+
diff --git a/es/tutorials/video/wan/wan2-2-animate.mdx b/es/tutorials/video/wan/wan2-2-animate.mdx
index 655eded00d..874b81e393 100644
--- a/es/tutorials/video/wan/wan2-2-animate.mdx
+++ b/es/tutorials/video/wan/wan2-2-animate.mdx
@@ -2,20 +2,22 @@
title: "Flujo de trabajo nativo de ComfyUI para Wan2.2 Animate"
description: "Marco unificado de animación y reemplazo de personajes con replicación precisa de movimiento y expresión."
sidebarTitle: "Wan2.2 Animate"
-translationSourceHash: f66a9a5c
+translationSourceHash: 081a4697
translationFrom: tutorials/video/wan/wan2-2-animate.mdx
translationBlockHashes:
"_intro": 96eb0424
"Model Highlights": fc4e7349
"ComfyOrg Wan2.2 Animate stream replay": a43ba31b
+ "About Wan2.2 Animate workflow": 71233e1e
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-Wan-Animate es un marco unificado para animar y reemplazar personajes, desarrollado por el equipo de WAN.
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
+
+Wan-Animate es un marco unificado para la animación y el reemplazo de personajes, desarrollado por el equipo de WAN.
El modelo puede animar cualquier personaje a partir del video de un intérprete, replicando con precisión sus expresiones faciales y sus movimientos para generar videos de personajes muy realistas.
-También puede reemplazar los personajes de un video por personajes animados, conservando sus expresiones y movimientos y replicando la iluminación y el tono de color originales para lograr una integración perfecta con el entorno.
+También puede reemplazar los personajes de un video por personajes animados, conservando sus expresiones y movimientos y replicando la iluminación y el tono de color originales para una integración fluida con el entorno.
## Aspectos destacados del modelo
@@ -23,7 +25,7 @@ También puede reemplazar los personajes de un video por personajes animados, co
- Control avanzado del movimiento corporal: utiliza señales de esqueleto alineadas espacialmente para replicar con precisión el movimiento del cuerpo.
- Movimiento y expresión precisos: reproduce con exactitud los movimientos y las expresiones faciales del video de referencia.
- Integración natural con el entorno: combina a la perfección el personaje reemplazado con el entorno del video original.
-- Generación fluida de videos largos: la generación iterativa garantiza un movimiento y un flujo visual consistentes en videos extensos.
+- Generación fluida de videos largos: la generación iterativa garantiza un movimiento y un flujo visual constantes en videos extensos.
## Repetición del stream de ComfyOrg Wan2.2 Animate
@@ -38,15 +40,15 @@ También puede reemplazar los personajes de un video por personajes animados, co
 +
@@ -63,10 +65,10 @@ Sube estos archivos a los nodos correspondientes:
- `LoadImage` nodo 10 · `video_wan2_2_14B_animate_reference_image.png`
+ Nodo `LoadImage` 10 · `video_wan2_2_14B_animate_reference_image.png`
- `LoadVideo` nodo 145 · `video_wan2_2_14B_animate_original_video.mp4`
+ Nodo `LoadVideo` 145 · `video_wan2_2_14B_animate_original_video.mp4`
@@ -76,23 +78,23 @@ Sube estos archivos a los nodos correspondientes:
### 2. Enlaces de modelos
-Todos los modelos que se usan en esta guía están [aquí](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/tree/main/split_files).
+Todos los modelos que se usan en esta guía están disponibles [aquí](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/tree/main/split_files).
**Modelos de difusión**
- Wan2_2-Animate-14B_fp8_e4m3fn_scaled_KJ.safetensors: Versión FP8 escalada del repositorio de Kijai
+ Wan2_2-Animate-14B_fp8_e4m3fn_scaled_KJ.safetensors: versión FP8 escalada del repositorio de Kijai
- wan2.2_animate_14B_bf16.safetensors: Pesos originales del modelo en bf16
+ wan2.2_animate_14B_bf16.safetensors: pesos originales del modelo en bf16
**CLIP Vision**
- clip_vision_h.safetensors: Codificador CLIP Vision
+ clip_vision_h.safetensors: codificador CLIP Vision
**LoRAs**
@@ -107,7 +109,7 @@ Todos los modelos que se usan en esta guía están [aquí](https://huggingface.c
**Codificadores de texto**
- umt5_xxl_fp8_e4m3fn_scaled.safetensors: Codificador de texto FP8 escalado
+ umt5_xxl_fp8_e4m3fn_scaled.safetensors: codificador de texto FP8 escalado
```
ComfyUI/
@@ -125,11 +127,11 @@ ComfyUI/
│ └── wan_2.1_vae.safetensors
```
-### 3. Instala los nodos personalizados
+### 3. Instalar nodos personalizados
-Descarga el siguiente archivo de flujo de trabajo y arrástralo a ComfyUI para cargarlo; si tienes instalado [ComfyUI-Manager](https://github.com/Comfy-Org/ComfyUI-Manager), basta con hacer clic en el botón `Install missing nodes` para instalar los nodos que falten.
+Descarga el siguiente archivo de flujo de trabajo y arrástralo a ComfyUI para cargar el flujo de trabajo. Si tienes [ComfyUI-Manager](https://github.com/Comfy-Org/ComfyUI-Manager) instalado, puedes hacer clic en el botón `Install missing nodes` para instalar los nodos faltantes.
-Necesitamos instalar los siguientes nodos personalizados:
+Necesitas instalar los siguientes nodos personalizados:
- [ComfyUI-KJNodes](https://github.com/kijai/ComfyUI-KJNodes)
- [ComfyUI-comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux)
@@ -138,30 +140,31 @@ Si no sabes cómo instalar nodos personalizados, consulta [Cómo instalar nodos
### 4. Instrucciones del flujo de trabajo
-Wan2.2 Animate tiene dos modos: Mix y Move
-- Mix: usa la imagen de referencia para reemplazar el personaje del video
-- Move: usa el movimiento del personaje del video de entrada para animar el personaje de la imagen de referencia (como en Wan2.2 Fun Control)
+Wan2.2 Animate tiene dos modos: Mix y Move.
+- Mix: usa la imagen de referencia para reemplazar al personaje en el video.
+- Move: usa el movimiento del personaje del video de entrada para animar al personaje de la imagen de referencia (como en Wan2.2 Fun Control).
#### 4.1 Modo Mix
-
-
-0. Si es la primera vez que ejecutas este flujo de trabajo, usa un tamaño pequeño para la generación de video, por si no tienes suficiente VRAM para ejecutarlo; además, por la limitación de `WanAnimateToVideo`, el ancho y el alto del video deben ser múltiplos de 16.
-1. Asegúrate de que todos los modelos se cargan correctamente
-2. Actualiza el prompt si quieres
-3. Sube la imagen de referencia: el personaje de esta imagen será el personaje objetivo
-4. La primera vez puedes usar los videos que proporcionamos como videos de entrada; el nodo **DWPose Estimator** de [comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux) preprocesará el video de entrada para obtener videos de control de pose y de rostro
-5. El nodo `Points Editor` viene de [KJNodes](https://github.com/kijai/ComfyUI-KJNodes/); por defecto no carga el primer fotograma del video de entrada, así que debes ejecutar el flujo de trabajo una vez o subir el primer fotograma manualmente
- - Debajo del nodo `Points Editor` hemos añadido una nota sobre cómo funciona este nodo y cómo editarlo. Consúltala
-6. El grupo "Video Extend" sirve para ampliar la duración del video de salida
- - Cada `Video Extend` amplía otros 77 fotogramas (alrededor de 4.8125 segundos)
- - Si tu video de entrada dura menos de 5 s, puede que no lo necesites
- - Si quieres ampliar más, tienes que copiar y pegar varias veces y enlazar el `batch_images` del último Video Extend con el siguiente, y también el `video_frame_offset` del último Video Extend con el siguiente
-7. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación del video
+
+
+0. Si ejecutas este flujo de trabajo por primera vez, usa un tamaño pequeño para la generación de video, en caso de que no tengas suficiente VRAM para ejecutarlo y, debido a la limitación de `WanAnimateToVideo`, el ancho o el alto del video deben ser múltiplos de 16.
+1. Asegúrate de que todos los modelos estén cargados correctamente.
+2. Actualiza el prompt si quieres.
+3. Sube la imagen de referencia; el personaje de esta imagen será el personaje objetivo.
+4. Puedes usar los videos que proporcionamos como videos de entrada la primera vez; el nodo **DWPose Estimator** en [comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux) preprocesará el video de entrada para obtener videos de control de pose y rostro.
+5. El `Points Editor` es de [KJNodes](https://github.com/kijai/ComfyUI-KJNodes/); de forma predeterminada, este nodo no cargará el primer fotograma del video de entrada, por lo que debes ejecutar el flujo de trabajo una vez o subir el primer fotograma manualmente.
+ - Debajo del nodo `Points Editor`, hemos añadido una nota sobre cómo funciona este nodo y cómo editarlo. Consúltala.
+6. El grupo "Video Extend" sirve para extender la duración del video de salida.
+ - Cada `Video Extend` extenderá otros 77 fotogramas (alrededor de 4.8125 segundos).
+ - Si tu video de entrada dura menos de 5s, es posible que no lo necesites.
+ - Si quieres extenderlo más, debes copiar y pegar varias veces; debes conectar el `batch_images` del último Video Extend con el siguiente, y también el `video_frame_offset` del último Video Extend con el siguiente.
+7. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video.
#### 4.2 Modo Move
-Usamos [Subgraph](/es/interface/features/subgraph) en el flujo de trabajo de Wan2.2 Animate; así es como se cambia al modo Move:
+Usamos [subgraph](/es/interface/features/subgraph) en el flujo de trabajo Wan2.2 Animate; así puedes cambiar al modo Move:

Si quieres cambiar al modo Move, puedes desconectar las entradas `background_video` y `character_mask` del nodo `Video Sampling and output(Subgraph)`.
+
diff --git a/es/tutorials/video/wan/wan2-2-fun-control.mdx b/es/tutorials/video/wan/wan2-2-fun-control.mdx
index 3947252f37..58ab19287e 100644
--- a/es/tutorials/video/wan/wan2-2-fun-control.mdx
+++ b/es/tutorials/video/wan/wan2-2-fun-control.mdx
@@ -2,22 +2,24 @@
title: "Wan2.2 Fun Control en ComfyUI: generación de video con control"
description: "Ejecuta el flujo de trabajo Wan2.2 Fun Control 14B en ComfyUI para generar video guiado por un video de control, con modelos de alto y bajo ruido y LoRAs de 4 pasos."
sidebarTitle: "Wan2.2 Fun Control"
-translationSourceHash: 5fe96707
+translationSourceHash: 713ec1d8
translationFrom: tutorials/video/wan/wan2-2-fun-control.mdx
translationBlockHashes:
"_intro": 239e24b6
"ComfyOrg Wan2.2 Fun InP & Control Youtube Live Stream Replay": 22557a2e
+ "Wan2.2 Fun Control Video Generation Workflow Example": 0a502468
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-**Wan2.2-Fun-Control** es un modelo de generación y control de video de nueva generación lanzado por el equipo de Alibaba PAI. Mediante un innovador mecanismo de Control Codes combinado con aprendizaje profundo y entradas condicionales multimodales, puede generar videos de alta calidad que cumplen con condiciones de control predefinidas. El modelo se publica bajo la **licencia Apache 2.0** y admite uso comercial.
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
+
+**Wan2.2-Fun-Control** es un modelo de generación y control de video de nueva generación lanzado por el equipo de Alibaba PAI. Gracias a un innovador mecanismo de Control Codes combinado con aprendizaje profundo y entradas condicionales multimodales, puede generar videos de alta calidad que respetan las condiciones de control predefinidas. El modelo se publica bajo la **licencia Apache 2.0** y admite uso comercial.
**Características principales**:
- **Control multimodal**: admite varias condiciones de control, como **Canny (arte lineal)**, **Profundidad**, **OpenPose (pose humana)**, **MLSD (bordes geométricos)** y **control de trayectoria**
- **Generación de video de alta calidad**: basado en la arquitectura Wan2.2, produce videos con calidad cinematográfica
- **Compatibilidad con varios idiomas**: admite prompts en varios idiomas, incluidos el chino y el inglés
-A continuación se muestran los pesos del modelo y los repositorios de código relevantes:
+A continuación, los pesos del modelo y los repositorios de código relevantes:
- [🤗Wan2.2-Fun-A14B-Control](https://huggingface.co/alibaba-pai/Wan2.2-Fun-A14B-Control)
- Repositorio de código: [VideoX-Fun](https://github.com/aigc-apps/VideoX-Fun)
@@ -37,23 +39,23 @@ A continuación se muestran los pesos del modelo y los repositorios de código r
 +
@@ -73,42 +75,42 @@ Descarga las siguientes imágenes y videos como materiales de entrada.
Fotograma inicial para la generación del video. Descarga y usa esta imagen, o reemplázala por la tuya.
- Video de control de pose ya preprocesado. Descarga y usa este video, o reemplázalo por el tuyo.
+ Video de control de pose preprocesado. Descarga y usa este video, o reemplázalo por el tuyo.
-> Aquí usamos un video ya preprocesado.
+> Aquí usamos un video preprocesado.
### 2. Modelos
-Todos los modelos que se usan en esta guía están [aquí](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/tree/main/split_files).
+Puedes encontrar todos los modelos de esta guía [aquí](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/tree/main/split_files).
**Modelos de difusión**
- wan2.2_fun_control_high_noise_14B_fp8_scaled.safetensors: Modelo de difusión de alto ruido
+ wan2.2_fun_control_high_noise_14B_fp8_scaled.safetensors: Modelo de difusión de ruido alto
- wan2.2_fun_control_low_noise_14B_fp8_scaled.safetensors: Modelo de difusión de bajo ruido
+ wan2.2_fun_control_low_noise_14B_fp8_scaled.safetensors: Modelo de difusión de ruido bajo
-**LoRA Wan2.2-Lightning (opcional, para acelerar)**
+**LoRA Wan2.2-Lightning (opcional, para aceleración)**
-
- wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors: LoRA de aceleración de 4 pasos para alto ruido
+
+ wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors: LoRA de aceleración de 4 pasos para ruido alto
-
- wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors: LoRA de aceleración de 4 pasos para bajo ruido
+
+ wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors: LoRA de aceleración de 4 pasos para ruido bajo
**VAE**
- wan_2.1_vae.safetensors: VAE de Wan2.1 para codificar y decodificar
+ wan_2.1_vae.safetensors: VAE Wan2.1 para codificar y decodificar
**Codificador de texto**
@@ -132,27 +134,28 @@ ComfyUI/
### 3. Guía del flujo de trabajo
-
+
- Este flujo de trabajo usa LoRA. Asegúrate de que el modelo de difusión y el LoRA correspondientes estén emparejados: los modelos y LoRA de alto ruido y de bajo ruido deben usarse de forma correspondiente.
+ Este flujo de trabajo usa LoRA. Asegúrate de que el modelo de difusión y la LoRA correspondientes coincidan: los modelos y las LoRA de ruido alto y ruido bajo deben usarse de forma correspondiente.
-1. Carga del modelo de **alto ruido** y del **LoRA**
+1. Carga del modelo de **ruido alto** y de la **LoRA**
- Asegúrate de que el nodo `Load Diffusion Model` cargue el modelo `wan2.2_fun_control_high_noise_14B_fp8_scaled.safetensors`
- - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue el `wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors`
-2. Carga del modelo de **bajo ruido** y del **LoRA**
+ - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue `wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors`
+2. Carga del modelo de **ruido bajo** y de la **LoRA**
- Asegúrate de que el nodo `Load Diffusion Model` cargue el modelo `wan2.2_fun_control_low_noise_14B_fp8_scaled.safetensors`
- - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue el `wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors`
+ - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue `wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors`
3. Asegúrate de que el nodo `Load CLIP` cargue el modelo `umt5_xxl_fp8_e4m3fn_scaled.safetensors`
4. Asegúrate de que el nodo `Load VAE` cargue el modelo `wan_2.1_vae.safetensors`
5. Sube el fotograma inicial en el nodo `Load Image`
-6. En el segundo nodo `Load video`, carga el video de control de pose. El video que se proporciona ya está preprocesado y puedes usarlo directamente
-7. Como proporcionamos un video de pose ya preprocesado, hay que desactivar el nodo de preprocesamiento de imagen de video correspondiente. Puedes seleccionarlo y usar `Ctrl + B` para desactivarlo
+6. En el segundo nodo `Load video`, carga el video de control de pose. El video proporcionado ya está preprocesado y puedes usarlo directamente
+7. Dado que proporcionamos un video de pose preprocesado, debes deshabilitar el nodo correspondiente de preprocesamiento de imágenes de video. Puedes seleccionarlo y usar `Ctrl + B` para deshabilitarlo
8. Modifica el prompt: puedes usar tanto chino como inglés
-9. En `Wan22FunControlToVideo`, modifica las dimensiones del video. Por defecto se usa una resolución de 640×640 para evitar tiempos de procesamiento excesivos en equipos con poca VRAM
-10. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter`, para ejecutar la generación del video
+9. En `Wan22FunControlToVideo`, modifica las dimensiones del video. La resolución predeterminada es de 640×640 para evitar tiempos de procesamiento excesivos en usuarios con poca VRAM
+10. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video
### Notas adicionales
-Como los nodos integrados de ComfyUI solo incluyen el preprocesador Canny, puedes usar herramientas como [ComfyUI-comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux) para aplicar otros tipos de preprocesamiento de imagen
+Como los nodos integrados de ComfyUI solo incluyen el preprocesador Canny, puedes usar herramientas como [ComfyUI-comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux) para implementar otros tipos de preprocesamiento de imágenes.
+
diff --git a/es/tutorials/video/wan/wan2-2-fun-inp.mdx b/es/tutorials/video/wan/wan2-2-fun-inp.mdx
index 8b198033cd..55e805e3fc 100644
--- a/es/tutorials/video/wan/wan2-2-fun-inp.mdx
+++ b/es/tutorials/video/wan/wan2-2-fun-inp.mdx
@@ -2,25 +2,27 @@
title: "Wan2.2 Fun InP en ComfyUI: video con fotograma inicial y final"
description: "Ejecuta el flujo de trabajo Wan2.2 Fun InP 14B en ComfyUI para generar video entre un fotograma inicial y uno final, con modelos de alto y bajo ruido y LoRAs Lightning."
sidebarTitle: "Wan2.2 Fun Inp"
-translationSourceHash: 16cf1b1c
+translationSourceHash: ff570640
translationFrom: tutorials/video/wan/wan2-2-fun-inp.mdx
translationBlockHashes:
"_intro": 7a3595d7
"ComfyOrg Wan2.2 Fun InP & Control Youtube Live Stream Replay": 22557a2e
+ "Wan2.2 Fun Inp Start-End Frame Video Generation Workflow Example": bc339657
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-**Wan2.2-Fun-Inp** es un modelo de generación de video controlado por fotograma inicial y final, lanzado por el equipo de Alibaba PAI. Permite introducir **imágenes de fotograma inicial y final** para generar videos con la transición intermedia, lo que brinda a los creadores un mayor control creativo. El modelo se publica bajo la **licencia Apache 2.0** y admite uso comercial.
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
+
+**Wan2.2-Fun-Inp** es un modelo de generación de video controlado por fotograma inicial y final, lanzado por el equipo de Alibaba PAI. Admite la introducción de **imágenes de fotograma inicial y final** para generar videos de transición intermedios, lo que brinda a los creadores un mayor control creativo. El modelo se publica bajo la **licencia Apache 2.0** y permite uso comercial.
**Características principales**:
-- **Control por fotograma inicial y final**: permite introducir imágenes de fotograma inicial y final para generar videos con la transición intermedia, lo que mejora la coherencia del video y la libertad creativa
+- **Control por fotograma inicial y final**: admite la introducción de imágenes de fotograma inicial y final para generar videos de transición intermedios, lo que mejora la coherencia del video y la libertad creativa
- **Generación de video de alta calidad**: basado en la arquitectura Wan2.2, produce videos con calidad de nivel cinematográfico
- **Soporte para múltiples resoluciones**: permite generar videos en 512x512, 768x768, 1024x1024 y otras resoluciones para adaptarse a distintos escenarios
**Versión del modelo**:
- **Versión de alto rendimiento 14B**: el tamaño del modelo supera los 32GB, ofrece mejores resultados pero exige mucha VRAM
-A continuación encontrarás los pesos del modelo y los repositorios de código relevantes:
+A continuación se muestran los pesos del modelo y los repositorios de código correspondientes:
- [🤗Wan2.2-Fun-Inp-14B](https://huggingface.co/alibaba-pai/Wan2.2-Fun-A14B-InP)
- Repositorio de código: [VideoX-Fun](https://github.com/aigc-apps/VideoX-Fun)
@@ -35,30 +37,30 @@ A continuación encontrarás los pesos del modelo y los repositorios de código
allowFullScreen
>
-## Ejemplo de flujo de trabajo de video con fotograma inicial y final de Wan2.2 Fun Inp
+## Ejemplo de flujo de trabajo de generación de video con fotograma inicial y final de Wan2.2 Fun Inp
 +
@@ -75,48 +77,48 @@ Usa los siguientes materiales como fotogramas inicial y final
- Fotograma inicial para la generación del video. Descarga y usa esta imagen, o reemplázala por la tuya.
+ Fotograma inicial para la generación de video. Descarga y usa esta imagen, o reemplázala por una tuya.
- Fotograma final para la generación del video. Descarga y usa esta imagen, o reemplázala por la tuya.
+ Fotograma final para la generación de video. Descarga y usa esta imagen, o reemplázala por una tuya.
### 2. Modelos
-Todos los modelos que se usan en esta guía están [aquí](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/tree/main/split_files).
+Todos los modelos que se usan en esta guía están disponibles [aquí](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/tree/main/split_files).
**Modelos de difusión**
-
- wan2.2_fun_inpaint_high_noise_14B_fp8_scaled.safetensors: Modelo de difusión de alto ruido para inpainting entre fotograma inicial y final
+
+ wan2.2_fun_inpaint_high_noise_14B_fp8_scaled.safetensors: modelo de difusión de ruido alto para relleno inteligente de fotogramas inicial y final
-
- wan2.2_fun_inpaint_low_noise_14B_fp8_scaled.safetensors: Modelo de difusión de bajo ruido para inpainting entre fotograma inicial y final
+
+ wan2.2_fun_inpaint_low_noise_14B_fp8_scaled.safetensors: modelo de difusión de ruido bajo para relleno inteligente de fotogramas inicial y final
-**LoRA Lightning (opcional, para acelerar)**
+**LoRA Lightning (opcional, para aceleración)**
-
- wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors: LoRA de aceleración de 4 pasos para el modelo de alto ruido
+
+ wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors: LoRA de aceleración de 4 pasos para el modelo de ruido alto
-
- wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors: LoRA de aceleración de 4 pasos para el modelo de bajo ruido
+
+ wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors: LoRA de aceleración de 4 pasos para el modelo de ruido bajo
**VAE**
-
- wan_2.1_vae.safetensors: VAE de Wan2.1 para codificar y decodificar
+
+ wan_2.1_vae.safetensors: VAE Wan2.1 para codificar y decodificar
**Codificador de texto**
- umt5_xxl_fp8_e4m3fn_scaled.safetensors: Codificador de texto FP8 escalado
+ umt5_xxl_fp8_e4m3fn_scaled.safetensors: codificador de texto FP8 escalado
```
ComfyUI/
@@ -135,23 +137,24 @@ ComfyUI/
### 3. Guía del flujo de trabajo
-
+
- Este flujo de trabajo usa LoRA. Asegúrate de que el modelo de difusión y el LoRA correspondientes estén emparejados.
+ Este flujo de trabajo usa LoRA. Asegúrate de que el modelo de difusión y la LoRA correspondientes coincidan.
-1. Carga del modelo de **alto ruido** y del **LoRA**
+1. Carga del modelo de **ruido alto** y de **LoRA**
- Asegúrate de que el nodo `Load Diffusion Model` cargue el modelo `wan2.2_fun_inpaint_high_noise_14B_fp8_scaled.safetensors`
- - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue el `wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors`
-2. Carga del modelo de **bajo ruido** y del **LoRA**
+ - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue el archivo `wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors`
+2. Carga del modelo de **ruido bajo** y de **LoRA**
- Asegúrate de que el nodo `Load Diffusion Model` cargue el modelo `wan2.2_fun_inpaint_low_noise_14B_fp8_scaled.safetensors`
- - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue el `wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors`
+ - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue el archivo `wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors`
3. Asegúrate de que el nodo `Load CLIP` cargue el modelo `umt5_xxl_fp8_e4m3fn_scaled.safetensors`
4. Asegúrate de que el nodo `Load VAE` cargue el modelo `wan_2.1_vae.safetensors`
-5. Sube las imágenes de fotograma inicial y final como materiales
-6. Escribe tu prompt en el grupo Prompt
+5. Sube las imágenes del fotograma inicial y del fotograma final como materiales
+6. Introduce tu prompt en el grupo Prompt
7. Ajusta el tamaño y la duración del video en el nodo `WanFunInpaintToVideo`
- - Ajusta los parámetros `width` y `height`. El valor predeterminado es `640`. Nosotros hemos definido un tamaño más pequeño, pero puedes modificarlo según lo necesites.
- - Ajusta `length`, que es el número total de fotogramas. Los fps actuales del flujo de trabajo son 16. Por ejemplo, si quieres generar un video de 5 segundos, debes definirlo en 5*16 = 80.
-8. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter`, para ejecutar la generación del video
+ - Ajusta los parámetros `width` y `height`. El valor predeterminado es `640`. Usamos un tamaño más pequeño, pero puedes modificarlo según tus necesidades.
+ - Ajusta `length`, que es el número total de fotogramas. Los fps del flujo de trabajo actual son 16. Por ejemplo, si quieres generar un video de 5 segundos, debes establecerlo en 5*16 = 80.
+8. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video
+
diff --git a/es/tutorials/video/wan/wan2_2.mdx b/es/tutorials/video/wan/wan2_2.mdx
index f86a0dbe4b..ee8f703de0 100644
--- a/es/tutorials/video/wan/wan2_2.mdx
+++ b/es/tutorials/video/wan/wan2_2.mdx
@@ -2,7 +2,7 @@
title: "Ejemplo de flujo de trabajo nativo oficial de ComfyUI para generación de video con Wan2.2"
description: "Ejecuta flujos de video Wan2.2 en ComfyUI: modelo híbrido TI2V 5B y ejemplos 14B de texto a video, imagen a video y primer/último fotograma, con descargas."
sidebarTitle: Wan2.2
-translationSourceHash: bafc80f0
+translationSourceHash: 49dd13ed
translationFrom: tutorials/video/wan/wan2_2.mdx
translationBlockHashes:
"_intro": 3d02f6d3
@@ -10,11 +10,13 @@ translationBlockHashes:
"Wan2.2 Open Source Model Versions": 7ed2d913
"ComfyOrg Wan2.2 Live Streams": 48f6d6e0
"Wan2.2 TI2V 5B Hybrid Version Workflow Example": 927f40b9
+ "Wan2.2 14B T2V Text-to-Video Workflow Example": 339329e2
"Wan2.2 14B I2V Image-to-Video Workflow Example": c73a3ba4
"Wan2.2 14B FLF2V Workflow Example": 732db33d
"Community Resources": 7463b48b
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
-Wan 2.2 es un nuevo modelo generativo multimodal de nueva generación lanzado por WAN AI. Este modelo adopta una innovadora arquitectura MoE (Mixture of Experts), compuesta por modelos expertos de alto ruido y de bajo ruido. Puede dividir los modelos expertos según los pasos de eliminación de ruido (timesteps), generando así contenido de video de mayor calidad.
+Wan 2.2 es un modelo generativo multimodal de nueva generación lanzado por WAN AI. Este modelo adopta una innovadora arquitectura MoE (Mixture of Experts), formada por modelos expertos de alto ruido y de bajo ruido. Puede dividir los modelos expertos según los pasos de denoising (timesteps) y así generar contenido de video de mayor calidad.
-Wan 2.2 tiene tres características principales: control estético de nivel cinematográfico, que integra profundamente los estándares estéticos de la industria del cine profesional y admite control visual multidimensional como iluminación, color y composición; movimiento complejo a gran escala, que recrea con facilidad diversos movimientos complejos y mejora la fluidez y el control del movimiento; y cumplimiento semántico preciso, que destaca en escenas complejas y en la generación de múltiples objetos, reproduciendo mejor las intenciones creativas del usuario.
-El modelo admite varios modos de generación, como texto a video e imagen a video, y es adecuado para la creación de contenido, la creación artística, la educación y la capacitación, entre otros escenarios de aplicación.
+Wan 2.2 tiene tres características principales: control estético de nivel cinematográfico, que integra en profundidad los estándares estéticos de la industria del cine profesional y admite control visual multidimensional como iluminación, color y composición; movimiento complejo a gran escala, que reproduce con facilidad diversos movimientos complejos y mejora la fluidez y el control del movimiento; y cumplimiento semántico preciso, que destaca en escenas complejas y en la generación de múltiples objetos, reproduciendo mejor las intenciones creativas de los usuarios.
+El modelo admite varios modos de generación, como texto a video e imagen a video, y es adecuado para la creación de contenido, la creación artística, la educación y el entrenamiento, entre otros escenarios de aplicación.
-[Wan2.2 Prompt Guide](https://alidocs.dingtalk.com/i/nodes/EpGBa2Lm8aZxe5myC99MelA2WgN7R35y)
+[Guía de prompts de Wan2.2](https://alidocs.dingtalk.com/i/nodes/EpGBa2Lm8aZxe5myC99MelA2WgN7R35y)
## Aspectos destacados del modelo
-- **Control estético de nivel cinematográfico**: Lenguaje de cámara profesional, admite control visual multidimensional como iluminación, color y composición
-- **Movimiento complejo a gran escala**: Restaura suavemente diversos movimientos complejos, mejora la controlabilidad y naturalidad del movimiento
-- **Cumplimiento semántico preciso**: Comprensión de escenas complejas, generación de múltiples objetos, mejor restauración de las intenciones creativas
-- **Tecnología de compresión eficiente**: Versión 5B con VAE de alta relación de compresión, optimización de memoria, admite entrenamiento mixto
+- **Control estético de nivel cinematográfico**: lenguaje de cámara profesional, admite control visual multidimensional como iluminación, color y composición
+- **Movimiento complejo a gran escala**: restaura con suavidad diversos movimientos complejos, mejora la controlabilidad y la naturalidad del movimiento
+- **Cumplimiento semántico preciso**: comprensión de escenas complejas, generación de múltiples objetos, restaura mejor las intenciones creativas
+- **Tecnología de compresión eficiente**: versión 5B con VAE de alta relación de compresión, optimización de memoria, admite entrenamiento mixto
## Versiones de modelos de código abierto Wan2.2
@@ -50,7 +52,7 @@ Los modelos de la serie Wan2.2 se basan en la licencia de código abierto Apache
## Transmisiones en vivo de ComfyOrg Wan2.2
-Para usar ComfyUI Wan2.2, hemos realizado transmisiones en vivo que puedes ver para aprender a usarlos.
+Para el uso de ComfyUI Wan2.2, hemos realizado transmisiones en vivo que puedes ver para aprender a usarlos.
+
Abrir en Comfy Cloud
- Descarga el JSON o busca "Wan2.2 14B T2V" en la Biblioteca de plantillas
+ Descarga el JSON o busca "Wan2.2 14B T2V" en la biblioteca de plantillas
@@ -178,10 +180,10 @@ Todos los modelos mencionados están disponibles en [Comfy-Org/Wan_2.2_ComfyUI_R
- Modelo de difusión de alto ruido. Colócalo en
- Modelo de difusión de bajo ruido. Colócalo en
@@ -220,17 +222,17 @@ ComfyUI/
2. Asegúrate de que el segundo nodo `Load Diffusion Model` cargue el modelo `wan2.2_t2v_low_noise_14B_fp8_scaled.safetensors`.
3. Asegúrate de que el nodo `Load CLIP` cargue el modelo `umt5_xxl_fp8_e4m3fn_scaled.safetensors`.
4. Asegúrate de que el nodo `Load VAE` cargue el modelo `wan_2.1_vae.safetensors`.
-5. (Opcional) En el nodo `EmptyHunyuanLatentVideo`, puedes ajustar las configuraciones de tamaño y el número total de fotogramas del video (`length`).
+5. (Opcional) En el nodo `EmptyHunyuanLatentVideo`, puedes ajustar la configuración de tamaño y el número total de fotogramas del video (`length`).
6. (Opcional) Si necesitas modificar los prompts (positivo y negativo), hazlo en el nodo `CLIP Text Encoder` del paso 5.
7. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video.
## Ejemplo de flujo de trabajo de imagen a video con Wan2.2 14B I2V
-### Wan 2.2 14B de imagen a video {#video_wan2_2_14B_i2v}
+### Wan 2.2 14B imagen a video {#video_wan2_2_14B_i2v}
-Transforma imágenes estáticas en videos dinámicos con control preciso del movimiento y conservación del estilo usando Wan 2.2.
+Transforma imágenes estáticas en videos dinámicos con un control preciso del movimiento y conservación del estilo usando Wan 2.2.
- +
@@ -260,16 +262,16 @@ Sube este archivo al nodo `LoadImage` correspondiente:
### 2. Descargar los modelos manualmente
-Todos los modelos mencionados están disponibles en [Comfy-Org/Wan_2.2_ComfyUI_Repackaged](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged).
+Todos los modelos mencionados se encuentran en [Comfy-Org/Wan_2.2_ComfyUI_Repackaged](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged).
**Modelos de difusión**
- Modelo de difusión I2V de alto ruido. Colócalo en
- Modelo de difusión I2V de bajo ruido. Colócalo en
@@ -300,7 +302,7 @@ ComfyUI/
│ └───📂 vae/
│ └── wan_2.1_vae.safetensors
```
-### 3. Seguir los pasos
+### 3. Sigue los pasos

1. Asegúrate de que el primer nodo `Load Diffusion Model` cargue el modelo `wan2.2_t2v_high_noise_14B_fp8_scaled.safetensors`.
@@ -309,18 +311,18 @@ ComfyUI/
4. Asegúrate de que el nodo `Load VAE` cargue el modelo `wan_2.1_vae.safetensors`.
5. En el nodo `Load Image`, sube la imagen que se usará como fotograma inicial.
6. Si necesitas modificar los prompts (positivo y negativo), hazlo en el nodo `CLIP Text Encoder` del paso 6.
-7. (Opcional) En `EmptyHunyuanLatentVideo`, puedes ajustar las configuraciones de tamaño y el número total de fotogramas del video (`length`).
-8. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación del video.
+7. (Opcional) En `EmptyHunyuanLatentVideo`, puedes ajustar las configuraciones de tamaño y el número total de fotogramas de video (`length`).
+8. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video.
## Ejemplo de flujo de trabajo Wan2.2 14B FLF2V
-El flujo de trabajo de primer y último fotograma usa las mismas ubicaciones de modelo que la sección I2V.
+El flujo de trabajo de primer y último fotograma usa las mismas ubicaciones de modelos que la sección I2V.
-### Wan 2.2 14B primer-último fotograma a video {#video_wan2_2_14B_flf2v}
+### Wan 2.2 14B de primer y último fotograma a video {#video_wan2_2_14B_flf2v}
Genera transiciones de video suaves definiendo los fotogramas inicial y final.
- +
@@ -358,8 +360,8 @@ Sube estos archivos a los nodos `LoadImage` correspondientes:
3. Ajusta las configuraciones de tamaño en el nodo `WanFirstLastFrameToVideo`.
- De forma predeterminada, se establece un tamaño relativamente pequeño para evitar que los usuarios con poca VRAM consuman demasiados recursos.
- Si tienes suficiente VRAM, puedes probar una resolución de alrededor de 720P.
-4. Escribe prompts adecuados según tus fotogramas inicial y final.
-5. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video.
+4. Escribe los prompts adecuados según tus fotogramas inicial y final.
+5. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video.
## Recursos de la comunidad
diff --git a/es/tutorials/video/zai/scail2.mdx b/es/tutorials/video/zai/scail2.mdx
index 7e398aa607..2596589664 100644
--- a/es/tutorials/video/zai/scail2.mdx
+++ b/es/tutorials/video/zai/scail2.mdx
@@ -2,7 +2,7 @@
title: "Tutorial del flujo de trabajo de reemplazo de personaje con SCAIL-2 en ComfyUI"
description: "Anima una imagen de personaje de referencia con un video guía o reemplaza al personaje del video usando SCAIL-2."
sidebarTitle: "SCAIL-2"
-translationSourceHash: 2e9bdad8
+translationSourceHash: 2ebe58cb
translationFrom: tutorials/video/zai/scail2.mdx
translationBlockHashes:
"_intro": a41dfa9a
@@ -10,16 +10,18 @@ translationBlockHashes:
"How the Workflow Works": fad0cdce
"Two Modes": 639623de
"Inputs and Parameters": 5762889f
+ "Model Installation": afc8e5d3
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-**SCAIL-2** es un modelo de animación de personajes de extremo a extremo construido sobre Wan2.1. Impulsa una imagen de referencia de un personaje con un video de conducción, lo que permite tanto la animación de personajes (hacer que un personaje ejecute el movimiento) como el reemplazo de personajes dentro del video (sustituir a una persona rastreada en un video por el personaje de referencia).
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
+
+**SCAIL-2** es un modelo de animación de personajes de extremo a extremo construido sobre Wan2.1. Impulsa una imagen de referencia de un personaje con un video guía, lo que permite tanto la animación de personajes (hacer que un personaje ejecute el movimiento) como el reemplazo de personajes dentro del video (sustituir a una persona rastreada en un video por el personaje de referencia).
**Características principales**:
-- **Animación de personajes de extremo a extremo**: Impulsa una imagen fija de un personaje con el movimiento de un video de conducción
-- **Dos modos**: Modo Animación (el personaje ejecuta el movimiento) y Modo Reemplazo (sustituye la persona rastreada por el personaje de referencia)
-- **Soporte para video largo**: Generación extendida basada en fragmentos con superposición de fotogramas entre segmentos
-- **Nodos integrados de ComfyUI**: Usa `WanSCAILToVideo`, `SCAIL2ColoredMask` y el seguimiento `SAM3` nativos. No se requieren nodos personalizados más allá de las descargas de modelos estándar.
+- **Animación de personajes de extremo a extremo**: impulsa una imagen fija de un personaje con el movimiento de un video guía
+- **Dos modos**: Modo Animación (el personaje ejecuta el movimiento) y Modo Reemplazo (sustituye a la persona rastreada por el personaje de referencia)
+- **Soporte para video largo**: generación extendida basada en fragmentos con superposición de fotogramas entre segmentos
+- **Nodos integrados de ComfyUI**: usa los nodos nativos `WanSCAILToVideo`, `SCAIL2ColoredMask` y el seguimiento `SAM3`. No necesitas nodos personalizados más allá de las descargas de modelos estándar.
**Enlaces relacionados**:
- [Hugging Face: SCAIL-2](https://huggingface.co/zai-org/SCAIL-2)
@@ -46,10 +48,10 @@ Reemplaza a un personaje en un video conservando el movimiento y el contexto de
- Descarga la imagen de referencia predeterminada del personaje o usa la tuya.
+ Descarga la imagen de referencia del personaje predeterminada o usa la tuya.
-
- Descarga el video conductor predeterminado o usa el tuyo.
+
+ Descarga el video guía predeterminado o usa el tuyo.
@@ -65,18 +67,19 @@ Este flujo de trabajo usa dos nodos de subgrafo: un subgrafo **Base** (primer se
4. Previsualiza el resultado y guárdalo
- Este flujo de trabajo usa nodos Subgraph para un procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y extender el flujo de trabajo.
+ Este flujo de trabajo usa nodos de subgrafo para un procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y extender el flujo de trabajo.
+
### Videos largos
-Para videos más largos, calcula el número de segmentos: `ceil(total_frames / 76)`. Todos los segmentos excepto el primero usan el subgrafo Extend. Duplica el nodo Extend para más segmentos, encadena la salida `previous_frames` e incrementa `segment_index`.
+Para videos más largos, calcula el número de segmentos: `ceil(total_frames / 76)`. Cada segmento excepto el primero usa el subgrafo Extend. Duplica el nodo Extend para más segmentos, encadena la salida `previous_frames` e incrementa `segment_index`.
> **Nota:** `WanSCAILToVideo` no puede poner en cola todos los segmentos automáticamente. Ejecuta cada segmento manualmente.
## Dos modos
-| Modo | `replace_mode` | Fondo de la máscara de conducción | Resumen |
-|------|:--------------:|:-------------------------------:|---------|
+| Modo | `replace_mode` | Fondo de la máscara del video de conducción | Resumen |
+|------|:--------------:|:-------------------------------------------:|---------|
| **Reemplazo** | `true` (predeterminado) | Blanco | Intercambia la persona rastreada en el video de conducción por el personaje de referencia |
| **Animación** | `false` | Negro | El personaje de referencia realiza el movimiento del video de conducción |
@@ -96,11 +99,11 @@ Establece el parámetro `replace_mode` en ambos nodos del subgrafo.
| `width` / `height` | Resolución de salida, por ejemplo `896×512`. Debe ser divisible entre 16 |
| `frame_count` | Fotogramas por segmento (predeterminado: 81) |
| `previous_frame_count` | Fotogramas de superposición entre segmentos (predeterminado: 5) |
-| `pose_strength` / `pose_start` / `pose_end` | Intensidad y sincronización del conditioning de pose |
+| `pose_strength` / `pose_start` / `pose_end` | Intensidad y sincronización del acondicionamiento de pose |
### Seguimiento con SAM3 (dos entradas)
-Las entradas `sam3_video_object` y `sam3_image_object` controlan el seguimiento de máscaras de SAM3, **no** el prompt de salida de SCAIL-2. Estas determinan qué objetos se rastrean para las máscaras de color:
+Las entradas `sam3_video_object` y `sam3_image_object` controlan el seguimiento de máscaras de SAM3, **no** el prompt de salida de SCAIL-2. Determinan qué objetos se rastrean para las máscaras de color:
| Entrada | Objetivo | Salida |
|-------|--------|--------|
@@ -113,9 +116,9 @@ Las entradas `sam3_video_object` y `sam3_image_object` controlan el seguimiento
## Instalación de modelos
-Actualiza ComfyUI a la última versión para tener los nodos integrados WanSCAILToVideo y SCAIL2ColoredMask.
+Primero actualiza ComfyUI a la última versión para usar los nodos integrados WanSCAILToVideo y SCAIL2ColoredMask.
-### Modelos necesarios
+### Modelos requeridos
**diffusion_models**
- [wan2.1_14B_SCAIL_2_fp16.safetensors](https://huggingface.co/Comfy-Org/SCAIL-2/blob/main/diffusion_models/wan2.1_14B_SCAIL_2_fp16.safetensors)
@@ -155,3 +158,4 @@ ComfyUI/
│ └── checkpoints/
│ └── sam3.1_multiplex_fp16.safetensors
```
+
diff --git a/ja/development/comfy-router/api.mdx b/ja/development/comfy-router/api.mdx
index c6f3fadec0..dd4fb7cbd6 100644
--- a/ja/development/comfy-router/api.mdx
+++ b/ja/development/comfy-router/api.mdx
@@ -2,7 +2,7 @@
title: "Comfy Router API の概要"
sidebarTitle: "概要"
description: "Comfy Router API の仕組み: モデル ID ごとに 1 つのルート。検出、スキーマ、キュー中のリクエスト、エラー、課金に関するガイドを用意しています。"
-translationSourceHash: dac7e853
+translationSourceHash: cb493feb
translationFrom: development/comfy-router/api.mdx
---
@@ -45,4 +45,5 @@ translationFrom: development/comfy-router/api.mdx
- [クイックスタート](/ja/development/comfy-router/quickstart): インストール、呼び出し、画像の保存。
- [モデル](/ja/development/comfy-router/models): カタログをブラウズし、モデル固有のリクエスト例を確認します。
- [ヘッダー](/ja/development/comfy-router/headers): 認証、冪等性、リクエスト ID、リトライのペース配分。
-- [API リファレンス](/ja/development/comfy-router/reference): エンドポイントのパラメータ、スキーマ、レスポンスコード。
\ No newline at end of file
+- [API リファレンス](/ja/development/comfy-router/reference): エンドポイントのパラメータ、スキーマ、レスポンスコード。
+- [リアルタイム音声](/ja/development/comfy-router/realtime): Grok Voice の WebSocket セッションを開き、秒単位で課金されます。
diff --git a/ja/development/comfy-router/limitations.mdx b/ja/development/comfy-router/limitations.mdx
index e251530d59..96993f599f 100644
--- a/ja/development/comfy-router/limitations.mdx
+++ b/ja/development/comfy-router/limitations.mdx
@@ -2,7 +2,7 @@
title: "Comfy Router の機能と制限"
sidebarTitle: "機能と制限"
description: "Comfy Router とパートナープロキシのどちらを選ぶか、長時間実行される呼び出しへの備え、リカバリ・レート制限・アセット保存について説明します。"
-translationSourceHash: 235802c5
+translationSourceHash: b4d8209c
translationFrom: development/comfy-router/limitations.mdx
translationBlockHashes:
"_intro": 6b871cf3
@@ -14,7 +14,7 @@ translationBlockHashes:
"Requests are rate limited per caller": 249d4d51
"No progress while a call runs": 75d42d8d
"Comfy charges and usage": cf6e2050
- "Models without a pre-flight estimate": 495bdb2b
+ "Models without a pre-flight estimate": f6dfd921
"Router does not cover every partner operation": 786c0fb2
"Model outputs and stored assets": 06c737c1
"Next": be85b789
@@ -116,21 +116,17 @@ Router は、以下のモデルへの呼び出しを実行前に確実に価格
{/* BEGIN GENERATED: models without a pre-flight estimate. Do not hand-edit; regenerate with -update-quote-coverage-docs. */}
- **bfl**: `bfl/erase-v1`, `bfl/video-edit-v1`, `bfl/video-upscale-v1`, `bfl/vto-v1`
-- **byteplus**: `byteplus/seed-audio-1.0`, `byteplus/seed-audio-1.0-multilingual`
-- **fal**: `fal/crystal-upscaler`, `fal/crystal-video-upscaler`, `fal/fal-gpt-image-2`, `fal/fal-gpt-image-2.5-flare`, `fal/fal-gpt-image-2.5-sunburst`, `fal/fal-nano-banana-2`, `fal/fal-nano-banana-pro`, `fal/fal-seedance-2.0`, `fal/fal-seedance-2.5`, `fal/flux-3-max`, `fal/patina`
+- **fal**: `fal/fal-seedance-2.0`, `fal/fal-seedance-2.5`
- **freepik**: `freepik/ai-image-upscaler-precision-v2`, `freepik/ai-skin-enhancer-creative`, `freepik/ai-skin-enhancer-faithful`, `freepik/ai-skin-enhancer-flexible`
- **heygen**: `heygen/starfish`
-- **ideogram**: `ideogram/ideogram-v3`, `ideogram/ideogram-v4`, `ideogram/p-image-ideogram`
-- **kling**: `kling/kling-3.0-turbo`, `kling/kling-image-o1`, `kling/kling-v2-5-turbo`, `kling/kling-v2-6`, `kling/kling-v3`, `kling/kling-v3-omni`, `kling/kling-video-o1`, `kling/videos-avatar-image2video`, `kling/videos-lip-sync`, `kling/videos-video-extend`
-- **luma**: `luma/photon-1`, `luma/photon-flash-1`
-- **meshy**: `meshy/animations`, `meshy/meshy-6`, `meshy/meshy-7`, `meshy/meshy-7.1`, `meshy/remesh`, `meshy/rigging`
+- **ideogram**: `ideogram/ideogram-v3`, `ideogram/ideogram-v4`
+- **kling**: `kling/kling-image-o1`, `kling/videos-avatar-image2video`, `kling/videos-lip-sync`, `kling/videos-video-extend`
- **moonvalley**: `moonvalley/image-to-video`, `moonvalley/text-to-video`, `moonvalley/video-to-video`
- **openai**: `openai/gpt-image-1.5`
- **openrouter**: `openrouter/chat-completions`
- **pika**: `pika/pika-gpt-image-2`, `pika/pika-nano-banana-2`, `pika/pika-nano-banana-pro`
- **runware**: `runware/runware-gpt-image-2`, `runware/runware-gpt-image-2.5-flare`, `runware/runware-gpt-image-2.5-sunburst`, `runware/runware-nano-banana-2`, `runware/runware-nano-banana-pro`, `runware/runware-seedance-2.0`, `runware/runware-seedance-2.5`
- **synclabs**: `synclabs/sync-3`
-- **veed**: `veed/clean-audio`, `veed/clean-audio-video`, `veed/fabric-1.0`, `veed/lipsync-2.0`, `veed/video-background-removal`, `veed/video-background-removal-fast`, `veed/video-background-removal-green-screen`
- **wavespeed**: `wavespeed/wavespeed-gpt-image-2`, `wavespeed/wavespeed-gpt-image-2.5-flare`, `wavespeed/wavespeed-gpt-image-2.5-sunburst`
{/* END GENERATED: models without a pre-flight estimate */}
diff --git a/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx b/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx
index 3a23417044..db3d238d64 100644
--- a/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx
+++ b/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx
@@ -2,13 +2,13 @@
title: "Dreamina Seedance 2.0 260128 を Comfy Router で使用する"
description: "Comfy Router 経由で byteplus/dreamina-seedance-2-0-260128 を呼び出します。endpoint、リクエストの形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Dreamina Seedance 2.0 260128"
-translationSourceHash: 9604ca27
+translationSourceHash: 70ec471f
translationFrom: development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx
translationBlockHashes:
"_intro": 54eac94b
"Quick start": ca074ca5
"Serving providers": 74eb2a7c
- "Schema": 6c5da06a
+ "Schema": 8c0478c9
"Examples": 641c458b
---
@@ -287,10 +287,10 @@ Comfy 側のガードレールであり、BytePlus の制約ではありませ
返されたタスク ID を `draft_task` コンテンツ項目で渡すと、最終的な 1080p ビデオがレンダリングされます。ドラフトタスク ID は 7 日間有効です。
-
- ビデオの再生時間(秒)。Seedance 2.5: [4,30] または -1(自動。ビデオ編集タスクは -1 のみをサポート)。Seedance 2.0、2.0 fast、2.0 mini: [4,15] または -1(自動)。Seedance 1.5 pro: [4,12] または -1。Seedance 1.0: [2,12]。
+
+ ビデオの再生時間(秒)。Seedance 2.0、2.0 fast、2.0 mini: [4,15] または -1(自動)。
- 範囲: `2` から `30`
+ 指定可能な値: `-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`, `13`, `14`, `15`
diff --git a/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx b/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx
index b33007d441..660ce9f9ff 100644
--- a/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx
+++ b/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router で Dreamina Seedance 2.0 Fast 260128 を使用する"
description: "Comfy Router 経由で byteplus/dreamina-seedance-2-0-fast-260128 を呼び出します: エンドポイント、リクエストの形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Dreamina Seedance 2.0 Fast 260128"
-translationSourceHash: b02c6ed1
+translationSourceHash: 8036f4db
translationFrom: development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx
translationBlockHashes:
"_intro": e4deed0d
"Quick start": f5201dd4
- "Schema": e03c503a
+ "Schema": 90b60b2e
"Examples": 7714eccd
---
@@ -279,10 +279,10 @@ v1 /proxy を直接呼び出す場合は、代わりに BytePlus 自身のバリ
返されたタスク ID を `draft_task` コンテンツ項目に渡して、最終的な 1080p ビデオをレンダリングします。Draft タスク ID は 7 日間有効です。
-
- ビデオの再生時間(秒)。Seedance 2.5: [4,30] または -1(自動。ビデオ編集タスクは -1 のみをサポート)。Seedance 2.0、2.0 fast、2.0 mini: [4,15] または -1(自動)。Seedance 1.5 pro: [4,12] または -1。Seedance 1.0: [2,12]。
+
+ ビデオの再生時間(秒)。Seedance 2.0、2.0 fast、2.0 mini: [4,15] または -1(自動)。
- 範囲: `2` から `30`
+ 指定可能な値: `-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`, `13`, `14`, `15`
diff --git a/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx b/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx
index 1fc770ca00..2f8f216ebd 100644
--- a/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx
+++ b/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router で Dreamina Seedance 2.0 Mini を使用する"
description: "Comfy Router 経由で byteplus/dreamina-seedance-2-0-mini を呼び出す方法: エンドポイント、リクエストの形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Dreamina Seedance 2.0 Mini"
-translationSourceHash: 28c5c053
+translationSourceHash: a1d75c67
translationFrom: development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx
translationBlockHashes:
"_intro": 45ff5bfd
"Quick start": b0374f7d
- "Schema": 3c26a330
+ "Schema": ebf1fc3a
"Examples": db01067e
---
@@ -281,10 +281,10 @@ Comfy 側のガードレールであり、BytePlus の制約ではありませ
返されたタスク ID を `draft_task` コンテンツ項目で渡すと、最終的な 1080p ビデオがレンダリングされます。Draft タスク ID は 7 日間有効です。
-
- ビデオの再生時間(秒)。Seedance 2.5: [4,30] または -1(自動。ビデオ編集タスクは -1 のみをサポート)。Seedance 2.0、2.0 fast、2.0 mini: [4,15] または -1(自動)。Seedance 1.5 プロ: [4,12] または -1。Seedance 1.0: [2,12]。
+
+ ビデオの再生時間(秒)。Seedance 2.0、2.0 fast、2.0 mini: [4,15] または -1(自動)。
- 範囲: `2` 〜 `30`
+ 指定可能な値: `-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`, `13`, `14`, `15`
diff --git a/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx b/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx
index 32aea062d4..048ce0e7a1 100644
--- a/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx
+++ b/ja/development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx
@@ -2,13 +2,13 @@
title: "Dreamina Seedance 2.5 260628 を Comfy Router で使用する"
description: "Comfy Router 経由で byteplus/dreamina-seedance-2-5-260628 を呼び出します: エンドポイント、リクエスト形状、Router が返すレスポンス。"
sidebarTitle: "Dreamina Seedance 2.5 260628"
-translationSourceHash: 07fd9c64
+translationSourceHash: 3606fb83
translationFrom: development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx
translationBlockHashes:
"_intro": 4b5f4cec
"Quick start": a2bb8c28
"Serving providers": 197dd61a
- "Schema": 0a76af44
+ "Schema": d2c28a84
"Examples": 5465695b
---
@@ -292,10 +292,10 @@ Comfy 側のガードレールであり、BytePlus の制約ではありませ
返されたタスク ID を `draft_task` コンテンツ項目で渡して、最終的な 1080p ビデオをレンダリングします。Draft タスク ID は 7 日間有効です。
-
- ビデオの再生時間(秒)。Seedance 2.5: [4,30] または -1(自動。ビデオ編集タスクは -1 のみをサポート)。Seedance 2.0、2.0 fast、2.0 mini: [4,15] または -1(自動)。Seedance 1.5 pro: [4,12] または -1。Seedance 1.0: [2,12]。
+
+ ビデオの再生時間(秒)。Seedance 2.5: [4,30] または -1(自動)。
- 範囲: `2` から `30`
+ 指定可能な値: `-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`, `13`, `14`, `15`, `16`, `17`, `18`, `19`, `20`, `21`, `22`, `23`, `24`, `25`, `26`, `27`, `28`, `29`, `30`
diff --git a/ja/development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx b/ja/development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx
index 89d9be1b9f..a2c17b032b 100644
--- a/ja/development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx
+++ b/ja/development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router で Seedance 1.0 Pro 250528 を使用する"
description: "Comfy Router 経由で byteplus/seedance-1-0-pro-250528 を呼び出します: エンドポイント、リクエストの形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Seedance 1.0 Pro 250528"
-translationSourceHash: 450bbe6e
+translationSourceHash: 642f85ab
translationFrom: development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx
translationBlockHashes:
"_intro": e1a3501d
"Quick start": c762675f
- "Schema": fc979e05
+ "Schema": b57b84de
"Examples": 815d621e
---
@@ -279,10 +279,10 @@ Comfy側のガードレールであり、BytePlusの制約ではありません
返されたタスクIDを `draft_task` コンテンツ項目に渡すと、最終的な 1080p ビデオがレンダリングされます。ドラフトタスクIDは7日間有効です。
-
- ビデオの再生時間(秒)。Seedance 2.5: [4,30] または -1(自動。ビデオ編集タスクは -1 のみサポート)。Seedance 2.0、2.0 fast、2.0 mini: [4,15] または -1(自動)。Seedance 1.5 pro: [4,12] または -1。Seedance 1.0: [2,12]。
+
+ ビデオの再生時間(秒)。Seedance 1.0 pro、1.0 pro fast: [2,12]。
- 範囲: `2` 〜 `30`
+ 指定可能な値: `2`, `3`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`
diff --git a/ja/development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx b/ja/development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx
index 0d3cd6f3c6..ee5d48e414 100644
--- a/ja/development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx
+++ b/ja/development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx
@@ -2,12 +2,12 @@
title: "Seedance 1.0 Pro Fast 251015 を Comfy Router で使用する"
description: "Comfy Router 経由で byteplus/seedance-1-0-pro-fast-251015 を呼び出します: エンドポイント、リクエスト形状、Router が返すレスポンスについて解説します。"
sidebarTitle: "Seedance 1.0 Pro Fast 251015"
-translationSourceHash: 43683424
+translationSourceHash: 61dd0135
translationFrom: development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx
translationBlockHashes:
"_intro": 451ffa4b
"Quick start": ec2a21ac
- "Schema": a882b2d8
+ "Schema": dd74b012
"Examples": 1469ab97
---
@@ -281,10 +281,10 @@ BytePlus 自身のバリデータが応答します。実際のトラフィッ
返されたタスク ID を `draft_task` コンテンツ項目に渡すと、最終的な 1080p ビデオがレンダリングされます。Draft タスク ID は 7 日間有効です。
-
- ビデオの再生時間(秒)。Seedance 2.5: [4,30] または -1(自動。ビデオ編集タスクは -1 のみをサポート)。Seedance 2.0、2.0 fast、2.0 mini: [4,15] または -1(自動)。Seedance 1.5 pro: [4,12] または -1。Seedance 1.0: [2,12]。
+
+ ビデオの再生時間(秒)。Seedance 1.0 pro、1.0 pro fast: [2,12]。
- 範囲: `2` から `30`
+ 指定可能な値: `2`, `3`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`
diff --git a/ja/development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx b/ja/development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx
index 7a54185e4e..6134345bb4 100644
--- a/ja/development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx
+++ b/ja/development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router で Seedance 1.5 Pro 251215 を使用する"
description: "Comfy Router 経由で byteplus/seedance-1-5-pro-251215 を呼び出す: エンドポイント、リクエストの形状、Router が返すレスポンス。"
sidebarTitle: "Seedance 1.5 Pro 251215"
-translationSourceHash: 1d016721
+translationSourceHash: 2263b4cf
translationFrom: development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx
translationBlockHashes:
"_intro": 5f93a1f1
"Quick start": 71aafccf
- "Schema": 35f3b5dc
+ "Schema": f4d67fb6
"Examples": 7e73ac5c
---
@@ -279,10 +279,10 @@ v1 /proxy を直接呼び出した場合は BytePlus 自身のバリデータが
返されたタスク ID を `draft_task` コンテンツ項目で指定して、最終的な 1080p ビデオをレンダリングします。Draft タスク ID は 7 日間有効です。
-
- ビデオの再生時間(秒)。Seedance 2.5: [4,30] または -1(自動。ビデオ編集タスクは -1 のみをサポート)。Seedance 2.0、2.0 fast、2.0 mini: [4,15] または -1(自動)。Seedance 1.5 pro: [4,12] または -1。Seedance 1.0: [2,12]。
+
+ ビデオの再生時間(秒)。Seedance 1.5 pro: [4,12] または -1(自動)。
- 範囲: `2` から `30`
+ 指定可能な値: `-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`
diff --git a/ja/development/comfy-router/models/kling/kling-3-0-turbo/code.mdx b/ja/development/comfy-router/models/kling/kling-3-0-turbo/code.mdx
index e387986e28..00cf5cb887 100644
--- a/ja/development/comfy-router/models/kling/kling-3-0-turbo/code.mdx
+++ b/ja/development/comfy-router/models/kling/kling-3-0-turbo/code.mdx
@@ -2,13 +2,13 @@
title: "Comfy Router で Kling 3.0 Turbo を使用する"
description: "Comfy Router 経由で kling/kling-3.0-turbo を呼び出します: エンドポイント、リクエスト形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Kling 3.0 Turbo"
-translationSourceHash: 301a1ee1
+translationSourceHash: d03a4ba5
translationFrom: development/comfy-router/models/kling/kling-3-0-turbo/code.mdx
translationBlockHashes:
"_intro": 5a8c5f4b
"Quick start": a2145573
"Serving providers": 7ec93d4f
- "Schema": 1f5f61c1
+ "Schema": 4ec53894
"Examples": 0a9a8bbe
---
@@ -195,11 +195,11 @@ curl https://api.comfy.org/v2/models/kling/kling-3.0-turbo/requests/$REQUEST_ID
- タスク結果のコールバック通知 URL。タスクのステータスが変化したときにサーバーが通知します。
+ タスク結果のコールバック通知 URL。タスクのステータスが変化したときにサーバーが通知します。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
- カスタムタスク ID。システムが生成したタスク ID を上書きすることはありませんが、クエリに使用できます。1 つのユーザーアカウント内で一意である必要があります。
+ カスタムタスク ID。システムが生成したタスク ID を上書きすることはありませんが、クエリに使用できます。1 つのユーザーアカウント内で一意である必要があります。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
@@ -253,11 +253,23 @@ Router が `GET /v2/models/kling/kling-3.0-turbo/openapi.json` で提供する
- 消費量。小数点以下 2 桁まで正確です。
+ 消費額。小数点以下 2 桁まで正確です。
+
+
+
+ 課金が引き落とされた現金口座(charge_type が "cash" のときのみ存在)。例: "balance"。返すタスクもあれば省略するタスクもあります。
- 消費アカウントの種類。残高の場合は "cash"、リソースパッケージの場合は "unit"。
+ 消費アカウントの種類。"cash" は残高、"unit" はリソースパッケージです。
+
+
+
+ `amount` と `list_price` の ISO 4217 通貨コード。例: "USD"。返すタスクもあれば省略するタスクもあります。
+
+
+
+ 割引前のタスク定価。小数の文字列です。返すタスクもあれば省略するタスクもあります。
diff --git a/ja/development/comfy-router/models/kling/kling-image-o1/code.mdx b/ja/development/comfy-router/models/kling/kling-image-o1/code.mdx
index 1dfb6f8731..387a47e476 100644
--- a/ja/development/comfy-router/models/kling/kling-image-o1/code.mdx
+++ b/ja/development/comfy-router/models/kling/kling-image-o1/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router で Kling Image O1 を使用する"
description: "Comfy Router を通じて kling/kling-image-o1 を呼び出します: エンドポイント、リクエスト形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Kling Image O1"
-translationSourceHash: cf053382
+translationSourceHash: 0d76917c
translationFrom: development/comfy-router/models/kling/kling-image-o1/code.mdx
translationBlockHashes:
"_intro": 513c65df
"Quick start": 6256a30d
- "Schema": d18a5393
+ "Schema": 61821697
"Examples": 826db173
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-image-o1/requests/$REQUEST_ID \
- このタスクの結果を受け取るコールバック通知先アドレス。設定すると、タスクステータスが変化したときにサーバーから能動的に通知されます。
+ このタスクの結果を受け取るコールバック通知先アドレス。設定すると、タスクステータスが変化したときにサーバーから能動的に通知されます。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
形式: `uri`
@@ -182,7 +182,7 @@ curl https://api.comfy.org/v2/models/kling/kling-image-o1/requests/$REQUEST_ID \
- カスタムタスク ID。単一のユーザーアカウント内で一意である必要があります。
+ カスタムタスク ID。単一のユーザーアカウント内で一意である必要があります。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
diff --git a/ja/development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx b/ja/development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx
index a69f9bf8a4..f5f740e601 100644
--- a/ja/development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx
+++ b/ja/development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx
@@ -2,12 +2,12 @@
title: "Kling V2.5 Turbo を Comfy Router で使用する"
description: "Comfy Router 経由で kling/kling-v2-5-turbo を呼び出します: エンドポイント、リクエストの形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Kling V2.5 Turbo"
-translationSourceHash: 1a5ec6e5
+translationSourceHash: 1671e7b6
translationFrom: development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx
translationBlockHashes:
"_intro": 2495a4d3
"Quick start": dc63b3ac
- "Schema": 68d50e72
+ "Schema": 3bcb036e
"Examples": 8623c725
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v2-5-turbo/requests/$REQUEST_ID
- コールバック通知先アドレス
+ コールバック通知先アドレス。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
形式: `uri`
@@ -236,7 +236,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v2-5-turbo/requests/$REQUEST_ID
- カスタムタスクID
+ カスタムタスクID。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
diff --git a/ja/development/comfy-router/models/kling/kling-v2-6/code.mdx b/ja/development/comfy-router/models/kling/kling-v2-6/code.mdx
index 86f2e928dc..73d67c2e0f 100644
--- a/ja/development/comfy-router/models/kling/kling-v2-6/code.mdx
+++ b/ja/development/comfy-router/models/kling/kling-v2-6/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router で Kling V2.6 を使用する"
description: "Comfy Router 経由で kling/kling-v2-6 を呼び出します。endpoint、リクエストの形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Kling V2.6"
-translationSourceHash: 1e64e957
+translationSourceHash: c445a7bd
translationFrom: development/comfy-router/models/kling/kling-v2-6/code.mdx
translationBlockHashes:
"_intro": 04868509
"Quick start": 48a3d970
- "Schema": 9d23ff94
+ "Schema": a61a551f
"Examples": 8623c725
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v2-6/requests/$REQUEST_ID \
- コールバック通知先アドレス
+ コールバック通知先アドレス。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
形式: `uri`
@@ -236,7 +236,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v2-6/requests/$REQUEST_ID \
- カスタムタスク ID
+ カスタムタスク ID。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
diff --git a/ja/development/comfy-router/models/kling/kling-v3-omni/code.mdx b/ja/development/comfy-router/models/kling/kling-v3-omni/code.mdx
index d6e09f2638..765878b269 100644
--- a/ja/development/comfy-router/models/kling/kling-v3-omni/code.mdx
+++ b/ja/development/comfy-router/models/kling/kling-v3-omni/code.mdx
@@ -2,12 +2,12 @@
title: "Kling V3 Omni を Comfy Router で使用する"
description: "Comfy Router 経由で kling/kling-v3-omni を呼び出します: エンドポイント、リクエストの形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Kling V3 Omni"
-translationSourceHash: 226ee8a6
+translationSourceHash: 29d1799c
translationFrom: development/comfy-router/models/kling/kling-v3-omni/code.mdx
translationBlockHashes:
"_intro": 98827333
"Quick start": 3a226de2
- "Schema": f9b37353
+ "Schema": 68bd0500
"Examples": 6c2642d6
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v3-omni/requests/$REQUEST_ID \
- このタスクの結果を受け取るコールバック通知先アドレス。設定すると、タスクのステータスが変化した際にサーバーが能動的に通知します。
+ このタスクの結果を受け取るコールバック通知先アドレス。設定すると、タスクのステータスが変化した際にサーバーが能動的に通知します。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
フォーマット: `uri`
@@ -188,7 +188,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v3-omni/requests/$REQUEST_ID \
- カスタムタスクID。単一のユーザーアカウント内で一意である必要があります。
+ カスタムタスクID。単一のユーザーアカウント内で一意である必要があります。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
diff --git a/ja/development/comfy-router/models/kling/kling-v3/code.mdx b/ja/development/comfy-router/models/kling/kling-v3/code.mdx
index bd8c4f29cf..d076fa35b8 100644
--- a/ja/development/comfy-router/models/kling/kling-v3/code.mdx
+++ b/ja/development/comfy-router/models/kling/kling-v3/code.mdx
@@ -2,13 +2,13 @@
title: "Comfy Router で Kling V3 を使用する"
description: "Comfy Router 経由で kling/kling-v3 を呼び出します。エンドポイント、リクエスト形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Kling V3"
-translationSourceHash: ecfa3f9b
+translationSourceHash: e07d4035
translationFrom: development/comfy-router/models/kling/kling-v3/code.mdx
translationBlockHashes:
"_intro": 74a12e0f
"Quick start": 09c0a41a
"Serving providers": a8b20c72
- "Schema": 77550c0a
+ "Schema": 8e8b04e6
"Examples": 8623c725
---
@@ -177,7 +177,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v3/requests/$REQUEST_ID \
- コールバック通知先アドレス
+ コールバック通知先アドレス。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
形式: `uri`
@@ -247,7 +247,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v3/requests/$REQUEST_ID \
- カスタムタスクID
+ カスタムタスクID。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
diff --git a/ja/development/comfy-router/models/kling/kling-video-o1/code.mdx b/ja/development/comfy-router/models/kling/kling-video-o1/code.mdx
index 1bc4fa1c1c..ef2e832725 100644
--- a/ja/development/comfy-router/models/kling/kling-video-o1/code.mdx
+++ b/ja/development/comfy-router/models/kling/kling-video-o1/code.mdx
@@ -2,12 +2,12 @@
title: "Kling Video O1 を Comfy Router で使用する"
description: "Comfy Router 経由で kling/kling-video-o1 を呼び出します。エンドポイント、リクエストの形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Kling Video O1"
-translationSourceHash: 3c228231
+translationSourceHash: 892ccf77
translationFrom: development/comfy-router/models/kling/kling-video-o1/code.mdx
translationBlockHashes:
"_intro": a36df86f
"Quick start": 2dd48300
- "Schema": 6f4cf55b
+ "Schema": f693e2ef
"Examples": 6c2642d6
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-video-o1/requests/$REQUEST_ID \
- このタスクの結果を受け取るコールバック通知先アドレス。設定すると、タスクのステータスが変化した際にサーバーから能動的に通知されます。
+ このタスクの結果を受け取るコールバック通知先アドレス。設定すると、タスクのステータスが変化した際にサーバーから能動的に通知されます。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
形式: `uri`
@@ -188,7 +188,7 @@ curl https://api.comfy.org/v2/models/kling/kling-video-o1/requests/$REQUEST_ID \
- カスタムタスクID。1 つのユーザーアカウント内で一意である必要があります。
+ カスタムタスクID。1 つのユーザーアカウント内で一意である必要があります。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
diff --git a/ja/development/comfy-router/models/kling/videos-avatar-image2video/code.mdx b/ja/development/comfy-router/models/kling/videos-avatar-image2video/code.mdx
index 46daa06fdf..8af172042b 100644
--- a/ja/development/comfy-router/models/kling/videos-avatar-image2video/code.mdx
+++ b/ja/development/comfy-router/models/kling/videos-avatar-image2video/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router で Videos Avatar Image 2video を使用する"
description: "Comfy Router 経由で kling/videos-avatar-image2video を呼び出します: エンドポイント、リクエスト形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Videos Avatar Image 2video"
-translationSourceHash: 444b1395
+translationSourceHash: 5181e917
translationFrom: development/comfy-router/models/kling/videos-avatar-image2video/code.mdx
translationBlockHashes:
"_intro": baca1542
"Quick start": 5605d33f
- "Schema": eeb06fe1
+ "Schema": 073bf8b2
"Examples": ce6803dd
---
@@ -164,13 +164,13 @@ curl https://api.comfy.org/v2/models/kling/videos-avatar-image2video/requests/$R
- このタスクの結果を受け取るコールバック通知アドレス。
+ このタスクの結果を受け取るコールバック通知アドレス。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
形式: `uri`
- カスタムタスク ID。単一のユーザーアカウント内で一意である必要があります。
+ カスタムタスク ID。単一のユーザーアカウント内で一意である必要があります。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
diff --git a/ja/development/comfy-router/models/kling/videos-lip-sync/code.mdx b/ja/development/comfy-router/models/kling/videos-lip-sync/code.mdx
index 80a7965e28..1f0880d972 100644
--- a/ja/development/comfy-router/models/kling/videos-lip-sync/code.mdx
+++ b/ja/development/comfy-router/models/kling/videos-lip-sync/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router で Videos Lip Sync を使う"
description: "Comfy Router 経由で kling/videos-lip-sync を呼び出します: エンドポイント、リクエスト形状、Router が返すレスポンスについて。"
sidebarTitle: "Videos Lip Sync"
-translationSourceHash: ddd2a405
+translationSourceHash: 6103bea9
translationFrom: development/comfy-router/models/kling/videos-lip-sync/code.mdx
translationBlockHashes:
"_intro": 0477697a
"Quick start": e13a4628
- "Schema": 90571e9f
+ "Schema": 4fb7c777
"Examples": d1dd6ed8
---
@@ -176,7 +176,7 @@ curl https://api.comfy.org/v2/models/kling/videos-lip-sync/requests/$REQUEST_ID
### 入力
- コールバック通知アドレス。タスクのステータスが変更されるとサーバーから通知されます。
+ コールバック通知アドレス。タスクのステータスが変更されるとサーバーから通知されます。無視されます: comfy-api は転送前にこのフィールドを破棄します。Comfy Router がユーザーの代わりにポーリングします。
形式: `uri`
diff --git a/ja/development/comfy-router/models/runway/gen4-image/code.mdx b/ja/development/comfy-router/models/runway/gen4-image/code.mdx
index 02df1cab50..550a44df97 100644
--- a/ja/development/comfy-router/models/runway/gen4-image/code.mdx
+++ b/ja/development/comfy-router/models/runway/gen4-image/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router で Gen 4 Image を使用する"
description: "Comfy Router 経由で runway/gen4_image を呼び出します: エンドポイント、リクエストの形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Gen 4 Image"
-translationSourceHash: c5792f5c
+translationSourceHash: 51dc9815
translationFrom: development/comfy-router/models/runway/gen4-image/code.mdx
translationBlockHashes:
"_intro": f3b89ce9
"Quick start": 82a202eb
- "Schema": d889abf3
+ "Schema": 1160ec6d
"Examples": 291dbf54
---
@@ -168,7 +168,7 @@ curl https://api.comfy.org/v2/models/runway/gen4_image/requests/$REQUEST_ID \
- エンコードされた画像を含む HTTPS URL またはデータ URI
+ エンコードされた画像を含む HTTPS URL、Runway アップロード URI(runway://)、または data URI
Router が `GET /v2/models/runway/gen4_image/openapi.json` で提供するスキーマから生成されています。これは、リクエストがプロバイダーに到達する前に Router が呼び出しを検証する対象となるドキュメントと同じものです。
diff --git a/ja/development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx b/ja/development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx
index b0b1763d17..f2bbc30d2e 100644
--- a/ja/development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx
+++ b/ja/development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router で Grok Imagine Image 2.0 を使用する"
description: "Comfy Router 経由で xai/grok-imagine-image-2.0 を呼び出します: endpoint、リクエスト形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Grok Imagine Image 2.0"
-translationSourceHash: 83fe91a1
+translationSourceHash: e062dc40
translationFrom: development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx
translationBlockHashes:
"_intro": 614e2e15
"Quick start": ff9945c8
- "Schema": faf9e081
+ "Schema": cb29dfae
"Examples": 3222291b
---
@@ -172,9 +172,9 @@ curl https://api.comfy.org/v2/models/xai/grok-imagine-image-2.0/requests/$REQUES
- 出力画像の品質。grok-imagine-image-2.0 では価格ティアを選択します(low/medium。デフォルトは medium)。その他のモデルは現在これを無視します。
+ 出力画像の品質。grok-imagine-image-2.0 では、これが価格ティアを選択します(low、medium、または auto。省略時は xAI のデフォルトで、auto は生成時に low、編集時に medium を使用)。その他のモデルはこれを無視します。
- 指定可能な値: `low`, `medium`, `high`
+ 指定可能な値: `low`, `medium`, `high`, `auto`
diff --git a/ja/development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx b/ja/development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx
index ea409df086..db5f5ae708 100644
--- a/ja/development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx
+++ b/ja/development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx
@@ -2,12 +2,12 @@
title: "Grok Imagine Image Pro を Comfy Router で使用する"
description: "Comfy Router 経由で xai/grok-imagine-image-pro を呼び出す: エンドポイント、リクエストの形状、Router が返すレスポンス。"
sidebarTitle: "Grok Imagine Image Pro"
-translationSourceHash: 7932bb72
+translationSourceHash: 773b1560
translationFrom: development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx
translationBlockHashes:
"_intro": 97d341e4
"Quick start": 3a4bd585
- "Schema": 5d56d158
+ "Schema": 805c771c
"Examples": 3222291b
---
@@ -172,9 +172,9 @@ curl https://api.comfy.org/v2/models/xai/grok-imagine-image-pro/requests/$REQUES
- 出力画像の品質。grok-imagine-image-2.0 では価格ティアを選択します(low/medium、デフォルトは medium)。その他のモデルでは現在無視されます。
+ 出力画像の品質。grok-imagine-image-2.0 では、これが価格ティアを選択します(low、medium、または auto。省略時は xAI のデフォルトで、auto は生成時に low、編集時に medium を使用)。その他のモデルはこれを無視します。
- 指定可能な値: `low`, `medium`, `high`
+ 指定可能な値: `low`, `medium`, `high`, `auto`
diff --git a/ja/development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx b/ja/development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx
index 5f7d233efb..e8c6ea066a 100644
--- a/ja/development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx
+++ b/ja/development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router で Grok Imagine Image Quality を使用する"
description: "Comfy Router 経由で xai/grok-imagine-image-quality を呼び出します: エンドポイント、リクエストの形状、Router が返すレスポンスについて。"
sidebarTitle: "Grok Imagine Image Quality"
-translationSourceHash: 923968d2
+translationSourceHash: 9f6e16d5
translationFrom: development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx
translationBlockHashes:
"_intro": 72081c22
"Quick start": 799275b8
- "Schema": e0fcef44
+ "Schema": e2c96ff6
"Examples": 3222291b
---
@@ -172,9 +172,9 @@ curl https://api.comfy.org/v2/models/xai/grok-imagine-image-quality/requests/$RE
- 出力画像の品質。grok-imagine-image-2.0 では価格ティア(low/medium。デフォルトは medium)を選択します。その他のモデルは現在この項目を無視します。
+ 出力画像の品質。grok-imagine-image-2.0 では、これが価格ティアを選択します(low、medium、または auto。省略時は xAI のデフォルトで、auto は生成時に low、編集時に medium を使用)。その他のモデルはこれを無視します。
- 指定可能な値: `low`、`medium`、`high`
+ 指定可能な値: `low`、`medium`、`high`、`auto`
diff --git a/ja/development/comfy-router/models/xai/grok-imagine-image/code.mdx b/ja/development/comfy-router/models/xai/grok-imagine-image/code.mdx
index 92b8b1dfc1..9bb27cb588 100644
--- a/ja/development/comfy-router/models/xai/grok-imagine-image/code.mdx
+++ b/ja/development/comfy-router/models/xai/grok-imagine-image/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router で Grok Imagine Image を使う"
description: "Comfy Router 経由で xai/grok-imagine-image を呼び出す: エンドポイント、リクエスト形状、Router が返すレスポンスについて説明します。"
sidebarTitle: "Grok Imagine Image"
-translationSourceHash: 9cfb938a
+translationSourceHash: 2e5c55ad
translationFrom: development/comfy-router/models/xai/grok-imagine-image/code.mdx
translationBlockHashes:
"_intro": a2e97c88
"Quick start": a5495331
- "Schema": 1d17b83a
+ "Schema": 171da7d5
"Examples": 3222291b
---
@@ -172,9 +172,9 @@ curl https://api.comfy.org/v2/models/xai/grok-imagine-image/requests/$REQUEST_ID
- 出力画像の品質。grok-imagine-image-2.0 では、これが価格ティアを選択します(low/medium。デフォルトは medium)。その他のモデルは現在のところこれを無視します。
+ 出力画像の品質。grok-imagine-image-2.0 では、これが価格ティアを選択します(low、medium、または auto。省略時は xAI のデフォルトで、auto は生成時に low、編集時に medium を使用)。その他のモデルはこれを無視します。
- 取り得る値: `low`、`medium`、`high`
+ 指定可能な値: `low`、`medium`、`high`、`auto`
diff --git a/ja/development/comfy-router/realtime.mdx b/ja/development/comfy-router/realtime.mdx
new file mode 100644
index 0000000000..3723f0c26e
--- /dev/null
+++ b/ja/development/comfy-router/realtime.mdx
@@ -0,0 +1,224 @@
+---
+title: "Comfy Router リアルタイム音声セッション"
+sidebarTitle: "リアルタイム音声"
+description: "Comfy Router 経由で Grok Voice のリアルタイム WebSocket セッションを開く方法: エンドポイント、認証、秒単位の料金、セッション制限、発生しうるエラーとクローズコードについて説明します。"
+translationSourceHash: e4024a38
+translationFrom: development/comfy-router/realtime.mdx
+translationBlockHashes:
+ "_intro": a85f88e5
+ "Endpoint": 2ae36abf
+ "Authentication": 582120fe
+ "Connect": b61ae8c6
+ "Events": a3ac8c47
+ "Pricing": 25d35f6c
+ "Limits": 85e21dff
+ "Errors": 3085ba65
+ "Next": 3e8c1bd8
+---
+
+Comfy Router は、fal が提供する xAI の Grok Voice とのリアルタイム音声対音声セッションを中継します。Comfy API キーを使って Router への WebSocket を1本開きます。Router はアカウントとクレジットを確認し、上流でセッションを開いてから、イベントを双方向に中継します。セッションの秒単位の料金は Comfy のクレジットから支払われます。
+
+## エンドポイント
+
+```text
+wss://api.comfy.org/v2/realtime/fal/xai/grok-voice/realtime
+```
+
+リクエストは WebSocket アップグレードです(`Connection: Upgrade` と `Upgrade: websocket` を伴う `GET`)。それ以外のリクエストは `426` で拒否されます。
+
+## 認証
+
+アップグレードリクエストのヘッダーで、Comfy API キーを `X-API-Key: comfyui-...` または `Authorization: Bearer comfyui-...` として送信します。Router はクエリ文字列や WebSocket サブプロトコルからキーを読み取りません。
+
+
+ブラウザは WebSocket にヘッダーを設定できません。また、Comfy API キーを絶対にブラウザへ到達させてはいけません。サーバーからセッションを開き、オーディオをブラウザへ自分で中継してください。
+
+
+## 接続
+
+アップグレードが成功したら、xAI が Grok Voice 向けに文書化しているリアルタイムイベントを送受信します。この例ではセッションを設定し、1 回のテキストターンを送信して、受信した各イベントタイプを出力します。
+
+
+
+```python Python
+# pip install websockets msgpack
+import asyncio
+import os
+
+import msgpack
+import websockets
+
+URL = "wss://api.comfy.org/v2/realtime/fal/xai/grok-voice/realtime"
+
+
+async def send(ws, event):
+ await ws.send(msgpack.packb(event))
+
+
+async def main():
+ async with websockets.connect(
+ URL,
+ additional_headers={"X-API-Key": os.environ["COMFY_API_KEY"]},
+ ) as ws:
+ await send(ws, {
+ "type": "session.update",
+ "session": {
+ "voice": "eve",
+ "instructions": "You are a helpful assistant.",
+ "turn_detection": {"type": "server_vad"},
+ },
+ })
+ await send(ws, {
+ "type": "conversation.item.create",
+ "item": {
+ "type": "message",
+ "role": "user",
+ "content": [{"type": "input_text", "text": "Hello!"}],
+ },
+ })
+ await send(ws, {"type": "response.create"})
+
+ async for message in ws:
+ if isinstance(message, str):
+ continue # fal 独自の x-fal-message フレーム
+ event = msgpack.unpackb(message)
+ print(event["type"])
+ if event["type"] == "response.done":
+ break
+
+
+asyncio.run(main())
+```
+
+```javascript Node.js
+// npm install ws @msgpack/msgpack
+import WebSocket from "ws";
+import { encode, decode } from "@msgpack/msgpack";
+
+const ws = new WebSocket(
+ "wss://api.comfy.org/v2/realtime/fal/xai/grok-voice/realtime",
+ { headers: { "X-API-Key": process.env.COMFY_API_KEY } },
+);
+
+ws.on("unexpected-response", (req, res) => {
+ // アップグレードが拒否されました。JSON ボディに理由が示されています。
+ let body = "";
+ res.on("data", (chunk) => (body += chunk));
+ res.on("end", () => console.error(res.statusCode, body));
+});
+
+const send = (event) => ws.send(encode(event));
+
+ws.on("open", () => {
+ send({
+ type: "session.update",
+ session: {
+ voice: "eve",
+ instructions: "You are a helpful assistant.",
+ turn_detection: { type: "server_vad" },
+ },
+ });
+ send({
+ type: "conversation.item.create",
+ item: {
+ type: "message",
+ role: "user",
+ content: [{ type: "input_text", text: "Hello!" }],
+ },
+ });
+ send({ type: "response.create" });
+});
+
+ws.on("message", (data, isBinary) => {
+ if (!isBinary) return; // fal 独自の x-fal-message フレーム
+ const event = decode(data);
+ console.log(event.type);
+ if (event.type === "response.done") ws.close();
+});
+
+ws.on("close", (code) => console.log("closed", code));
+```
+
+
+
+終わったらすぐにソケットを閉じてください。課金されるのは最後のレスポンスまでではなく、セッションが閉じるまでです。
+
+## イベント
+
+Router は独自のイベントプロトコルを定義していません。サーバーイベントは fal が送信するそのままの形で届き、Router が受け付けるクライアントイベントは変更されずに転送されます。イベント一覧、セッションのフィールド、ボイス、オーディオ形式については、次を参照してください。
+
+- [xAI Speech to Speech](https://docs.x.ai/developers/model-capabilities/audio/speech-to-speech) および xAI の [realtime イベントスキーマ](https://docs.x.ai/voice-realtime.ws.json)
+- fal の [Grok Voice realtime モデルページ](https://fal.ai/models/xai/grok-voice/realtime) とその [API ページ](https://fal.ai/models/xai/grok-voice/realtime/api)
+
+各クライアントイベントは、例のように 1 つの msgpack バイナリメッセージとして送信してください。これは fal のリアルタイムクライアントが使用するフレーミングであり、モデルのイベントも同じ方法で、`session.created` で始まる msgpack バイナリメッセージとして返されます。fal は独自の `x-fal-message` タイプの JSON テキストメッセージ(タイミング情報)も送信しますが、これらはスキップしてかまいません。Router のチェックではクライアントイベントを 1 つの JSON テキストメッセージとして受け付けることもできますが、クライアントで JSON をテスト済みでない限り msgpack を使用してください。
+
+Router は転送前に各クライアントイベントをチェックします:
+
+- **イベントタイプ:** `session.update`、`input_audio_buffer.append`、`input_audio_buffer.commit`、`input_audio_buffer.clear`、`conversation.item.create`、`conversation.item.delete`、`conversation.item.truncate`、`response.create`、`response.cancel`、および fal の `x-fal-session.configure`。
+- **モデル:** `session.update` 内の `model` は `grok-voice-latest`、`grok-voice-3.0`、または `grok-voice-2.0` である必要があります。
+- **ツール:** クライアントが実行する関数ツールは許可されます。サーバー側のツール(ウェブ検索、X 検索、ファイル検索、MCP)は拒否されます。
+- **メディア:** 画像とビデオの入力は拒否されます。セッションは音声とテキストのみです。
+- **サイズ:** 1 つのクライアントメッセージは最大 1 MiB です。
+
+拒否されたイベントは転送されず、Router はクローズコード `1008` でセッションを閉じます。
+
+## 料金
+
+セッションには**1秒あたり$0.0011869**の費用がかかります(1分あたり約$0.0712、または1秒あたり0.2504クレジット、1分あたり約15.0クレジット。211クレジット = 1 USDのレートで)。セッションが開いている間は15秒単位で課金され、最後の端数は秒単位で切り上げて課金されます。課金はアップグレードからソケットが閉じるまで、オーディオが流れているかどうかに関係なく継続します。
+
+## 制限
+
+| 制限 | 値 |
+| --- | --- |
+| アカウントあたりのセッション | 同時に開けるセッションは1つです。2つ目を開くと `429` と `router.realtime.session_already_live` が返されます。 |
+| セッションの長さ | 最大30分で、接続時点のあなたのクレジット残高がカバーする範囲を超えることはありません。 |
+| セッション中のクレジット | Router は15秒ごとに残高を再確認し、残高が次の1秒をカバーできなくなった時点でセッションを終了します。 |
+| 接続レート | 各アップグレード試行は[呼び出し元ごとのリクエストレート](/ja/development/comfy-router/limitations#リクエストは呼び出し元ごとにレート制限される)にカウントされ、他の Router 呼び出しと共有されます。 |
+
+セッションが時間制限に達した場合、またはクレジットが不足した場合、接続は close フレームなしで閉じることがあります(多くの場合、close コード `1006` として現れます)。チャージした後にのみ再接続するか、より長い時間が必要な場合は新しいセッションを開始してください。
+
+## エラー
+
+### アップグレード前
+
+Router が接続を拒否した場合、プロトコルを切り替えずに HTTP ステータスと JSON ボディで応答します。
+
+```json
+{
+ "detail": "Insufficient credits to open a realtime session.",
+ "error_type": "insufficient_credits",
+ "code": "router.realtime.insufficient_credits"
+}
+```
+
+判定には `code` を使用してください。`detail` は人向けの説明です。
+
+| ステータス | `code` | 原因 | 対処 |
+| --- | --- | --- | --- |
+| `426` | `router.realtime.upgrade_required` | リクエストが WebSocket アップグレードではありませんでした。 | WebSocket クライアントで接続してください。 |
+| `401` | `router.realtime.unauthorized` | API キーが不足しているか無効です。 | `X-API-Key` または `Authorization: Bearer` で有効なキーを送信してください。 |
+| `402` | `router.realtime.insufficient_credits` | 残高がセッションの少なくとも1秒分に満たない状態です。 | クレジットを追加してから再接続してください。 |
+| `402` | `router.realtime.spend_denied` | セッションの課金先となるウォレットに資金がありません。ボディ内の `denied_reason` と `billed_workspace` がどのウォレットかを示します。 | そのワークスペースにクレジットを追加してから再接続してください。 |
+| `403` | `router.realtime.provider_disabled` | ワークスペースのパートナープロバイダーポリシーがこのプロバイダーを許可していません。 | ワークスペースの管理者に許可を依頼してください。 |
+| `404` | `router.realtime.model_not_allowed` | URL 内のモデルはリアルタイムでは利用不可です。 | URL を確認してください。 |
+| `429` | `router.realtime.rate_limited` | リクエストレートを超過しました。 | `Retry-After` を待ってから再試行してください。 |
+| `429` | `router.realtime.session_already_live` | アカウントで既に別のセッションが開かれています。 | 先にそれを閉じてください。 |
+| `429` | `router.realtime.concurrency_limit` | パートナーモデルの同時呼び出しが多すぎます。 | 同時実行数を減らして再試行してください。 |
+| `502` | `router.realtime.upstream_refused`、`router.realtime.token_mint_failed` | アップストリームのプロバイダーがセッションを開きませんでした。 | バックオフを伴って再試行してください。 |
+| `503` | その他の `router.realtime.*` コード | リアルタイムセッションが一時的に利用できません。 | バックオフを伴って再試行してください。 |
+
+### アップグレード後
+
+| クローズコード | 意味 | 対処 |
+| --- | --- | --- |
+| `1008` | クライアントイベントが拒否されました([イベント](#イベント)を参照)。 | イベントを修正してください。セッションは終了します。 |
+| `1012` | Router が再起動中です。 | 再接続してください。新しいセッションが開始され、新しいアップグレードから課金されます。 |
+| `1006`(クローズフレームなし) | セッションが時間制限に達した、またはクレジットが不足した際にクライアントが報告する値としてよく見られます。ネットワーク切断も同じように見えます。 | クレジットを追加するか、新しいセッションを開始してください。 |
+
+その他のクローズは fal または xAI によるものです。[イベント](#イベント)にリンクされている各社のドキュメントを参照してください。
+
+## 次のステップ
+
+- [課金](/ja/development/comfy-router/billing): Router の課金方法と使用量の照合方法について説明します。
+- [エラーとリトライ](/ja/development/comfy-router/errors): 他の Router 呼び出しが返すエラーの分類について説明します。
+- [制限事項](/ja/development/comfy-router/limitations): リクエストレートやその他の制限について説明します。
diff --git a/ja/development/comfy-router/reference.mdx b/ja/development/comfy-router/reference.mdx
index fd47f1f242..afe1998237 100644
--- a/ja/development/comfy-router/reference.mdx
+++ b/ja/development/comfy-router/reference.mdx
@@ -2,17 +2,17 @@
title: "Comfy Router API リファレンス"
description: "Comfy API 契約から生成済みの、Comfy Router のすべてのエンドポイント、パラメータ、レスポンスボディ、エラーバケット。"
sidebarTitle: "API リファレンス"
-translationSourceHash: a6f99965
+translationSourceHash: aee933a1
translationFrom: development/comfy-router/reference.mdx
translationBlockHashes:
"_intro": 3f6e5d23
- "Endpoints": 222fd740
+ "Endpoints": e0879d3c
"Error buckets": 02a09cb4
"Response headers": 403c8bf5
- "Pre-flight cost estimates": 5952af3f
- "Result assets": 18fe6dad
+ "Pre-flight cost estimates": f0ba96a1
+ "Result assets": 5936427c
"Per-model input and output schemas": 61c6bde8
- "Schemas": 984bd216
+ "Schemas": c1245cc9
---
@@ -309,7 +309,7 @@ Comfy API キーは Bearer トークンとして送信することもできま
**モデル呼び出しを実行する前に、実行せずに価格を見積もります。**
-このボディをこのモデルで実行した場合のコストを米ドルで示す事前見積もりを返します。価格は、実行時の請求に使われるのと同じレートカードから算出されます(ベンダーが報告するコストで課金されるモデルの場合は、代わりにベンダーの公開価格表から見積もられます)。これは見積もりであり、最終的な請求額ではありません。実際に支払うのは、ワークスペースの利用状況および請求記録に確定した請求額です。ボディはまずモデルの入力スキーマに対して検証されます。デフォルトの実行(`strict_mode` なし、`reject_unknown_fields` なし)が検証するのと同じ方法です。そのため、モデルのスキーマに適合しないボディは、実行時と同じ `422` になります。プロバイダーには何もディスパッチされず、課金も発生しません。この応答は価格の固定ではありません。`pricing_as_of` の時点で有効な料率で価格が算出され、実行はレーティング時点で有効な料率で課金されます。この機能のロールアウト中は、このルートは `403` を返し、`error_type: not_enabled` となります。
+このボディをこのモデルで実行した場合のコストを米ドルで示す事前見積もりを返します。価格は、実行時の請求に使われるのと同じレートカードから算出されます(ベンダーが報告するコストで課金されるモデルの場合は、代わりにベンダーの公開価格表から見積もられます)。これは見積もりであり、最終的な請求額ではありません。実際に支払うのは、ワークスペースの利用状況および請求記録に確定した請求額です。ボディはまずモデルの入力スキーマに対して検証されます。デフォルトの実行(`strict_mode` なし、`reject_unknown_fields` なし)が検証するのと同じ方法です。そのため、モデルのスキーマに適合しないボディは、実行時と同じ `422` になります。プロバイダーには何もディスパッチされず、課金も発生しません。この応答は価格の固定ではありません。`pricing_as_of` の時点で有効な料率で価格が算出され、実行はレーティング時点で有効な料率で課金されます。この機能のロールアウト中は、このルートは `403` を返し、`error_type: not_enabled` となります。また、Router がまだ実行できないモデルは、実行ルート自身の `detail` を伴う同じ `403` を返すため、`detail` を読んで両者を区別してください。
**パラメータ**
@@ -1000,7 +1000,7 @@ Router がまだ実行前に価格付けできないモデルは、[事前見積
見積もりの限界。`200` の数値は、実行が受け付けられること、または正確にその金額が請求されることを約束するものではありません:
- `/estimate` は `strict_mode` や `reject_unknown_fields` を受け取らないため、モデルのネイティブな契約のみを検証します。`strict_mode=true` の実行が代替プロバイダー自身のスキーマで受け付けるボディが、ここでは `422` になることがあります。また、`reject_unknown_fields=true` の実行なら拒否する未宣言のトップレベルフィールドが、ここでは価格付けされます。Anthropic Messages モデルは例外です。そのスキーマは未宣言のフィールドを許容するため、`reject_unknown_fields=true` の実行でも何も拒否せず、見積もりは未宣言のトップレベルフィールド `tools`、`tool_choice`、`temperature`、`top_p`、`top_k`、`stop_sequences`、`metadata`、`thinking` および空の `mcp_servers` のみを価格付けします。その他の未宣言のトップレベルフィールドがあると、`reason: not_quotable` とともに `unknown` を返します。
-- `pricing_as_of` は料率表を取得した時刻、またはベンダーの公開価格表から取得した `estimated` の見積もりの場合はその価格表を読んだ日付です(どちらも読まれていない場合は、見積もりを返した時刻です)。これは価格の固定ではありません。実行は、レーティング時点で有効な料率で請求されます。
+- `pricing_as_of` は料率表を取得した時刻です。ベンダーの公開価格表から取得した `estimated` の見積もりは、その価格表を読んだ日付を持ちます。請求数量をベンダーの公開スケジュールから予測し、その後レートカードで価格設定する `exact` または `estimated` の見積もりは、そのスケジュールの読み取り日がカードより古い場合、スケジュールの読み取り日を持ちます。カードもスケジュールも読まれていない場合は、見積もりを返した時刻です。これは価格の固定ではありません。実行は、レーティング時点で有効な料率で請求されます。
- `/estimate` は `model_provider` が示すレグ、またはネイティブのプロバイダーを価格付けします。`fallback_provider` や `strict_mode` パラメータは受け取りません。フォールバックのリトライが別のプロバイダーで行われる同期実行は、そのプロバイダーの料率で請求され、見積もりはそのレグを価格付けしていません。実行のレスポンスの `X-Comfy-Router-Fallback-Provider` が、それが発生したことを示します。キュー中の送信にはフォールバックがないため、その `estimate` は実行されるレグを価格付けします。
- `/estimate` とキュー中の送信の `estimate` は、`model_provider` レグの同じボディ、または兄弟オペレーションで実行されるボディについて、わずかに異なるドキュメントを価格付けすることがあります。送信の `estimate` は、実行が送信するドキュメントに基づいて価格付けされます。
- `/estimate` は常にプラットフォームの請求額を算出します。自分のプロバイダーキーでの実行は Comfy から請求されませんが、`/estimate` はそれを検出せずに数値を返します。`reason: byok` を返すのはキュー中の送信だけです。- ドルは丸めていないセントから最大8桁の小数で表示され、課金対象の1セント未満の `amount` が `0` と表示されることはありません。`credits` は `round(amount × 211, 2)` であり、これは `X-Comfy-Credits-Used` が課金に適用するのと同じ変換です。そのため、ごく小さい非ゼロの価格では `credits` が `0` にラウンドされることがあります。これが重要となる場合は、`credits` ではなく `amount` または `amount_cents` で予算を立ててください。このヘッダーは引き続き、1回の実行に対する事後的な数値です。残高は Comfy プラットフォーム上にあります。
@@ -1016,7 +1016,7 @@ Router がまだ実行前に価格付けできないモデルは、[事前見積
| `minimax/*` | 完了したビデオ | 12 時間 |
| `xai/*` | 生成されたすべての画像、および完了したビデオ | 24 時間 |
-これらの有効期間は、URL を開いたときではなく、URL が署名されたときに開始されます。キャッシュされた URL や再利用された URL は残り時間が短い場合があります。再利用しても有効期間は更新されません。アセットは速やかにダウンロードしてください。コピーされるのは各行に記載されたアセットのみです。`byteplus/seedream-*` と `byteplus/seededit-*` の画像は BytePlus ビデオの行には含まれません。
+これらの有効期間は、URL を開いたときではなく、URL が署名されたときに開始されます。キャッシュされた URL や再利用された URL は残り時間が短い場合があります。再利用しても有効期間は更新されません。`Idempotency-Key` の記録は、保持する URL より長く残ることがあるため、そうした URL の有効期限が切れる 1 時間前から、同じキーでの再試行は記録済みのレスポンスではなく `409 invalid_input` で応答されます。応答が返された時点ですでにそれだけ期限に近かった場合は、5 分間は再再生できます。アセットは速やかにダウンロードしてください。コピーされるのは各行に記載されたアセットのみです。`byteplus/seedream-*` と `byteplus/seededit-*` の画像は BytePlus ビデオの行には含まれません。
コピーを実行するのは、モデルのネイティブプロバイダーのみです。代替プロバイダーによって処理された実行、つまり `model_provider` が代替プロバイダーを指定している場合、またはネイティブ実行のフォールバック再試行が代替プロバイダーに到達した場合(`X-Comfy-Router-Fallback-Provider` で開示されます)は、そのプロバイダー自身の URL を返します。これらの URL はプロバイダーの有効期限に従い、コピーされません。`model_provider` の値 `default`、`comfy`、`comfyui` は代替プロバイダーを指定しないため、それらの実行はネイティブであり、上記と同様にコピーされます。フォールバック再試行がネイティブプロバイダーに戻った `model_provider` の実行も同様です。
@@ -1123,7 +1123,7 @@ Router がまだ実行前に価格付けできないモデルは、[事前見積
- この見積もりの価格設定に使用したレートカードを取得した日時。見積もりは価格ロックではありません。実行は、評価時点で有効な料金で請求され、この時点の料金ではありません。ベンダーの公開価格表から取得した `estimated` 見積もり(ベンダーが報告するコストで請求されるモデル)では、代わりにその価格表を読み取った日付を持ちます。請求数量をその価格表から予測し、その後レートカードで価格設定するもの(ベンダーが報告するクレジットで請求されるモデル)では、2 つの日付のうち古い方を持ちます。レートカードを読み取らなかった場合(`reason: pricing_unavailable`、`byok`、またはどのカードからも価格設定できない `not_quotable` の呼び出し)は、これは見積もりに回答した時点です。
+ この見積もりの価格設定に使用したレートカードを取得した日時。見積もりは価格ロックではありません。実行は、評価時点で有効な料金で請求され、この時点の料金ではありません。ベンダーの公開価格表から取得した `estimated` 見積もり(ベンダーが報告するコストで請求されるモデル)では、代わりにその価格表を読み取った日付を持ちます。請求数量をベンダーの公開スケジュールから予測し、その後レートカードで価格設定する見積もりは、`exact` の回答でも `estimated` の回答でも、そのスケジュールの読み取り日とカードの取得時刻のうち古い方を持ちます(ベンダーが報告するクレジットで請求されるモデルが `estimated` の場合です)。レートカードを読み取らなかった場合(`reason: pricing_unavailable`、`byok`、またはどのカードからも価格設定できない `not_quotable` の呼び出し)は、これは見積もりに回答した時点です。
date-time
@@ -1334,7 +1334,7 @@ Router モデルカタログの 1 ページ分です。
このルートが実際に解決したリクエストを表す2つの結果について、キャンセル要求が見つけた内容を示します。どちらもHTTPステータスに反映されるため、クライアントはどちらを基準に分岐してもかまいません。
-型: `文字列`
+型: `string`
### RouterQueuePosition
diff --git a/ko/development/comfy-router/api.mdx b/ko/development/comfy-router/api.mdx
index dfff2eac06..f205d1bf4d 100644
--- a/ko/development/comfy-router/api.mdx
+++ b/ko/development/comfy-router/api.mdx
@@ -2,7 +2,7 @@
title: "Comfy Router API 개요"
sidebarTitle: "개요"
description: "Comfy Router API의 작동 방식: 모델 ID당 하나의 라우트이며, 검색, 스키마, 대기 중인 요청, 오류, 결제에 대한 가이드를 제공합니다."
-translationSourceHash: dac7e853
+translationSourceHash: cb493feb
translationFrom: development/comfy-router/api.mdx
---
@@ -45,4 +45,5 @@ translationFrom: development/comfy-router/api.mdx
- [빠른 시작](/ko/development/comfy-router/quickstart): 설치, 호출, 이미지 저장.
- [모델](/ko/development/comfy-router/models): 카탈로그를 찾아보고 모델별 요청 예시를 확인합니다.
- [헤더](/ko/development/comfy-router/headers): 인증, 멱등성, 요청 ID, 재시도 간격 조정.
-- [API 레퍼런스](/ko/development/comfy-router/reference): 엔드포인트 파라미터, 스키마, 응답 코드.
\ No newline at end of file
+- [API 레퍼런스](/ko/development/comfy-router/reference): 엔드포인트 파라미터, 스키마, 응답 코드.
+- [실시간 음성](/ko/development/comfy-router/realtime): Grok Voice WebSocket 세션을 열고 초 단위로 과금됩니다.
diff --git a/ko/development/comfy-router/limitations.mdx b/ko/development/comfy-router/limitations.mdx
index 5fd22da5b6..2086187958 100644
--- a/ko/development/comfy-router/limitations.mdx
+++ b/ko/development/comfy-router/limitations.mdx
@@ -2,7 +2,7 @@
title: "Comfy Router 기능과 한계"
sidebarTitle: "기능과 한계"
description: "Comfy Router 또는 파트너 프록시 선택, 장시간 실행되는 호출 대비, 복구, 속도 제한 및 자산 저장에 대해 설명합니다."
-translationSourceHash: 235802c5
+translationSourceHash: b4d8209c
translationFrom: development/comfy-router/limitations.mdx
translationBlockHashes:
"_intro": 6b871cf3
@@ -14,7 +14,7 @@ translationBlockHashes:
"Requests are rate limited per caller": 249d4d51
"No progress while a call runs": 75d42d8d
"Comfy charges and usage": cf6e2050
- "Models without a pre-flight estimate": 495bdb2b
+ "Models without a pre-flight estimate": f6dfd921
"Router does not cover every partner operation": 786c0fb2
"Model outputs and stored assets": 06c737c1
"Next": be85b789
@@ -116,21 +116,17 @@ Router는 아직 아래 모델에 대한 호출 비용을 실행 전에 안정
{/* BEGIN GENERATED: models without a pre-flight estimate. Do not hand-edit; regenerate with -update-quote-coverage-docs. */}
- **bfl**: `bfl/erase-v1`, `bfl/video-edit-v1`, `bfl/video-upscale-v1`, `bfl/vto-v1`
-- **byteplus**: `byteplus/seed-audio-1.0`, `byteplus/seed-audio-1.0-multilingual`
-- **fal**: `fal/crystal-upscaler`, `fal/crystal-video-upscaler`, `fal/fal-gpt-image-2`, `fal/fal-gpt-image-2.5-flare`, `fal/fal-gpt-image-2.5-sunburst`, `fal/fal-nano-banana-2`, `fal/fal-nano-banana-pro`, `fal/fal-seedance-2.0`, `fal/fal-seedance-2.5`, `fal/flux-3-max`, `fal/patina`
+- **fal**: `fal/fal-seedance-2.0`, `fal/fal-seedance-2.5`
- **freepik**: `freepik/ai-image-upscaler-precision-v2`, `freepik/ai-skin-enhancer-creative`, `freepik/ai-skin-enhancer-faithful`, `freepik/ai-skin-enhancer-flexible`
- **heygen**: `heygen/starfish`
-- **ideogram**: `ideogram/ideogram-v3`, `ideogram/ideogram-v4`, `ideogram/p-image-ideogram`
-- **kling**: `kling/kling-3.0-turbo`, `kling/kling-image-o1`, `kling/kling-v2-5-turbo`, `kling/kling-v2-6`, `kling/kling-v3`, `kling/kling-v3-omni`, `kling/kling-video-o1`, `kling/videos-avatar-image2video`, `kling/videos-lip-sync`, `kling/videos-video-extend`
-- **luma**: `luma/photon-1`, `luma/photon-flash-1`
-- **meshy**: `meshy/animations`, `meshy/meshy-6`, `meshy/meshy-7`, `meshy/meshy-7.1`, `meshy/remesh`, `meshy/rigging`
+- **ideogram**: `ideogram/ideogram-v3`, `ideogram/ideogram-v4`
+- **kling**: `kling/kling-image-o1`, `kling/videos-avatar-image2video`, `kling/videos-lip-sync`, `kling/videos-video-extend`
- **moonvalley**: `moonvalley/image-to-video`, `moonvalley/text-to-video`, `moonvalley/video-to-video`
- **openai**: `openai/gpt-image-1.5`
- **openrouter**: `openrouter/chat-completions`
- **pika**: `pika/pika-gpt-image-2`, `pika/pika-nano-banana-2`, `pika/pika-nano-banana-pro`
- **runware**: `runware/runware-gpt-image-2`, `runware/runware-gpt-image-2.5-flare`, `runware/runware-gpt-image-2.5-sunburst`, `runware/runware-nano-banana-2`, `runware/runware-nano-banana-pro`, `runware/runware-seedance-2.0`, `runware/runware-seedance-2.5`
- **synclabs**: `synclabs/sync-3`
-- **veed**: `veed/clean-audio`, `veed/clean-audio-video`, `veed/fabric-1.0`, `veed/lipsync-2.0`, `veed/video-background-removal`, `veed/video-background-removal-fast`, `veed/video-background-removal-green-screen`
- **wavespeed**: `wavespeed/wavespeed-gpt-image-2`, `wavespeed/wavespeed-gpt-image-2.5-flare`, `wavespeed/wavespeed-gpt-image-2.5-sunburst`
{/* END GENERATED: models without a pre-flight estimate */}
diff --git a/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx b/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx
index 1df7667f38..831b21f68c 100644
--- a/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx
+++ b/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx
@@ -2,13 +2,13 @@
title: "Comfy Router로 Dreamina Seedance 2.0 260128 사용하기"
description: "Comfy Router를 통해 byteplus/dreamina-seedance-2-0-260128을 호출합니다. endpoint, 요청 형태, 그리고 Router가 반환하는 응답을 다룹니다."
sidebarTitle: "Dreamina Seedance 2.0 260128"
-translationSourceHash: 9604ca27
+translationSourceHash: 70ec471f
translationFrom: development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx
translationBlockHashes:
"_intro": 54eac94b
"Quick start": ca074ca5
"Serving providers": 74eb2a7c
- "Schema": 6c5da06a
+ "Schema": 8c0478c9
"Examples": 641c458b
---
@@ -294,10 +294,10 @@ Comfy 측 가드레일이며 BytePlus의 제약이 아닙니다. BytePlus는 텍
반환된 작업 ID를 `draft_task` 콘텐츠 항목에 전달하여 최종 1080p 비디오를 렌더링하십시오. Draft 작업 ID는 7일 동안 유효합니다.
-
- 비디오 재생 시간(초)입니다. Seedance 2.5: [4,30] 또는 -1(자동, 비디오 편집 작업은 -1만 지원). Seedance 2.0, 2.0 fast, 2.0 mini: [4,15] 또는 -1(자동). Seedance 1.5 pro: [4,12] 또는 -1. Seedance 1.0: [2,12].
+
+ 비디오 재생 시간(초)입니다. Seedance 2.0, 2.0 fast, 2.0 mini: [4,15] 또는 -1(자동).
- 범위: `2` ~ `30`
+ 가능한 값: `-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`, `13`, `14`, `15`
diff --git a/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx b/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx
index b552dadeb9..579142be5d 100644
--- a/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx
+++ b/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router로 Dreamina Seedance 2.0 Fast 260128 사용하기"
description: "Comfy Router를 통해 byteplus/dreamina-seedance-2-0-fast-260128을 호출합니다: endpoint, 요청 형태, 그리고 Router가 반환하는 응답을 설명합니다."
sidebarTitle: "Dreamina Seedance 2.0 Fast 260128"
-translationSourceHash: b02c6ed1
+translationSourceHash: 8036f4db
translationFrom: development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx
translationBlockHashes:
"_intro": e4deed0d
"Quick start": f5201dd4
- "Schema": e03c503a
+ "Schema": 90b60b2e
"Examples": 7714eccd
---
@@ -279,10 +279,10 @@ BytePlus의 제약이 아닌 Comfy 측 보호 장치입니다. BytePlus는 텍
반환된 작업 ID를 `draft_task` 콘텐츠 항목에 전달하여 최종 1080p 비디오를 렌더링하세요. Draft 작업 ID는 7일 동안 유효합니다.
-
- 비디오 재생 시간(초)입니다. Seedance 2.5: [4,30] 또는 -1 (자동, 비디오 편집 작업은 -1만 지원). Seedance 2.0, 2.0 fast 및 2.0 mini: [4,15] 또는 -1 (자동). Seedance 1.5 pro: [4,12] 또는 -1. Seedance 1.0: [2,12].
+
+ 비디오 재생 시간(초)입니다. Seedance 2.0, 2.0 fast, 2.0 mini: [4,15] 또는 -1(자동).
- 범위: `2` ~ `30`
+ 가능한 값: `-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`, `13`, `14`, `15`
diff --git a/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx b/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx
index 6d55390eba..46913536ea 100644
--- a/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx
+++ b/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx
@@ -2,18 +2,15 @@
title: "Comfy Router와 함께 Dreamina Seedance 2.0 Mini 사용하기"
description: "Comfy Router를 통해 byteplus/dreamina-seedance-2-0-mini를 호출합니다: endpoint, 요청 형태, 그리고 Router가 반환하는 응답을 다룹니다."
sidebarTitle: "Dreamina Seedance 2.0 Mini"
-translationSourceHash: 28c5c053
+translationSourceHash: a1d75c67
translationFrom: development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx
translationBlockHashes:
"_intro": 45ff5bfd
"Quick start": b0374f7d
- "Schema": 3c26a330
+ "Schema": ebf1fc3a
"Examples": db01067e
---
-
-
-
{/* GENERATED FILE. Generated from router-schemas/byteplus/dreamina-seedance-2-0-mini.json by `pnpm code-pages:gen`. */}
import RouterCodeFooter from "/snippets/ko/comfy-router/model-code-footer.mdx";
@@ -280,10 +277,10 @@ BytePlus 자체 검증기가 응답합니다. 실제 트래픽보다 훨씬 높
반환된 작업 ID를 `draft_task` 콘텐츠 항목에 전달하면 최종 1080p 비디오가 렌더링됩니다. Draft 작업 ID는 7일 동안 유효합니다.
-
- 비디오 재생 시간(초)입니다. Seedance 2.5: [4,30] 또는 -1 (자동, 비디오 편집 작업은 -1만 지원). Seedance 2.0, 2.0 fast, 2.0 mini: [4,15] 또는 -1 (자동). Seedance 1.5 pro: [4,12] 또는 -1. Seedance 1.0: [2,12].
+
+ 비디오 재생 시간(초)입니다. Seedance 2.0, 2.0 fast, 2.0 mini: [4,15] 또는 -1(자동).
- 범위: `2` ~ `30`
+ 가능한 값: `-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`, `13`, `14`, `15`
@@ -401,34 +398,9 @@ false: 생성된 비디오의 마지막 프레임 이미지를 반환하지 않
- The ID of the video generation task
+ 비디오 생성 작업의 ID
-Wait, I need to translate that too. Let me redo.
-
-"비디오 생성 작업의 ID"
-
-Then:
-model: "작업에서 사용한 모델의 이름과 버전"
-
-output_format: "생성된 비디오의 컨테이너 형식(mp4 또는 mov)으로, `content`의 형제 항목으로 최상위 레벨에서 반환됩니다. Seedance 비디오 작업 조회가 이 위치에서 값을 반환합니다. BytePlus의 자체 필드이며 변경 없이 그대로 전달됩니다."
-
-resolution: "생성된 비디오의 해상도(예: `1080p`)입니다. BytePlus의 자체 필드이며, 성공한 비디오 작업에서 반환되고 변경 없이 그대로 전달됩니다."
-
-seed: "작업에 실제로 사용된 생성 시드입니다. BytePlus의 자체 필드이며, 성공한 비디오 작업에서 반환되고 변경 없이 그대로 전달됩니다.\n\n 형식: `int64`"
-
-status: "작업의 상태\n\n 가능한 값: `queued`, `running`, `cancelled`, `succeeded`, `failed`, `expired`"
-
-updated_at: "작업이 마지막으로 업데이트된 시간입니다. 값은 초 단위의 UNIX 타임스탬프입니다."
-
-usage: "요청의 토큰 사용량"
-
-usage.completion_tokens: "모델이 생성한 토큰 수"
-
-usage.total_tokens: "비디오 생성 모델의 경우 입력 토큰 수는 계산되지 않고 0으로 기본 설정됩니다. 따라서 total_tokens = completion_tokens입니다."
-
-Note: "total_tokens = completion_tokens" - that's a label with `=`, keep it. Actually it says keep labelled items on own line; here it's inline in prose, keeping as is is fine. 비디오 생성 작업의 ID
-
작업에서 사용한 모델의 이름과 버전
diff --git a/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx b/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx
index e57578b988..0d3147eea6 100644
--- a/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx
+++ b/ko/development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx
@@ -2,13 +2,13 @@
title: "Comfy Router에서 Dreamina Seedance 2.5 260628 사용하기"
description: "Comfy Router를 통해 byteplus/dreamina-seedance-2-5-260628을 호출합니다: 엔드포인트, 요청 형태, Router가 반환하는 응답을 설명합니다."
sidebarTitle: "Dreamina Seedance 2.5 260628"
-translationSourceHash: 07fd9c64
+translationSourceHash: 3606fb83
translationFrom: development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx
translationBlockHashes:
"_intro": 4b5f4cec
"Quick start": a2bb8c28
"Serving providers": 197dd61a
- "Schema": 0a76af44
+ "Schema": d2c28a84
"Examples": 5465695b
---
@@ -291,10 +291,10 @@ BytePlus 자체 검증기가 대신 응답합니다. 실제 트래픽보다 훨
반환된 작업 ID를 `draft_task` 콘텐츠 항목에 전달하여 최종 1080p 비디오를 렌더링하세요. Draft 작업 ID는 7일 동안 유효합니다.
-
- 비디오 재생 시간(초)입니다. Seedance 2.5: [4,30] 또는 -1(자동, 비디오 편집 작업은 -1만 지원). Seedance 2.0, 2.0 fast 및 2.0 mini: [4,15] 또는 -1(자동). Seedance 1.5 pro: [4,12] 또는 -1. Seedance 1.0: [2,12].
+
+ 비디오 재생 시간(초)입니다. Seedance 2.5: [4,30] 또는 -1(자동).
- 범위: `2` ~ `30`
+ 가능한 값: `-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`, `13`, `14`, `15`, `16`, `17`, `18`, `19`, `20`, `21`, `22`, `23`, `24`, `25`, `26`, `27`, `28`, `29`, `30`
diff --git a/ko/development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx b/ko/development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx
index 6db703933c..f8ba4298d6 100644
--- a/ko/development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx
+++ b/ko/development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router로 Seedance 1.0 Pro 250528 사용하기"
description: "Comfy Router를 통해 byteplus/seedance-1-0-pro-250528을 호출합니다: 엔드포인트, 요청 형태, 그리고 Router가 반환하는 응답을 설명합니다."
sidebarTitle: "Seedance 1.0 Pro 250528"
-translationSourceHash: 450bbe6e
+translationSourceHash: 642f85ab
translationFrom: development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx
translationBlockHashes:
"_intro": e1a3501d
"Quick start": c762675f
- "Schema": fc979e05
+ "Schema": b57b84de
"Examples": 815d621e
---
@@ -275,10 +275,10 @@ v1 /proxy를 직접 호출할 경우에는 대신 BytePlus 자체 검증기가
반환된 작업 ID를 `draft_task` 콘텐츠 항목에 전달하면 최종 1080p 비디오를 렌더링합니다. Draft 작업 ID는 7일 동안 유효합니다.
-
- 비디오 재생 시간(초)입니다. Seedance 2.5: [4,30] 또는 -1(자동, 비디오 편집 작업은 -1만 지원). Seedance 2.0, 2.0 fast, 2.0 mini: [4,15] 또는 -1(자동). Seedance 1.5 pro: [4,12] 또는 -1. Seedance 1.0: [2,12].
+
+ 비디오 재생 시간(초)입니다. Seedance 1.0 pro, 1.0 pro fast: [2,12].
- 범위: `2` ~ `30`
+ 가능한 값: `2`, `3`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`
diff --git a/ko/development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx b/ko/development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx
index 4d7c40f493..80b0f0e982 100644
--- a/ko/development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx
+++ b/ko/development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router에서 Seedance 1.0 Pro Fast 251015 사용하기"
description: "Comfy Router를 통해 byteplus/seedance-1-0-pro-fast-251015를 호출하는 방법: 엔드포인트, 요청 형태, Router가 반환하는 응답을 설명합니다."
sidebarTitle: "Seedance 1.0 Pro Fast 251015"
-translationSourceHash: 43683424
+translationSourceHash: 61dd0135
translationFrom: development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx
translationBlockHashes:
"_intro": 451ffa4b
"Quick start": ec2a21ac
- "Schema": a882b2d8
+ "Schema": dd74b012
"Examples": 1469ab97
---
@@ -279,10 +279,10 @@ v1 /proxy를 직접 호출할 경우에는 BytePlus 자체 검증기가 대신
반환된 작업 ID를 `draft_task` 콘텐츠 항목에 전달하여 최종 1080p 비디오를 렌더링하세요. Draft 작업 ID는 7일 동안 유효합니다.
-
- 비디오 재생 시간(초)입니다. Seedance 2.5: [4,30] 또는 -1(자동, 비디오 편집 작업은 -1만 지원). Seedance 2.0, 2.0 fast 및 2.0 mini: [4,15] 또는 -1(자동). Seedance 1.5 pro: [4,12] 또는 -1. Seedance 1.0: [2,12].
+
+ 비디오 재생 시간(초)입니다. Seedance 1.0 pro, 1.0 pro fast: [2,12].
- 범위: `2` ~ `30`
+ 가능한 값: `2`, `3`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`
diff --git a/ko/development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx b/ko/development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx
index 13800db3cd..92ed015aea 100644
--- a/ko/development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx
+++ b/ko/development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router로 Seedance 1.5 Pro 251215 사용하기"
description: "Comfy Router를 통해 byteplus/seedance-1-5-pro-251215를 호출합니다: 엔드포인트, 요청 형태, 그리고 Router가 반환하는 응답을 설명합니다."
sidebarTitle: "Seedance 1.5 Pro 251215"
-translationSourceHash: 1d016721
+translationSourceHash: 2263b4cf
translationFrom: development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx
translationBlockHashes:
"_intro": 5f93a1f1
"Quick start": 71aafccf
- "Schema": 35f3b5dc
+ "Schema": f4d67fb6
"Examples": 7e73ac5c
---
@@ -279,10 +279,10 @@ v1 /proxy를 직접 호출하면 대신 BytePlus 자체 검증기가 응답합
반환된 작업 ID를 `draft_task` 콘텐츠 항목에 전달하여 최종 1080p 비디오를 렌더링하십시오. Draft 작업 ID는 7일 동안 유효합니다.
-
- 비디오 재생 시간(초)입니다. Seedance 2.5: [4,30] 또는 -1(자동, 비디오 편집 작업은 -1만 지원). Seedance 2.0, 2.0 fast 및 2.0 mini: [4,15] 또는 -1(자동). Seedance 1.5 pro: [4,12] 또는 -1. Seedance 1.0: [2,12].
+
+ 비디오 재생 시간(초)입니다. Seedance 1.5 pro: [4,12] 또는 -1(자동).
- 범위: `2` ~ `30`
+ 가능한 값: `-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`
diff --git a/ko/development/comfy-router/models/kling/kling-3-0-turbo/code.mdx b/ko/development/comfy-router/models/kling/kling-3-0-turbo/code.mdx
index fb407ea5de..70a8b7a1a4 100644
--- a/ko/development/comfy-router/models/kling/kling-3-0-turbo/code.mdx
+++ b/ko/development/comfy-router/models/kling/kling-3-0-turbo/code.mdx
@@ -2,13 +2,13 @@
title: "Comfy Router로 Kling 3.0 Turbo 사용하기"
description: "Comfy Router를 통해 kling/kling-3.0-turbo를 호출합니다. 엔드포인트, 요청 형태, Router가 반환하는 응답을 설명합니다."
sidebarTitle: "Kling 3.0 Turbo"
-translationSourceHash: 301a1ee1
+translationSourceHash: d03a4ba5
translationFrom: development/comfy-router/models/kling/kling-3-0-turbo/code.mdx
translationBlockHashes:
"_intro": 5a8c5f4b
"Quick start": a2145573
"Serving providers": 7ec93d4f
- "Schema": 1f5f61c1
+ "Schema": 4ec53894
"Examples": 0a9a8bbe
---
@@ -195,11 +195,11 @@ curl https://api.comfy.org/v2/models/kling/kling-3.0-turbo/requests/$REQUEST_ID
- 작업 결과에 대한 콜백 알림 URL입니다. 작업 상태가 변경되면 서버가 알림을 보냅니다.
+ 작업 결과에 대한 콜백 알림 URL입니다. 작업 상태가 변경되면 서버가 알림을 보냅니다. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
- 사용자 지정 작업 ID입니다. 시스템이 생성한 작업 ID를 덮어쓰지는 않지만 조회에 사용할 수 있습니다. 단일 사용자 계정 내에서 고유해야 합니다.
+ 사용자 지정 작업 ID입니다. 시스템이 생성한 작업 ID를 덮어쓰지는 않지만 조회에 사용할 수 있습니다. 단일 사용자 계정 내에서 고유해야 합니다. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
@@ -253,11 +253,23 @@ curl https://api.comfy.org/v2/models/kling/kling-3.0-turbo/requests/$REQUEST_ID
- 소비 금액이며 소수점 둘째 자리까지 정확합니다.
+ 소비 금액. 소수점 이하 두 자리까지 정확합니다.
+
+
+
+ 요금이 차감된 현금 계정(charge_type이 "cash"일 때만 존재). 예: "balance". 일부 작업은 반환하고 일부는 생략할 수 있습니다.
- 소비 계정 유형입니다. "cash"는 잔액, "unit"은 리소스 패키지를 의미합니다.
+ 소비 계정 유형. "cash"는 잔액, "unit"은 리소스 패키지입니다.
+
+
+
+ `amount`와 `list_price`의 ISO 4217 통화 코드. 예: "USD". 일부 작업은 반환하고 일부는 생략할 수 있습니다.
+
+
+
+ 할인 전 작업 정가. 십진 문자열입니다. 일부 작업은 반환하고 일부는 생략할 수 있습니다.
diff --git a/ko/development/comfy-router/models/kling/kling-image-o1/code.mdx b/ko/development/comfy-router/models/kling/kling-image-o1/code.mdx
index 85e9483b17..38a2b57351 100644
--- a/ko/development/comfy-router/models/kling/kling-image-o1/code.mdx
+++ b/ko/development/comfy-router/models/kling/kling-image-o1/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router와 함께 Kling Image O1 사용하기"
description: "Comfy Router를 통해 kling/kling-image-o1 호출하기: 엔드포인트, 요청 형태, 그리고 Router가 반환하는 응답."
sidebarTitle: "Kling Image O1"
-translationSourceHash: cf053382
+translationSourceHash: 0d76917c
translationFrom: development/comfy-router/models/kling/kling-image-o1/code.mdx
translationBlockHashes:
"_intro": 513c65df
"Quick start": 6256a30d
- "Schema": d18a5393
+ "Schema": 61821697
"Examples": 826db173
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-image-o1/requests/$REQUEST_ID \
- 이 작업 결과에 대한 콜백 알림 주소입니다. 설정하면 작업 상태가 변경될 때 서버가 능동적으로 알림을 보냅니다.
+ 이 작업 결과에 대한 콜백 알림 주소입니다. 설정하면 작업 상태가 변경될 때 서버가 능동적으로 알림을 보냅니다. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
형식: `uri`
@@ -182,7 +182,7 @@ curl https://api.comfy.org/v2/models/kling/kling-image-o1/requests/$REQUEST_ID \
- 사용자 지정 작업 ID입니다. 단일 사용자 계정 내에서 고유해야 합니다.
+ 사용자 지정 작업 ID입니다. 단일 사용자 계정 내에서 고유해야 합니다. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
diff --git a/ko/development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx b/ko/development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx
index ac88236104..bd4708d308 100644
--- a/ko/development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx
+++ b/ko/development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router로 Kling V2.5 Turbo 사용하기"
description: "Comfy Router를 통해 kling/kling-v2-5-turbo를 호출합니다: 엔드포인트, 요청 형태, 그리고 Router가 반환하는 응답."
sidebarTitle: "Kling V2.5 Turbo"
-translationSourceHash: 1a5ec6e5
+translationSourceHash: 1671e7b6
translationFrom: development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx
translationBlockHashes:
"_intro": 2495a4d3
"Quick start": dc63b3ac
- "Schema": 68d50e72
+ "Schema": 3bcb036e
"Examples": 8623c725
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v2-5-turbo/requests/$REQUEST_ID
- 콜백 알림 주소
+ 콜백 알림 주소. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
형식: `uri`
@@ -236,7 +236,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v2-5-turbo/requests/$REQUEST_ID
- 사용자 정의 Task ID
+ 사용자 정의 Task ID. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
diff --git a/ko/development/comfy-router/models/kling/kling-v2-6/code.mdx b/ko/development/comfy-router/models/kling/kling-v2-6/code.mdx
index 893e68985e..414979a62a 100644
--- a/ko/development/comfy-router/models/kling/kling-v2-6/code.mdx
+++ b/ko/development/comfy-router/models/kling/kling-v2-6/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router로 Kling V2.6 사용하기"
description: "Comfy Router를 통해 kling/kling-v2-6을 호출합니다: 엔드포인트, 요청 형태, Router가 반환하는 응답."
sidebarTitle: "Kling V2.6"
-translationSourceHash: 1e64e957
+translationSourceHash: c445a7bd
translationFrom: development/comfy-router/models/kling/kling-v2-6/code.mdx
translationBlockHashes:
"_intro": 04868509
"Quick start": 48a3d970
- "Schema": 9d23ff94
+ "Schema": a61a551f
"Examples": 8623c725
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v2-6/requests/$REQUEST_ID \
- 콜백 알림 주소
+ 콜백 알림 주소. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
형식: `uri`
@@ -236,7 +236,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v2-6/requests/$REQUEST_ID \
- 사용자 정의 작업 ID
+ 사용자 정의 작업 ID. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
diff --git a/ko/development/comfy-router/models/kling/kling-v3-omni/code.mdx b/ko/development/comfy-router/models/kling/kling-v3-omni/code.mdx
index deae7364d7..0c0b5cdd04 100644
--- a/ko/development/comfy-router/models/kling/kling-v3-omni/code.mdx
+++ b/ko/development/comfy-router/models/kling/kling-v3-omni/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router로 Kling V3 Omni 사용하기"
description: "Comfy Router를 통해 kling/kling-v3-omni를 호출합니다: endpoint, 요청 형태, 그리고 Router가 반환하는 응답입니다."
sidebarTitle: "Kling V3 Omni"
-translationSourceHash: 226ee8a6
+translationSourceHash: 29d1799c
translationFrom: development/comfy-router/models/kling/kling-v3-omni/code.mdx
translationBlockHashes:
"_intro": 98827333
"Quick start": 3a226de2
- "Schema": f9b37353
+ "Schema": 68bd0500
"Examples": 6c2642d6
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v3-omni/requests/$REQUEST_ID \
- 이 작업의 결과에 대한 콜백 알림 주소입니다. 설정하면 작업 상태가 변경될 때 서버가 능동적으로 알림을 보냅니다.
+ 이 작업의 결과에 대한 콜백 알림 주소입니다. 설정하면 작업 상태가 변경될 때 서버가 능동적으로 알림을 보냅니다. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
형식: `uri`
@@ -188,7 +188,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v3-omni/requests/$REQUEST_ID \
- 사용자 정의 작업 ID입니다. 단일 사용자 계정 내에서 고유해야 합니다.
+ 사용자 정의 작업 ID입니다. 단일 사용자 계정 내에서 고유해야 합니다. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
diff --git a/ko/development/comfy-router/models/kling/kling-v3/code.mdx b/ko/development/comfy-router/models/kling/kling-v3/code.mdx
index 27d8caab71..5f65e76b50 100644
--- a/ko/development/comfy-router/models/kling/kling-v3/code.mdx
+++ b/ko/development/comfy-router/models/kling/kling-v3/code.mdx
@@ -2,13 +2,13 @@
title: "Comfy Router로 Kling V3 사용하기"
description: "Comfy Router를 통해 kling/kling-v3 호출하기: endpoint, 요청 형태, 그리고 Router가 반환하는 응답."
sidebarTitle: "Kling V3"
-translationSourceHash: ecfa3f9b
+translationSourceHash: e07d4035
translationFrom: development/comfy-router/models/kling/kling-v3/code.mdx
translationBlockHashes:
"_intro": 74a12e0f
"Quick start": 09c0a41a
"Serving providers": a8b20c72
- "Schema": 77550c0a
+ "Schema": 8e8b04e6
"Examples": 8623c725
---
@@ -177,7 +177,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v3/requests/$REQUEST_ID \
- 콜백 알림 주소
+ 콜백 알림 주소. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
형식: `uri`
@@ -247,7 +247,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v3/requests/$REQUEST_ID \
- 사용자 정의 작업 ID
+ 사용자 정의 작업 ID. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
diff --git a/ko/development/comfy-router/models/kling/kling-video-o1/code.mdx b/ko/development/comfy-router/models/kling/kling-video-o1/code.mdx
index f80a82c880..dacb6a13f1 100644
--- a/ko/development/comfy-router/models/kling/kling-video-o1/code.mdx
+++ b/ko/development/comfy-router/models/kling/kling-video-o1/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router로 Kling Video O1 사용하기"
description: "Comfy Router를 통해 kling/kling-video-o1 호출: endpoint, 요청 형태, 그리고 Router가 반환하는 응답."
sidebarTitle: "Kling Video O1"
-translationSourceHash: 3c228231
+translationSourceHash: 892ccf77
translationFrom: development/comfy-router/models/kling/kling-video-o1/code.mdx
translationBlockHashes:
"_intro": a36df86f
"Quick start": 2dd48300
- "Schema": 6f4cf55b
+ "Schema": f693e2ef
"Examples": 6c2642d6
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-video-o1/requests/$REQUEST_ID \
- 이 작업 결과에 대한 콜백 알림 주소입니다. 설정하면 작업 상태가 변경될 때 서버가 능동적으로 알림을 보냅니다.
+ 이 작업 결과에 대한 콜백 알림 주소입니다. 설정하면 작업 상태가 변경될 때 서버가 능동적으로 알림을 보냅니다. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
형식: `uri`
@@ -188,7 +188,7 @@ curl https://api.comfy.org/v2/models/kling/kling-video-o1/requests/$REQUEST_ID \
- 사용자 정의 작업 ID입니다. 단일 사용자 계정 내에서 고유해야 합니다.
+ 사용자 정의 작업 ID입니다. 단일 사용자 계정 내에서 고유해야 합니다. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
diff --git a/ko/development/comfy-router/models/kling/videos-avatar-image2video/code.mdx b/ko/development/comfy-router/models/kling/videos-avatar-image2video/code.mdx
index 5e9cf499b4..7de123135c 100644
--- a/ko/development/comfy-router/models/kling/videos-avatar-image2video/code.mdx
+++ b/ko/development/comfy-router/models/kling/videos-avatar-image2video/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router로 Videos Avatar Image 2video 사용하기"
description: "Comfy Router를 통해 kling/videos-avatar-image2video를 호출합니다: 엔드포인트, 요청 형태, Router가 반환하는 응답입니다."
sidebarTitle: "Videos Avatar Image 2video"
-translationSourceHash: 444b1395
+translationSourceHash: 5181e917
translationFrom: development/comfy-router/models/kling/videos-avatar-image2video/code.mdx
translationBlockHashes:
"_intro": baca1542
"Quick start": 5605d33f
- "Schema": eeb06fe1
+ "Schema": 073bf8b2
"Examples": ce6803dd
---
@@ -164,13 +164,13 @@ curl https://api.comfy.org/v2/models/kling/videos-avatar-image2video/requests/$R
- 이 작업의 결과에 대한 콜백 알림 주소입니다.
+ 이 작업의 결과에 대한 콜백 알림 주소입니다. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
형식: `uri`
- 사용자 지정 작업 ID입니다. 단일 사용자 계정 내에서 고유해야 합니다.
+ 사용자 지정 작업 ID입니다. 단일 사용자 계정 내에서 고유해야 합니다. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
diff --git a/ko/development/comfy-router/models/kling/videos-lip-sync/code.mdx b/ko/development/comfy-router/models/kling/videos-lip-sync/code.mdx
index 8ea8d2d235..f55922e978 100644
--- a/ko/development/comfy-router/models/kling/videos-lip-sync/code.mdx
+++ b/ko/development/comfy-router/models/kling/videos-lip-sync/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router로 Videos Lip Sync 사용하기"
description: "Comfy Router를 통해 kling/videos-lip-sync를 호출합니다. endpoint, 요청 형태, 그리고 Router가 반환하는 응답을 설명합니다."
sidebarTitle: "Videos Lip Sync"
-translationSourceHash: ddd2a405
+translationSourceHash: 6103bea9
translationFrom: development/comfy-router/models/kling/videos-lip-sync/code.mdx
translationBlockHashes:
"_intro": 0477697a
"Quick start": e13a4628
- "Schema": 90571e9f
+ "Schema": 4fb7c777
"Examples": d1dd6ed8
---
@@ -176,7 +176,7 @@ curl https://api.comfy.org/v2/models/kling/videos-lip-sync/requests/$REQUEST_ID
### 입력
- 콜백 알림 주소입니다. 작업 상태가 변경되면 서버가 알림을 보냅니다.
+ 콜백 알림 주소입니다. 작업 상태가 변경되면 서버가 알림을 보냅니다. 무시됨: comfy-api가 전달 전에 이 필드를 제거하며, Comfy Router가 대신 폴링합니다.
형식: `uri`
diff --git a/ko/development/comfy-router/models/runway/gen4-image/code.mdx b/ko/development/comfy-router/models/runway/gen4-image/code.mdx
index 676ca6d9aa..6b5f0cd535 100644
--- a/ko/development/comfy-router/models/runway/gen4-image/code.mdx
+++ b/ko/development/comfy-router/models/runway/gen4-image/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router로 Gen 4 Image 사용하기"
description: "Comfy Router를 통해 runway/gen4_image를 호출합니다: 엔드포인트, 요청 형태, Router가 반환하는 응답을 설명합니다."
sidebarTitle: "Gen 4 Image"
-translationSourceHash: c5792f5c
+translationSourceHash: 51dc9815
translationFrom: development/comfy-router/models/runway/gen4-image/code.mdx
translationBlockHashes:
"_intro": f3b89ce9
"Quick start": 82a202eb
- "Schema": d889abf3
+ "Schema": 1160ec6d
"Examples": 291dbf54
---
@@ -168,7 +168,7 @@ curl https://api.comfy.org/v2/models/runway/gen4_image/requests/$REQUEST_ID \
- 인코딩된 이미지를 포함하는 HTTPS URL 또는 데이터 URI
+ 인코딩된 이미지를 포함하는 HTTPS URL, Runway 업로드 URI(runway://) 또는 data URI
Router가 `GET /v2/models/runway/gen4_image/openapi.json`에서 제공하는 스키마에서 생성되었으며, 이는 요청이 공급자에 도달하기 전에 호출을 검증하는 데 사용하는 동일한 문서입니다.
diff --git a/ko/development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx b/ko/development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx
index bb47c8467f..b54aa6f881 100644
--- a/ko/development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx
+++ b/ko/development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router에서 Grok Imagine Image 2.0 사용하기"
description: "Comfy Router를 통해 xai/grok-imagine-image-2.0을 호출합니다: 엔드포인트, 요청 형태, 그리고 Router가 반환하는 응답."
sidebarTitle: "Grok Imagine Image 2.0"
-translationSourceHash: 83fe91a1
+translationSourceHash: e062dc40
translationFrom: development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx
translationBlockHashes:
"_intro": 614e2e15
"Quick start": ff9945c8
- "Schema": faf9e081
+ "Schema": cb29dfae
"Examples": 3222291b
---
@@ -172,9 +172,9 @@ curl https://api.comfy.org/v2/models/xai/grok-imagine-image-2.0/requests/$REQUES
- 출력 이미지의 품질입니다. grok-imagine-image-2.0의 경우 가격 등급(low/medium, 기본값은 medium)을 선택합니다. 다른 모델은 현재 이 값을 무시합니다.
+ 출력 이미지의 품질입니다. grok-imagine-image-2.0의 경우 가격 등급을 선택합니다(low, medium 또는 auto, 생략 시 xAI의 기본값이며 auto는 생성 시 low, 편집 시 medium 사용). 다른 모델은 이를 무시합니다.
- 가능한 값: `low`, `medium`, `high`
+ 가능한 값: `low`, `medium`, `high`, `auto`
diff --git a/ko/development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx b/ko/development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx
index 441313b906..b67a36c6bf 100644
--- a/ko/development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx
+++ b/ko/development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router로 Grok Imagine Image Pro 사용하기"
description: "Comfy Router를 통해 xai/grok-imagine-image-pro를 호출합니다: endpoint, 요청 형태, 그리고 Router가 반환하는 응답."
sidebarTitle: "Grok Imagine Image Pro"
-translationSourceHash: 7932bb72
+translationSourceHash: 773b1560
translationFrom: development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx
translationBlockHashes:
"_intro": 97d341e4
"Quick start": 3a4bd585
- "Schema": 5d56d158
+ "Schema": 805c771c
"Examples": 3222291b
---
@@ -172,9 +172,9 @@ curl https://api.comfy.org/v2/models/xai/grok-imagine-image-pro/requests/$REQUES
- 출력 이미지의 품질입니다. grok-imagine-image-2.0의 경우 가격 등급(low/medium, 기본값은 medium)을 선택합니다. 다른 모델은 현재 이를 무시합니다.
+ 출력 이미지의 품질입니다. grok-imagine-image-2.0의 경우 가격 등급을 선택합니다(low, medium 또는 auto, 생략 시 xAI의 기본값이며 auto는 생성 시 low, 편집 시 medium 사용). 다른 모델은 이를 무시합니다.
- 가능한 값: `low`, `medium`, `high`
+ 가능한 값: `low`, `medium`, `high`, `auto`
diff --git a/ko/development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx b/ko/development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx
index eb1ef0f56e..80b048b5ae 100644
--- a/ko/development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx
+++ b/ko/development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router로 Grok Imagine Image Quality 사용하기"
description: "Comfy Router를 통해 xai/grok-imagine-image-quality를 호출합니다: endpoint, 요청 형태, 그리고 Router가 반환하는 응답입니다."
sidebarTitle: "Grok Imagine Image Quality"
-translationSourceHash: 923968d2
+translationSourceHash: 9f6e16d5
translationFrom: development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx
translationBlockHashes:
"_intro": 72081c22
"Quick start": 799275b8
- "Schema": e0fcef44
+ "Schema": e2c96ff6
"Examples": 3222291b
---
@@ -172,9 +172,9 @@ curl https://api.comfy.org/v2/models/xai/grok-imagine-image-quality/requests/$RE
- 출력 이미지의 품질입니다. grok-imagine-image-2.0의 경우 가격 등급을 선택합니다(low/medium, 기본값은 medium). 다른 모델은 현재 이 값을 무시합니다.
+ 출력 이미지의 품질입니다. grok-imagine-image-2.0의 경우 가격 등급을 선택합니다(low, medium 또는 auto, 생략 시 xAI의 기본값이며 auto는 생성 시 low, 편집 시 medium 사용). 다른 모델은 이를 무시합니다.
- 가능한 값: `low`, `medium`, `high`
+ 가능한 값: `low`, `medium`, `high`, `auto`
diff --git a/ko/development/comfy-router/models/xai/grok-imagine-image/code.mdx b/ko/development/comfy-router/models/xai/grok-imagine-image/code.mdx
index 75afa4df95..387a7232ac 100644
--- a/ko/development/comfy-router/models/xai/grok-imagine-image/code.mdx
+++ b/ko/development/comfy-router/models/xai/grok-imagine-image/code.mdx
@@ -2,12 +2,12 @@
title: "Comfy Router로 Grok Imagine Image 사용하기"
description: "Comfy Router를 통해 xai/grok-imagine-image를 호출합니다: 엔드포인트, 요청 형태, 그리고 Router가 반환하는 응답을 설명합니다."
sidebarTitle: "Grok Imagine Image"
-translationSourceHash: 9cfb938a
+translationSourceHash: 2e5c55ad
translationFrom: development/comfy-router/models/xai/grok-imagine-image/code.mdx
translationBlockHashes:
"_intro": a2e97c88
"Quick start": a5495331
- "Schema": 1d17b83a
+ "Schema": 171da7d5
"Examples": 3222291b
---
@@ -172,9 +172,9 @@ curl https://api.comfy.org/v2/models/xai/grok-imagine-image/requests/$REQUEST_ID
- 출력 이미지의 품질입니다. grok-imagine-image-2.0의 경우 가격 등급을 선택합니다(low/medium, 기본값은 medium). 다른 모델은 현재 이 값을 무시합니다.
+ 출력 이미지의 품질입니다. grok-imagine-image-2.0의 경우 가격 등급을 선택합니다(low, medium 또는 auto, 생략 시 xAI의 기본값이며 auto는 생성 시 low, 편집 시 medium 사용). 다른 모델은 이를 무시합니다.
- 가능한 값: `low`, `medium`, `high`
+ 가능한 값: `low`, `medium`, `high`, `auto`
diff --git a/ko/development/comfy-router/queue.mdx b/ko/development/comfy-router/queue.mdx
index 3f17f8df57..3667b70ef1 100644
--- a/ko/development/comfy-router/queue.mdx
+++ b/ko/development/comfy-router/queue.mdx
@@ -270,7 +270,7 @@ async with AsyncComfy() as client:
- **동기 경로와 동일한 과금.** 공급자가 Comfy에 과금할 때 과금됩니다. 실행 대기열에서 대기한 시간은 과금되지 않습니다.
- **제출당 하나의 `Idempotency-Key`.** SDK는 `submit` 호출마다 새로운 키를 생성하므로, 같은 입력을 의도적으로 두 번 제출하면 두 개의 요청이 됩니다. 동일한 키로 같은 호출을 재시도해도 두 번째 실행이 실행 대기열에 들어가지 않습니다. 대신 원본 핸들을 `Idempotent-Replayed: true`와 함께 반환합니다. 응답을 잃어버려 `request_id`를 놓칠 수 있는 상황이라면 직접 키를 전달하세요. [헤더](/ko/development/comfy-router/headers)를 참고하세요.
- **결과는 만료됩니다.** 완료된 요청은 완료 후 24시간 동안 보관됩니다. 그 이후에는 상태 및 결과 조회가 `410`을 응답하고 결과는 사라집니다. 신속하게 수집하고 출력에 담긴 에셋 URL을 다운로드하세요.
-- **폴링도 요청입니다.** 상태 및 결과 조회는 [호출자별 요청 비율](/ko/development/comfy-router/limitations#요청은-호출자별로-속도-제한됨)에 포함됩니다. 짧은 고정 간격으로 폴링하기보다 `Retry-After`를 따르세요.
+- **폴링도 요청입니다.** 상태 및 결과 조회는 [호출자별 요청 비율](/ko/development/comfy-router/limitations#요청은-호출자별로-속도-제한됩니다)에 포함됩니다. 짧은 고정 간격으로 폴링하기보다 `Retry-After`를 따르세요.
## 실행 대기열 오류 응답
diff --git a/ko/development/comfy-router/realtime.mdx b/ko/development/comfy-router/realtime.mdx
new file mode 100644
index 0000000000..2b09050145
--- /dev/null
+++ b/ko/development/comfy-router/realtime.mdx
@@ -0,0 +1,224 @@
+---
+title: "Comfy Router 실시간 음성 세션"
+sidebarTitle: "실시간 음성"
+description: "Comfy Router를 통해 Grok Voice 실시간 WebSocket 세션을 엽니다. 엔드포인트, 인증, 초당 요금, 세션 제한, 그리고 발생할 수 있는 오류와 종료 코드를 다룹니다."
+translationSourceHash: e4024a38
+translationFrom: development/comfy-router/realtime.mdx
+translationBlockHashes:
+ "_intro": a85f88e5
+ "Endpoint": 2ae36abf
+ "Authentication": 582120fe
+ "Connect": b61ae8c6
+ "Events": a3ac8c47
+ "Pricing": 25d35f6c
+ "Limits": 85e21dff
+ "Errors": 3085ba65
+ "Next": 3e8c1bd8
+---
+
+Comfy Router는 fal이 제공하는 xAI의 Grok Voice와 실시간 음성 대 음성 세션을 중계합니다. Comfy API 키를 사용해 Router에 WebSocket 하나를 엽니다. Router는 계정과 크레딧을 확인하고, 업스트림에서 세션을 연 뒤 양방향으로 이벤트를 중계합니다. 세션 시간(초)만큼 Comfy 크레딧에서 비용이 차감됩니다.
+
+## 엔드포인트
+
+```text
+wss://api.comfy.org/v2/realtime/fal/xai/grok-voice/realtime
+```
+
+요청은 WebSocket 업그레이드입니다 (`GET`과 `Connection: Upgrade`, `Upgrade: websocket` 포함). 그 외의 요청은 `426`으로 거부됩니다.
+
+## 인증
+
+업그레이드 요청의 헤더에 Comfy API 키를 `X-API-Key: comfyui-...` 또는 `Authorization: Bearer comfyui-...` 형식으로 전송하세요. Router는 쿼리 문자열이나 WebSocket 서브프로토콜에서 키를 읽지 않습니다.
+
+
+브라우저는 WebSocket에 헤더를 설정할 수 없으며, Comfy API 키는 절대 브라우저에 도달해서는 안 됩니다. 서버에서 세션을 열고 오디오를 브라우저로 직접 중계하세요.
+
+
+## 연결
+
+업그레이드가 성공하면 xAI가 Grok Voice에 대해 문서화한 실시간 이벤트를 주고받습니다. 이 예제는 세션을 구성하고, 텍스트 턴 하나를 전송하며, 수신하는 각 이벤트 유형을 출력합니다.
+
+
+
+```python Python
+# pip install websockets msgpack
+import asyncio
+import os
+
+import msgpack
+import websockets
+
+URL = "wss://api.comfy.org/v2/realtime/fal/xai/grok-voice/realtime"
+
+
+async def send(ws, event):
+ await ws.send(msgpack.packb(event))
+
+
+async def main():
+ async with websockets.connect(
+ URL,
+ additional_headers={"X-API-Key": os.environ["COMFY_API_KEY"]},
+ ) as ws:
+ await send(ws, {
+ "type": "session.update",
+ "session": {
+ "voice": "eve",
+ "instructions": "You are a helpful assistant.",
+ "turn_detection": {"type": "server_vad"},
+ },
+ })
+ await send(ws, {
+ "type": "conversation.item.create",
+ "item": {
+ "type": "message",
+ "role": "user",
+ "content": [{"type": "input_text", "text": "Hello!"}],
+ },
+ })
+ await send(ws, {"type": "response.create"})
+
+ async for message in ws:
+ if isinstance(message, str):
+ continue # fal 자체의 x-fal-message 프레임
+ event = msgpack.unpackb(message)
+ print(event["type"])
+ if event["type"] == "response.done":
+ break
+
+
+asyncio.run(main())
+```
+
+```javascript Node.js
+// npm install ws @msgpack/msgpack
+import WebSocket from "ws";
+import { encode, decode } from "@msgpack/msgpack";
+
+const ws = new WebSocket(
+ "wss://api.comfy.org/v2/realtime/fal/xai/grok-voice/realtime",
+ { headers: { "X-API-Key": process.env.COMFY_API_KEY } },
+);
+
+ws.on("unexpected-response", (req, res) => {
+ // 업그레이드가 거부되었습니다. JSON 본문에 사유가 표시됩니다.
+ let body = "";
+ res.on("data", (chunk) => (body += chunk));
+ res.on("end", () => console.error(res.statusCode, body));
+});
+
+const send = (event) => ws.send(encode(event));
+
+ws.on("open", () => {
+ send({
+ type: "session.update",
+ session: {
+ voice: "eve",
+ instructions: "You are a helpful assistant.",
+ turn_detection: { type: "server_vad" },
+ },
+ });
+ send({
+ type: "conversation.item.create",
+ item: {
+ type: "message",
+ role: "user",
+ content: [{ type: "input_text", text: "Hello!" }],
+ },
+ });
+ send({ type: "response.create" });
+});
+
+ws.on("message", (data, isBinary) => {
+ if (!isBinary) return; // fal 자체의 x-fal-message 프레임
+ const event = decode(data);
+ console.log(event.type);
+ if (event.type === "response.done") ws.close();
+});
+
+ws.on("close", (code) => console.log("closed", code));
+```
+
+
+
+작업이 끝나면 즉시 소켓을 닫으세요. 과금은 마지막 응답이 아니라 세션이 종료될 때까지 부과됩니다.
+
+## 이벤트
+
+Router는 자체 이벤트 프로토콜을 정의하지 않습니다. 서버 이벤트는 fal이 보내는 그대로 도착하며, Router가 허용하는 클라이언트 이벤트는 변경 없이 전달됩니다. 이벤트 목록, 세션 필드, 음성, 오디오 형식은 다음 문서를 참고하세요:
+
+- [xAI Speech to Speech](https://docs.x.ai/developers/model-capabilities/audio/speech-to-speech) 및 xAI의 [realtime event schema](https://docs.x.ai/voice-realtime.ws.json)
+- fal의 [Grok Voice realtime 모델 페이지](https://fal.ai/models/xai/grok-voice/realtime) 및 [API 페이지](https://fal.ai/models/xai/grok-voice/realtime/api)
+
+예제에서처럼 각 클라이언트 이벤트를 하나의 msgpack 바이너리 메시지로 전송하세요. 이는 fal의 realtime 클라이언트가 사용하는 프레이밍이며, 모델의 이벤트도 `session.created`로 시작하는 msgpack 바이너리 메시지로 같은 방식으로 돌아옵니다. fal은 `x-fal-message` 유형의 자체 JSON 텍스트 메시지(타이밍 정보)도 보내는데, 이는 건너뛰어도 됩니다. Router의 검사는 클라이언트 이벤트를 하나의 JSON 텍스트 메시지로도 허용하지만, 클라이언트에서 JSON을 테스트해 보지 않았다면 msgpack을 사용하세요.
+
+Router는 전달하기 전에 각 클라이언트 이벤트를 검사합니다:
+
+- **이벤트 유형:** `session.update`, `input_audio_buffer.append`, `input_audio_buffer.commit`, `input_audio_buffer.clear`, `conversation.item.create`, `conversation.item.delete`, `conversation.item.truncate`, `response.create`, `response.cancel`, 그리고 fal의 `x-fal-session.configure`.
+- **모델:** `session.update`의 `model`은 `grok-voice-latest`, `grok-voice-3.0`, `grok-voice-2.0` 중 하나여야 합니다.
+- **도구:** 클라이언트가 실행하는 함수 도구는 허용됩니다. 서버 측 도구(웹 검색, X 검색, 파일 검색, MCP)는 거부됩니다.
+- **미디어:** 이미지 및 비디오 입력은 거부됩니다. 세션은 음성과 텍스트만 지원합니다.
+- **크기:** 클라이언트 메시지 하나는 최대 1 MiB입니다.
+
+거부된 이벤트는 전달되지 않으며, Router는 종료 코드 `1008`로 세션을 닫습니다.
+
+## 가격
+
+세션 비용은 **초당 $0.0011869**입니다(분당 약 $0.0712, 초당 0.2504 크레딧, 분당 약 15.0 크레딧이며, 211 크레딧 = $1 USD 기준입니다). 세션이 열려 있는 동안 15초 증가분 단위로 청구되며, 마지막 부분 증가분은 초 단위로 올림하여 청구됩니다. 청구는 오디오가 흐르는지 여부와 관계없이 업그레이드 시점부터 소켓이 닫힐 때까지 이루어집니다.
+
+## 제한
+
+| 제한 | 값 |
+| --- | --- |
+| 계정당 세션 | 한 번에 하나의 세션만 열 수 있습니다. 두 번째 세션을 열면 `429`와 `router.realtime.session_already_live`가 반환됩니다. |
+| 세션 길이 | 최대 30분이며, 연결 시점의 보유 크레딧 잔액으로 감당할 수 있는 시간보다 길 수 없습니다. |
+| 세션 중 크레딧 | Router는 15초마다 잔액을 다시 확인하며, 잔액이 다음 1초를 감당할 수 없게 되면 세션을 종료합니다. |
+| 연결 빈도 | 각 업그레이드 시도는 다른 Router 호출과 공유되는 [호출자별 요청 속도](/ko/development/comfy-router/limitations#요청은-호출자별로-속도-제한됩니다)에 포함됩니다. |
+
+세션이 시간 제한에 도달하거나 크레딧이 소진되면 연결이 종료 프레임 없이 닫힐 수 있습니다(흔히 종료 코드 `1006`으로 표시됨). 크레딧을 충전한 이후에만 다시 연결하거나, 더 많은 시간이 필요하면 새 세션을 시작하세요.
+
+## 오류
+
+### 업그레이드 이전
+
+Router가 연결을 거부하면 프로토콜 전환 대신 HTTP 상태와 JSON 본문으로 응답합니다:
+
+```json
+{
+ "detail": "Insufficient credits to open a realtime session.",
+ "error_type": "insufficient_credits",
+ "code": "router.realtime.insufficient_credits"
+}
+```
+
+`code`를 기준으로 분기하세요. `detail`은 사람이 읽기 위한 정보입니다.
+
+| 상태 | `code` | 원인 | 해결 방법 |
+| --- | --- | --- | --- |
+| `426` | `router.realtime.upgrade_required` | 요청이 WebSocket 업그레이드가 아니었습니다. | WebSocket 클라이언트로 연결하세요. |
+| `401` | `router.realtime.unauthorized` | API 키가 누락되었거나 유효하지 않습니다. | `X-API-Key` 또는 `Authorization: Bearer`에 유효한 키를 보내세요. |
+| `402` | `router.realtime.insufficient_credits` | 잔액으로 최소 1초의 세션도 감당할 수 없습니다. | 크레딧을 추가한 뒤 다시 연결하세요. |
+| `402` | `router.realtime.spend_denied` | 세션 요금이 청구될 지갑에 자금이 없습니다. 본문의 `denied_reason`과 `billed_workspace`가 어느 지갑인지 알려줍니다. | 해당 워크스페이스에 크레딧을 추가한 뒤 다시 연결하세요. |
+| `403` | `router.realtime.provider_disabled` | 워크스페이스의 파트너 공급자 정책이 이 공급자를 허용하지 않습니다. | 워크스페이스 관리자에게 허용을 요청하세요. |
+| `404` | `router.realtime.model_not_allowed` | URL의 모델은 실시간 세션에서 사용할 수 없습니다. | URL을 확인하세요. |
+| `429` | `router.realtime.rate_limited` | 요청 속도를 초과했습니다. | `Retry-After`만큼 기다린 뒤 재시도하세요. |
+| `429` | `router.realtime.session_already_live` | 계정에 이미 다른 세션이 열려 있습니다. | 먼저 해당 세션을 닫으세요. |
+| `429` | `router.realtime.concurrency_limit` | 동시 파트너 모델 호출이 너무 많습니다. | 동시 작업을 줄이고 재시도하세요. |
+| `502` | `router.realtime.upstream_refused`, `router.realtime.token_mint_failed` | 업스트림 공급자가 세션을 열지 않았습니다. | 백오프를 두고 재시도하세요. |
+| `503` | 그 외 모든 `router.realtime.*` 코드 | 실시간 세션을 일시적으로 사용할 수 없습니다. | 백오프를 두고 재시도하세요. |
+
+### 업그레이드 이후
+
+| 종료 코드 | 의미 | 해결 방법 |
+| --- | --- | --- |
+| `1008` | 클라이언트 이벤트가 거부되었습니다([이벤트](#이벤트) 참조). | 이벤트를 수정하세요. 세션은 종료되었습니다. |
+| `1012` | Router가 재시작 중입니다. | 다시 연결하세요. 새 세션이 시작되며 새 업그레이드 시점부터 과금됩니다. |
+| `1006` (종료 프레임 없음) | 세션이 시간 제한에 도달했거나 크레딧이 소진되었을 때 클라이언트가 흔히 보고하는 코드입니다. 네트워크 끊김도 동일하게 보입니다. | 크레딧을 추가하거나 새 세션을 시작하세요. |
+
+그 외의 종료는 fal 또는 xAI에서 발생합니다. [이벤트](#이벤트)에 링크된 해당 문서를 참조하세요.
+
+## 다음
+
+- [청구](/ko/development/comfy-router/billing): Router가 요금을 부과하는 방식과 사용량을 대조하는 방법.
+- [오류 및 재시도](/ko/development/comfy-router/errors): 다른 Router 호출이 반환하는 오류 분류.
+- [제한 사항](/ko/development/comfy-router/limitations): 요청 속도 및 기타 제한.
diff --git a/ko/development/comfy-router/reference.mdx b/ko/development/comfy-router/reference.mdx
index 6547d5ccc3..c3bc0c37a9 100644
--- a/ko/development/comfy-router/reference.mdx
+++ b/ko/development/comfy-router/reference.mdx
@@ -2,17 +2,17 @@
title: "Comfy Router API 레퍼런스"
description: "Comfy API 계약에서 생성된 모든 Comfy Router 엔드포인트, 매개변수, 응답 본문 및 오류 버킷."
sidebarTitle: "API 레퍼런스"
-translationSourceHash: a6f99965
+translationSourceHash: aee933a1
translationFrom: development/comfy-router/reference.mdx
translationBlockHashes:
"_intro": 3f6e5d23
- "Endpoints": 222fd740
+ "Endpoints": e0879d3c
"Error buckets": 02a09cb4
"Response headers": 403c8bf5
- "Pre-flight cost estimates": 5952af3f
- "Result assets": 18fe6dad
+ "Pre-flight cost estimates": f0ba96a1
+ "Result assets": 5936427c
"Per-model input and output schemas": 61c6bde8
- "Schemas": 984bd216
+ "Schemas": c1245cc9
---
@@ -53,7 +53,7 @@ Comfy API 키는 Bearer 토큰으로도 전송할 수 있습니다. 두 자격
**Comfy Router가 실행할 수 있는 모델을 나열합니다.**
-사용 가능한 모델 ID와 청구 정보를 나열합니다. `has_more`가 `true`인 동안 `next_cursor`를 사용하세요.
+사용 가능한 모델 ID와 청구 정보를 나열합니다. `has_more`가 true인 동안 `next_cursor`를 사용하세요.
**파라미터**
@@ -309,7 +309,7 @@ Comfy API 키는 Bearer 토큰으로도 전송할 수 있습니다. 두 자격
**모델 호출을 실행하기 전에, 실행하지 않고 가격을 산정합니다.**
-이 모델에서 이 본문을 실행하면 얼마가 들지 미국 달러로 사전 견적하여 반환합니다. 가격은 실행 시 청구에 사용되는 것과 동일한 요율표를 기준으로 산정됩니다(공급업체가 보고한 비용으로 청구되는 모델은 대신 공급업체가 공개한 가격표를 기준으로 견적됩니다). 이는 견적일 뿐 최종 청구가 아닙니다. 실제로 지불하는 금액은 워크스페이스의 사용량 및 결제 기록에 정산된 청구액입니다. 본문은 먼저 모델의 입력 스키마에 대해 검증되며, 이는 기본 실행(`strict_mode` 없음, `reject_unknown_fields` 없음)이 검증하는 방식과 같습니다. 따라서 모델 스키마를 통과하지 못하는 본문은 실행 시와 동일하게 여기서도 `422`입니다. 공급자로 아무것도 전달되지 않으며 비용도 청구되지 않습니다. 이 응답은 가격을 고정하는 것이 아닙니다. `pricing_as_of` 시점에 유효한 요율로 산정되며, 실행은 요율 산정 시점에 유효한 요율로 청구됩니다. 이 기능이 순차 배포되는 동안 이 라우트는 `error_type: not_enabled`와 함께 `403`을 응답합니다.
+이 모델에서 이 본문을 실행하면 얼마가 들지 미국 달러로 사전 견적하여 반환합니다. 가격은 실행 시 청구에 사용되는 것과 동일한 요율표를 기준으로 산정됩니다(공급업체가 보고한 비용으로 청구되는 모델은 대신 공급업체가 공개한 가격표를 기준으로 견적됩니다). 이는 견적일 뿐 최종 청구가 아닙니다. 실제로 지불하는 금액은 워크스페이스의 사용량 및 결제 기록에 정산된 청구액입니다. 본문은 먼저 모델의 입력 스키마에 대해 검증되며, 이는 기본 실행(`strict_mode` 없음, `reject_unknown_fields` 없음)이 검증하는 방식과 같습니다. 따라서 모델 스키마를 통과하지 못하는 본문은 실행 시와 동일하게 여기서도 `422`입니다. 공급자로 아무것도 전달되지 않으며 비용도 청구되지 않습니다. 이 응답은 가격을 고정하는 것이 아닙니다. `pricing_as_of` 시점에 유효한 요율로 산정되며, 실행은 요율 산정 시점에 유효한 요율로 청구됩니다. 이 기능이 순차 배포되는 동안 이 라우트는 `error_type: not_enabled`와 함께 `403`을 응답합니다. 또한 Router가 아직 실행할 수 없는 모델은 실행 라우트 자체의 `detail`과 함께 동일한 `403`을 응답하므로, `detail`을 읽어 두 경우를 구분하세요.
**파라미터**
@@ -1000,10 +1000,11 @@ Router가 아직 실행 전에 가격을 산정할 수 없는 모델은 [실행
예상치의 한계. `200` 응답의 금액은 실행이 수락된다거나 정확히 그 금액이 청구된다는 약속이 아닙니다:
- `/estimate`는 `strict_mode`나 `reject_unknown_fields`를 받지 않으므로 모델의 기본 계약만 검사합니다. `strict_mode=true` 실행이 대체 공급자 자체 스키마에서 수락하는 본문이 여기서는 `422`를 받을 수 있고, `reject_unknown_fields=true` 실행이 거부할 선언되지 않은 최상위 필드도 여기서는 가격이 산정됩니다. Anthropic Messages 모델은 예외입니다. 해당 스키마는 선언되지 않은 필드를 허용하므로 `reject_unknown_fields=true` 실행도 아무것도 거부하지 않으며, 예상치는 선언되지 않은 최상위 필드 `tools`, `tool_choice`, `temperature`, `top_p`, `top_k`, `stop_sequences`, `metadata`, `thinking` 및 빈 `mcp_servers`에 대해서만 가격을 산정합니다. 그 밖의 선언되지 않은 최상위 필드가 있으면 `reason: not_quotable`과 함께 `unknown`을 응답합니다.
-- `pricing_as_of`는 요율표를 가져온 시점이며, 공급자의 공개 가격표에서 가져온 `estimated` 견적의 경우에는 그 가격표를 읽은 날짜입니다(둘 다 읽지 않은 경우에는 예상치를 응답한 시점입니다). 이는 가격 고정이 아닙니다. 실행은 요율이 적용되는 시점에 유효한 요율로 청구됩니다.
+- `pricing_as_of`는 요율표를 가져온 시점입니다. 공급자의 공개 가격표에서 가져온 `estimated` 견적은 그 가격표를 읽은 날짜를 담습니다. 청구 수량을 공급자의 공개 일정표에서 예측한 뒤 요율표로 가격을 매기는 `exact` 또는 `estimated` 견적은, 해당 일정표를 읽은 날짜가 요율표보다 이르면 그 날짜를 담습니다. 요율표와 일정표 모두 읽지 않은 경우에는 예상치를 응답한 시점입니다. 이는 가격 고정이 아닙니다. 실행은 요율이 적용되는 시점에 유효한 요율로 청구됩니다.
- `/estimate`는 `model_provider`가 지정한 레그 또는 기본 공급자의 견적을 제시합니다. `fallback_provider`나 `strict_mode` 매개변수는 받지 않습니다. 폴백 재시도가 다른 공급자에 도달한 동기 실행은 예상치가 제시하지 않았던 그 공급자의 요율로 청구되며, 실행 응답의 `X-Comfy-Router-Fallback-Provider`가 그런 일이 있었음을 알려줍니다. 대기 중 제출에는 폴백이 없으므로 그 `estimate`는 실제 실행되는 레그의 견적을 제시합니다.
- `/estimate`와 대기 중 제출의 `estimate`는 `model_provider` 레그에서 또는 형제 작업에서 실행되는 본문의 경우 동일한 본문에 대해 약간 다른 문서를 가격 산정할 수 있습니다. 제출의 `estimate`는 실행이 전송하는 문서를 기준으로 산정됩니다.
-- `/estimate`는 항상 플랫폼 청구액의 견적을 제시합니다. 자체 공급자 키로 실행하면 Comfy는 청구하지 않지만, `/estimate`는 이를 감지하지 못하고 여전히 금액을 반환합니다. `reason: byok`를 응답하는 것은 대기 중 제출뿐입니다.- 달러는 반올림되지 않은 센트 값을 기준으로 소수점 이하 최대 8자리까지 표시되며, 청구 가능한 1센트 미만의 `amount`는 절대 `0`으로 표시되지 않습니다. `credits`는 `round(amount × 211, 2)`이며, 이는 `X-Comfy-Credits-Used`가 청구 금액에 적용하는 것과 동일한 변환입니다. 따라서 매우 작은 0이 아닌 가격에서는 `credits`가 `0`으로 반올림될 수 있습니다. 이 점이 중요할 때는 `credits`가 아니라 `amount` 또는 `amount_cents`를 기준으로 예산을 책정하세요. 해당 헤더는 한 번의 실행에 대한 사후 수치로 남습니다. 잔액은 Comfy 플랫폼에 있습니다.
+- `/estimate`는 항상 플랫폼 청구액의 견적을 제시합니다. 자체 공급자 키로 실행하면 Comfy는 청구하지 않지만, `/estimate`는 이를 감지하지 못하고 여전히 금액을 반환합니다. `reason: byok`를 응답하는 것은 대기 중 제출뿐입니다.
+- 달러는 반올림되지 않은 센트 값을 기준으로 소수점 이하 최대 8자리까지 표시되며, 청구 가능한 1센트 미만의 `amount`는 절대 `0`으로 표시되지 않습니다. `credits`는 `round(amount × 211, 2)`이며, 이는 `X-Comfy-Credits-Used`가 청구 금액에 적용하는 것과 동일한 변환입니다. 따라서 매우 작은 0이 아닌 가격에서는 `credits`가 `0`으로 반올림될 수 있습니다. 이 점이 중요할 때는 `credits`가 아니라 `amount` 또는 `amount_cents`를 기준으로 예산을 책정하세요. 해당 헤더는 한 번의 실행에 대한 사후 수치로 남습니다. 잔액은 Comfy 플랫폼에 있습니다.
## 결과 에셋
@@ -1016,7 +1017,7 @@ Router가 아직 실행 전에 가격을 산정할 수 없는 모델은 [실행
| `minimax/*` | 완료된 비디오 | 12시간 |
| `xai/*` | 생성된 모든 이미지, 그리고 완료된 비디오 | 24시간 |
-이 수명은 URL에 서명될 때 시작되며, URL을 열 때 시작되는 것이 아닙니다. 캐시되었거나 재생된 URL은 남은 시간이 더 적을 수 있으며, 재생해도 수명이 갱신되지 않습니다. 에셋을 즉시 다운로드하세요. 각 행에 명시된 에셋만 복사됩니다. `byteplus/seedream-*` 및 `byteplus/seededit-*` 이미지는 BytePlus 비디오 행에 포함되지 않습니다.
+이 수명은 URL에 서명될 때 시작되며, URL을 열 때 시작되는 것이 아닙니다. 캐시되었거나 재생된 URL은 남은 시간이 더 적을 수 있으며, 재생해도 수명이 갱신되지 않습니다. `Idempotency-Key` 기록은 보유한 URL보다 오래 유지될 수 있으므로, 해당 URL이 만료되기 1시간 전부터 같은 키로 재시도하면 기록된 응답 대신 `409 invalid_input`이 응답됩니다. 응답이 반환될 때 이미 그만큼 만료에 가까웠던 경우에는 5분 동안 재생할 수 있습니다. 에셋을 즉시 다운로드하세요. 각 행에 명시된 에셋만 복사됩니다. `byteplus/seedream-*` 및 `byteplus/seededit-*` 이미지는 BytePlus 비디오 행에 포함되지 않습니다.
복사는 해당 모델의 네이티브 공급자만 수행합니다. 대체 공급자가 처리한 실행, 즉 `model_provider`가 대체 공급자를 지정한 경우나 폴백 재시도가 대체 공급자에 도달한 네이티브 실행(`X-Comfy-Router-Fallback-Provider`로 공개됨)은 해당 공급자 자체의 URL을 반환하며, 이 URL은 공급자의 만료 정책을 따르고 복사되지 않습니다. `model_provider` 값 `default`, `comfy`, `comfyui`는 대체 공급자를 지정하지 않으므로 해당 실행은 네이티브이며 위와 같이 복사됩니다. 폴백 재시도가 다시 네이티브 공급자에 도달한 `model_provider` 실행도 마찬가지입니다.
@@ -1123,7 +1124,7 @@ Type: `string`
- 이 견적을 산정한 요율표를 가져온 시점입니다. 이 추정치는 가격 고정이 아닙니다. 실행은 이 시점이 아니라 실행이 요율 산정되는 시점에 유효한 요율로 청구됩니다. 공급자의 공개 가격표에서 가져온 `estimated` 견적(공급자가 보고하는 비용으로 청구되는 모델)의 경우에는 대신 해당 가격표를 읽은 날짜가 담깁니다. 청구 수량을 그 가격표에서 예측한 뒤 요율표로 가격을 매기는 견적(공급자가 보고하는 크레딧으로 청구되는 모델)의 경우에는 두 날짜 중 이른 날짜가 담깁니다. 어떤 요율표도 읽지 않은 경우(`reason: pricing_unavailable`, `byok`, 또는 어떤 요율표로도 가격을 매길 수 없는 `not_quotable` 호출)에는 이 값이 견적이 응답된 시점입니다.
+ 이 견적을 산정한 요율표를 가져온 시점입니다. 이 추정치는 가격 고정이 아닙니다. 실행은 이 시점이 아니라 실행이 요율 산정되는 시점에 유효한 요율로 청구됩니다. 공급자의 공개 가격표에서 가져온 `estimated` 견적(공급자가 보고하는 비용으로 청구되는 모델)의 경우에는 대신 해당 가격표를 읽은 날짜가 담깁니다. 청구 수량을 공급자의 공개 일정표에서 예측한 뒤 요율표로 가격을 매기는 견적은 `exact` 답변이든 `estimated` 답변이든 해당 일정표를 읽은 날짜와 요율표를 가져온 시점 중 이른 날짜를 담습니다(공급자가 보고하는 크레딧으로 청구되는 모델이 `estimated`인 경우입니다). 어떤 요율표도 읽지 않은 경우(`reason: pricing_unavailable`, `byok`, 또는 어떤 요율표로도 가격을 매길 수 없는 `not_quotable` 호출)에는 이 값이 견적이 응답된 시점입니다.
date-time
diff --git a/snippets/es/intel-install.mdx b/snippets/es/intel-install.mdx
index 7d641ad1ac..97657e4955 100644
--- a/snippets/es/intel-install.mdx
+++ b/snippets/es/intel-install.mdx
@@ -5,4 +5,4 @@ Las GPU Intel Arc (Arc serie A, Arc serie B y procesadores Core Ultra con Arc Gr
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/xpu
```
-Asegúrate de que tu [controlador de GPU Intel](https://www.intel.com/content/www/us/en/developer/articles/tool/pytorch-prerequisites-for-intel-gpu.html) esté instalado y actualizado. No instales los wheels de CUDA. Si ComfyUI sigue sin detectar la GPU, consulta [solución de problemas de GPU Intel](/es/troubleshooting/overview#intel-gpu-issues).
\ No newline at end of file
+Asegúrate de que tu [controlador de GPU Intel](https://www.intel.com/content/www/us/en/developer/articles/tool/pytorch-prerequisites-for-intel-gpu.html) esté instalado y actualizado. No instales los wheels de CUDA. Si ComfyUI sigue sin detectar la GPU, consulta [solución de problemas de GPU Intel](/es/troubleshooting/overview#problemas-con-gpu-intel).
\ No newline at end of file
diff --git a/zh/development/comfy-router/api.mdx b/zh/development/comfy-router/api.mdx
index 63a66aff1a..32a3545b2e 100644
--- a/zh/development/comfy-router/api.mdx
+++ b/zh/development/comfy-router/api.mdx
@@ -2,7 +2,7 @@
title: "Comfy Router API 概览"
sidebarTitle: "概览"
description: "Comfy Router API 的工作方式:每个模型 ID 对应一个路由,并提供关于发现模型、schema、排队请求、错误和计费的指南。"
-translationSourceHash: dac7e853
+translationSourceHash: cb493feb
translationFrom: development/comfy-router/api.mdx
---
@@ -45,4 +45,5 @@ translationFrom: development/comfy-router/api.mdx
- [快速开始](/zh/development/comfy-router/quickstart):安装、调用以及保存图像。
- [模型](/zh/development/comfy-router/models):浏览目录并查看各模型专属的请求示例。
- [请求头](/zh/development/comfy-router/headers):身份验证、幂等性、请求 ID 以及重试节奏。
-- [API 参考](/zh/development/comfy-router/reference):端点参数、schema 以及响应码。
\ No newline at end of file
+- [API 参考](/zh/development/comfy-router/reference):端点参数、schema 以及响应码。
+- [实时语音](/zh/development/comfy-router/realtime):打开 Grok Voice WebSocket 会话,按秒计费。
diff --git a/zh/development/comfy-router/limitations.mdx b/zh/development/comfy-router/limitations.mdx
index f580a19c68..c445523018 100644
--- a/zh/development/comfy-router/limitations.mdx
+++ b/zh/development/comfy-router/limitations.mdx
@@ -2,7 +2,7 @@
title: "Comfy Router 的能力与限制"
sidebarTitle: "能力与限制"
description: "选择 Comfy Router 还是合作伙伴代理,为长时间运行的调用做好规划,并了解恢复、速率限制与资产存储。"
-translationSourceHash: 235802c5
+translationSourceHash: b4d8209c
translationFrom: development/comfy-router/limitations.mdx
translationBlockHashes:
"_intro": 6b871cf3
@@ -14,7 +14,7 @@ translationBlockHashes:
"Requests are rate limited per caller": 249d4d51
"No progress while a call runs": 75d42d8d
"Comfy charges and usage": cf6e2050
- "Models without a pre-flight estimate": 495bdb2b
+ "Models without a pre-flight estimate": f6dfd921
"Router does not cover every partner operation": 786c0fb2
"Model outputs and stored assets": 06c737c1
"Next": be85b789
@@ -116,21 +116,17 @@ Router 目前还无法在运行前可靠地为对以下模型的调用定价,
{/* BEGIN GENERATED: models without a pre-flight estimate. Do not hand-edit; regenerate with -update-quote-coverage-docs. */}
- **bfl**: `bfl/erase-v1`, `bfl/video-edit-v1`, `bfl/video-upscale-v1`, `bfl/vto-v1`
-- **byteplus**: `byteplus/seed-audio-1.0`, `byteplus/seed-audio-1.0-multilingual`
-- **fal**: `fal/crystal-upscaler`, `fal/crystal-video-upscaler`, `fal/fal-gpt-image-2`, `fal/fal-gpt-image-2.5-flare`, `fal/fal-gpt-image-2.5-sunburst`, `fal/fal-nano-banana-2`, `fal/fal-nano-banana-pro`, `fal/fal-seedance-2.0`, `fal/fal-seedance-2.5`, `fal/flux-3-max`, `fal/patina`
+- **fal**: `fal/fal-seedance-2.0`, `fal/fal-seedance-2.5`
- **freepik**: `freepik/ai-image-upscaler-precision-v2`, `freepik/ai-skin-enhancer-creative`, `freepik/ai-skin-enhancer-faithful`, `freepik/ai-skin-enhancer-flexible`
- **heygen**: `heygen/starfish`
-- **ideogram**: `ideogram/ideogram-v3`, `ideogram/ideogram-v4`, `ideogram/p-image-ideogram`
-- **kling**: `kling/kling-3.0-turbo`, `kling/kling-image-o1`, `kling/kling-v2-5-turbo`, `kling/kling-v2-6`, `kling/kling-v3`, `kling/kling-v3-omni`, `kling/kling-video-o1`, `kling/videos-avatar-image2video`, `kling/videos-lip-sync`, `kling/videos-video-extend`
-- **luma**: `luma/photon-1`, `luma/photon-flash-1`
-- **meshy**: `meshy/animations`, `meshy/meshy-6`, `meshy/meshy-7`, `meshy/meshy-7.1`, `meshy/remesh`, `meshy/rigging`
+- **ideogram**: `ideogram/ideogram-v3`, `ideogram/ideogram-v4`
+- **kling**: `kling/kling-image-o1`, `kling/videos-avatar-image2video`, `kling/videos-lip-sync`, `kling/videos-video-extend`
- **moonvalley**: `moonvalley/image-to-video`, `moonvalley/text-to-video`, `moonvalley/video-to-video`
- **openai**: `openai/gpt-image-1.5`
- **openrouter**: `openrouter/chat-completions`
- **pika**: `pika/pika-gpt-image-2`, `pika/pika-nano-banana-2`, `pika/pika-nano-banana-pro`
- **runware**: `runware/runware-gpt-image-2`, `runware/runware-gpt-image-2.5-flare`, `runware/runware-gpt-image-2.5-sunburst`, `runware/runware-nano-banana-2`, `runware/runware-nano-banana-pro`, `runware/runware-seedance-2.0`, `runware/runware-seedance-2.5`
- **synclabs**: `synclabs/sync-3`
-- **veed**: `veed/clean-audio`, `veed/clean-audio-video`, `veed/fabric-1.0`, `veed/lipsync-2.0`, `veed/video-background-removal`, `veed/video-background-removal-fast`, `veed/video-background-removal-green-screen`
- **wavespeed**: `wavespeed/wavespeed-gpt-image-2`, `wavespeed/wavespeed-gpt-image-2.5-flare`, `wavespeed/wavespeed-gpt-image-2.5-sunburst`
{/* END GENERATED: models without a pre-flight estimate */}
diff --git a/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx b/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx
index 4ddd53b499..763dfe84b5 100644
--- a/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx
+++ b/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx
@@ -2,13 +2,13 @@
title: "使用 Dreamina Seedance 2.0 260128 与 Comfy Router"
description: "通过 Comfy Router 调用 byteplus/dreamina-seedance-2-0-260128:端点、请求形状以及 Router 返回的响应。"
sidebarTitle: "Dreamina Seedance 2.0 260128"
-translationSourceHash: 9604ca27
+translationSourceHash: 70ec471f
translationFrom: development/comfy-router/models/byteplus/dreamina-seedance-2-0-260128/code.mdx
translationBlockHashes:
"_intro": 54eac94b
"Quick start": ca074ca5
"Serving providers": 74eb2a7c
- "Schema": 6c5da06a
+ "Schema": 8c0478c9
"Examples": 641c458b
---
@@ -287,10 +287,10 @@ Comfy 侧的保护措施,并非 BytePlus 的限制。BytePlus 未公布文本
将返回的任务 ID 传入 `draft_task` 内容项,以渲染最终的 1080p 视频。Draft 任务 ID 的有效期为 7 天。
-
- 视频时长(秒)。Seedance 2.5:[4,30] 或 -1(自动;视频编辑任务仅支持 -1)。Seedance 2.0、2.0 fast 和 2.0 mini:[4,15] 或 -1(自动)。Seedance 1.5 pro:[4,12] 或 -1。Seedance 1.0:[2,12]。
+
+ 视频时长,单位为秒。Seedance 2.0、2.0 fast 和 2.0 mini:[4,15] 或 -1(自动)。
- 范围:`2` 到 `30`
+ 可能的值:`-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`, `13`, `14`, `15`
diff --git a/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx b/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx
index e3b70a93fc..5ab516fef8 100644
--- a/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx
+++ b/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx
@@ -2,12 +2,12 @@
title: "使用 Comfy Router 调用 Dreamina Seedance 2.0 Fast 260128"
description: "通过 Comfy Router 调用 byteplus/dreamina-seedance-2-0-fast-260128:端点、请求结构以及 Router 返回的响应。"
sidebarTitle: "Dreamina Seedance 2.0 Fast 260128"
-translationSourceHash: b02c6ed1
+translationSourceHash: 8036f4db
translationFrom: development/comfy-router/models/byteplus/dreamina-seedance-2-0-fast-260128/code.mdx
translationBlockHashes:
"_intro": e4deed0d
"Quick start": f5201dd4
- "Schema": e03c503a
+ "Schema": 90b60b2e
"Examples": 7714eccd
---
@@ -271,10 +271,10 @@ Base64 编码内容:格式必须为 data:image/\;base64,\
将返回的任务 ID 传入 `draft_task` 内容项,以渲染最终的 1080p 视频。Draft 任务 ID 的有效期为 7 天。
-
- 视频时长,单位为秒。Seedance 2.5:[4,30] 或 -1(自动;视频编辑任务仅支持 -1)。Seedance 2.0、2.0 fast 和 2.0 mini:[4,15] 或 -1(自动)。Seedance 1.5 pro:[4,12] 或 -1。Seedance 1.0:[2,12]。
+
+ 视频时长,单位为秒。Seedance 2.0、2.0 fast 和 2.0 mini:[4,15] 或 -1(自动)。
- 范围:`2` 到 `30`
+ 可能的值:`-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`, `13`, `14`, `15`
diff --git a/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx b/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx
index 6995497779..d1474a43f1 100644
--- a/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx
+++ b/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx
@@ -2,12 +2,12 @@
title: "通过 Comfy Router 使用 Dreamina Seedance 2.0 Mini"
description: "通过 Comfy Router 调用 byteplus/dreamina-seedance-2-0-mini:endpoint、请求结构以及 Router 返回的响应。"
sidebarTitle: "Dreamina Seedance 2.0 Mini"
-translationSourceHash: 28c5c053
+translationSourceHash: a1d75c67
translationFrom: development/comfy-router/models/byteplus/dreamina-seedance-2-0-mini/code.mdx
translationBlockHashes:
"_intro": 45ff5bfd
"Quick start": b0374f7d
- "Schema": 3c26a330
+ "Schema": ebf1fc3a
"Examples": db01067e
---
@@ -278,10 +278,10 @@ Comfy Router(/v2/models/byteplus/\{model})是执行该限制的接口;
将返回的任务 ID 传入 `draft_task` 内容项,以渲染最终的 1080p 视频。Draft 任务 ID 有效期为 7 天。
-
- 视频时长,单位为秒。Seedance 2.5:[4,30] 或 -1(自动;视频编辑任务仅支持 -1)。Seedance 2.0、2.0 fast 和 2.0 mini:[4,15] 或 -1(自动)。Seedance 1.5 pro:[4,12] 或 -1。Seedance 1.0:[2,12]。
+
+ 视频时长,单位为秒。Seedance 2.0、2.0 fast 和 2.0 mini:[4,15] 或 -1(自动)。
- 范围:`2` 到 `30`
+ 可能的值:`-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`, `13`, `14`, `15`
diff --git a/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx b/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx
index 6b83dea46c..1aacbc9334 100644
--- a/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx
+++ b/zh/development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx
@@ -2,13 +2,13 @@
title: "使用 Dreamina Seedance 2.5 260628 与 Comfy Router"
description: "通过 Comfy Router 调用 byteplus/dreamina-seedance-2-5-260628:端点、请求形状以及 Router 返回的响应。"
sidebarTitle: "Dreamina Seedance 2.5 260628"
-translationSourceHash: 07fd9c64
+translationSourceHash: 3606fb83
translationFrom: development/comfy-router/models/byteplus/dreamina-seedance-2-5-260628/code.mdx
translationBlockHashes:
"_intro": 4b5f4cec
"Quick start": a2bb8c28
"Serving providers": 197dd61a
- "Schema": 0a76af44
+ "Schema": d2c28a84
"Examples": 5465695b
---
@@ -291,10 +291,10 @@ Base64 编码内容:格式必须为 data:image/\;base64,\
在 `draft_task` 内容项中传入返回的任务 ID,以渲染最终的 1080p 视频。Draft 任务 ID 有效期为 7 天。
-
- 视频时长,单位为秒。Seedance 2.5:[4,30] 或 -1(自动;视频编辑任务仅支持 -1)。Seedance 2.0、2.0 fast 与 2.0 mini:[4,15] 或 -1(自动)。Seedance 1.5 pro:[4,12] 或 -1。Seedance 1.0:[2,12]。
+
+ 视频时长,单位为秒。Seedance 2.5:[4,30] 或 -1(自动)。
- 范围:`2` 到 `30`
+ 可能的值:`-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`, `13`, `14`, `15`, `16`, `17`, `18`, `19`, `20`, `21`, `22`, `23`, `24`, `25`, `26`, `27`, `28`, `29`, `30`
diff --git a/zh/development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx b/zh/development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx
index 13ad884815..abebaade7b 100644
--- a/zh/development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx
+++ b/zh/development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx
@@ -2,12 +2,12 @@
title: "将 Seedance 1.0 Pro 250528 与 Comfy Router 配合使用"
description: "通过 Comfy Router 调用 byteplus/seedance-1-0-pro-250528:endpoint、请求形状以及 Router 返回的响应。"
sidebarTitle: "Seedance 1.0 Pro 250528"
-translationSourceHash: 450bbe6e
+translationSourceHash: 642f85ab
translationFrom: development/comfy-router/models/byteplus/seedance-1-0-pro-250528/code.mdx
translationBlockHashes:
"_intro": e1a3501d
"Quick start": c762675f
- "Schema": fc979e05
+ "Schema": b57b84de
"Examples": 815d621e
---
@@ -279,10 +279,10 @@ Comfy Router(/v2/models/byteplus/\{model})是执行该限制的接口;
将返回的任务 ID 传入 `draft_task` 内容项以渲染最终的 1080p 视频。Draft 任务 ID 的有效期为 7 天。
-
- 视频时长,单位为秒。Seedance 2.5:[4,30] 或 -1(自动;视频编辑任务仅支持 -1)。Seedance 2.0、2.0 fast 和 2.0 mini:[4,15] 或 -1(自动)。Seedance 1.5 pro:[4,12] 或 -1。Seedance 1.0:[2,12]。
+
+ 视频时长,单位为秒。Seedance 1.0 pro 和 1.0 pro fast:[2,12]。
- 范围:`2` 至 `30`
+ 可能的值:`2`, `3`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`
diff --git a/zh/development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx b/zh/development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx
index 573d9a16e9..e2daccec1b 100644
--- a/zh/development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx
+++ b/zh/development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx
@@ -2,12 +2,12 @@
title: "使用 Comfy Router 调用 Seedance 1.0 Pro Fast 251015"
description: "通过 Comfy Router 调用 byteplus/seedance-1-0-pro-fast-251015:endpoint、请求结构以及 Router 返回的响应。"
sidebarTitle: "Seedance 1.0 Pro Fast 251015"
-translationSourceHash: 43683424
+translationSourceHash: 61dd0135
translationFrom: development/comfy-router/models/byteplus/seedance-1-0-pro-fast-251015/code.mdx
translationBlockHashes:
"_intro": 451ffa4b
"Quick start": ec2a21ac
- "Schema": a882b2d8
+ "Schema": dd74b012
"Examples": 1469ab97
---
@@ -271,10 +271,10 @@ Comfy 侧的防护限制,并非 BytePlus 的约束。BytePlus 未公布文本
将返回的任务 ID 传入 `draft_task` 内容项,以渲染最终的 1080p 视频。Draft 任务 ID 的有效期为 7 天。
-
- 视频时长,单位为秒。Seedance 2.5:[4,30] 或 -1(自动;视频编辑任务仅支持 -1)。Seedance 2.0、2.0 fast 和 2.0 mini:[4,15] 或 -1(自动)。Seedance 1.5 pro:[4,12] 或 -1。Seedance 1.0:[2,12]。
+
+ 视频时长,单位为秒。Seedance 1.0 pro 和 1.0 pro fast:[2,12]。
- 范围:`2` 到 `30`
+ 可能的值:`2`, `3`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`
diff --git a/zh/development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx b/zh/development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx
index 42cabe70ab..c1747d7edb 100644
--- a/zh/development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx
+++ b/zh/development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx
@@ -2,12 +2,12 @@
title: "通过 Comfy Router 使用 Seedance 1.5 Pro 251215"
description: "通过 Comfy Router 调用 byteplus/seedance-1-5-pro-251215:endpoint、请求形状以及 Router 返回的响应。"
sidebarTitle: "Seedance 1.5 Pro 251215"
-translationSourceHash: 1d016721
+translationSourceHash: 2263b4cf
translationFrom: development/comfy-router/models/byteplus/seedance-1-5-pro-251215/code.mdx
translationBlockHashes:
"_intro": 5f93a1f1
"Quick start": 71aafccf
- "Schema": 35f3b5dc
+ "Schema": f4d67fb6
"Examples": 7e73ac5c
---
@@ -274,10 +274,10 @@ Base64 编码内容:格式必须为 data:image/\;base64,\
将返回的任务 ID 传入 `draft_task` 内容项,以渲染最终的 1080p 视频。草稿任务 ID 的有效期为 7 天。
-
- 视频时长,以秒为单位。Seedance 2.5:[4,30] 或 -1(自动;视频编辑任务仅支持 -1)。Seedance 2.0、2.0 fast 和 2.0 mini:[4,15] 或 -1(自动)。Seedance 1.5 pro:[4,12] 或 -1。Seedance 1.0:[2,12]。
+
+ 视频时长,单位为秒。Seedance 1.5 pro:[4,12] 或 -1(自动)。
- 范围:`2` 至 `30`
+ 可能的值:`-1`, `4`, `5`, `6`, `7`, `8`, `9`, `10`, `11`, `12`
diff --git a/zh/development/comfy-router/models/kling/kling-3-0-turbo/code.mdx b/zh/development/comfy-router/models/kling/kling-3-0-turbo/code.mdx
index 05ce84cd96..0606396725 100644
--- a/zh/development/comfy-router/models/kling/kling-3-0-turbo/code.mdx
+++ b/zh/development/comfy-router/models/kling/kling-3-0-turbo/code.mdx
@@ -2,13 +2,13 @@
title: "通过 Comfy Router 使用 Kling 3.0 Turbo"
description: "通过 Comfy Router 调用 kling/kling-3.0-turbo:endpoint、请求结构以及 Router 返回的响应。"
sidebarTitle: "Kling 3.0 Turbo"
-translationSourceHash: 301a1ee1
+translationSourceHash: d03a4ba5
translationFrom: development/comfy-router/models/kling/kling-3-0-turbo/code.mdx
translationBlockHashes:
"_intro": 5a8c5f4b
"Quick start": a2145573
"Serving providers": 7ec93d4f
- "Schema": 1f5f61c1
+ "Schema": 4ec53894
"Examples": 0a9a8bbe
---
@@ -195,11 +195,11 @@ curl https://api.comfy.org/v2/models/kling/kling-3.0-turbo/requests/$REQUEST_ID
- 任务结果回调通知 URL。当任务状态发生变化时,服务器会发送通知。
+ 任务结果回调通知 URL。当任务状态发生变化时,服务器会发送通知。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
- 自定义任务 ID。不会覆盖系统生成的任务 ID,但可用于查询。在单个用户账号内必须唯一。
+ 自定义任务 ID。不会覆盖系统生成的任务 ID,但可用于查询。在单个用户账号内必须唯一。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
@@ -256,10 +256,22 @@ curl https://api.comfy.org/v2/models/kling/kling-3.0-turbo/requests/$REQUEST_ID
消耗金额,精确到小数点后两位。
+
+ 扣款来自的现金账户(仅在 charge_type 为 "cash" 时出现),例如 "balance"。部分任务会返回该字段,部分可能省略。
+
+
消耗账户类型。"cash" 表示余额,"unit" 表示资源包。
+
+ `amount` 与 `list_price` 的 ISO 4217 货币代码,例如 "USD"。部分任务会返回该字段,部分可能省略。
+
+
+
+ 折扣前的任务标价,十进制字符串。部分任务会返回该字段,部分可能省略。
+
+
可消耗资源包类型(仅在 charge_type 为 "unit" 时存在)。取值为 "video"、"image" 或 "audio" 之一。
diff --git a/zh/development/comfy-router/models/kling/kling-image-o1/code.mdx b/zh/development/comfy-router/models/kling/kling-image-o1/code.mdx
index e3731aac5b..0e827348ac 100644
--- a/zh/development/comfy-router/models/kling/kling-image-o1/code.mdx
+++ b/zh/development/comfy-router/models/kling/kling-image-o1/code.mdx
@@ -2,12 +2,12 @@
title: "使用 Comfy Router 调用 Kling Image O1"
description: "通过 Comfy Router 调用 kling/kling-image-o1:端点、请求结构以及 Router 返回的响应。"
sidebarTitle: "Kling Image O1"
-translationSourceHash: cf053382
+translationSourceHash: 0d76917c
translationFrom: development/comfy-router/models/kling/kling-image-o1/code.mdx
translationBlockHashes:
"_intro": 513c65df
"Quick start": 6256a30d
- "Schema": d18a5393
+ "Schema": 61821697
"Examples": 826db173
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-image-o1/requests/$REQUEST_ID \
- 此任务结果的回调通知地址。若已配置,任务状态发生变化时服务器会主动通知。
+ 此任务结果的回调通知地址。若已配置,任务状态发生变化时服务器会主动通知。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
格式:`uri`
@@ -182,7 +182,7 @@ curl https://api.comfy.org/v2/models/kling/kling-image-o1/requests/$REQUEST_ID \
- 自定义任务 ID。在单个用户账户内必须唯一。
+ 自定义任务 ID。在单个用户账户内必须唯一。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
diff --git a/zh/development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx b/zh/development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx
index 711df496fd..8ecd5d5829 100644
--- a/zh/development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx
+++ b/zh/development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx
@@ -2,12 +2,12 @@
title: "将 Kling V2.5 Turbo 与 Comfy Router 搭配使用"
description: "通过 Comfy Router 调用 kling/kling-v2-5-turbo:端点、请求结构以及 Router 返回的响应。"
sidebarTitle: "Kling V2.5 Turbo"
-translationSourceHash: 1a5ec6e5
+translationSourceHash: 1671e7b6
translationFrom: development/comfy-router/models/kling/kling-v2-5-turbo/code.mdx
translationBlockHashes:
"_intro": 2495a4d3
"Quick start": dc63b3ac
- "Schema": 68d50e72
+ "Schema": 3bcb036e
"Examples": 8623c725
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v2-5-turbo/requests/$REQUEST_ID
- 回调通知地址
+ 回调通知地址。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
格式:`uri`
@@ -236,7 +236,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v2-5-turbo/requests/$REQUEST_ID
- 自定义任务 ID
+ 自定义任务 ID。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
diff --git a/zh/development/comfy-router/models/kling/kling-v2-6/code.mdx b/zh/development/comfy-router/models/kling/kling-v2-6/code.mdx
index ccfd89e64f..7a6ba616cc 100644
--- a/zh/development/comfy-router/models/kling/kling-v2-6/code.mdx
+++ b/zh/development/comfy-router/models/kling/kling-v2-6/code.mdx
@@ -2,12 +2,12 @@
title: "通过 Comfy Router 使用 Kling V2.6"
description: "通过 Comfy Router 调用 kling/kling-v2-6:端点、请求形状以及 Router 返回的响应。"
sidebarTitle: "Kling V2.6"
-translationSourceHash: 1e64e957
+translationSourceHash: c445a7bd
translationFrom: development/comfy-router/models/kling/kling-v2-6/code.mdx
translationBlockHashes:
"_intro": 04868509
"Quick start": 48a3d970
- "Schema": 9d23ff94
+ "Schema": a61a551f
"Examples": 8623c725
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v2-6/requests/$REQUEST_ID \
- 回调通知地址
+ 回调通知地址。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
格式:`uri`
@@ -236,7 +236,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v2-6/requests/$REQUEST_ID \
- 自定义任务 ID
+ 自定义任务 ID。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
diff --git a/zh/development/comfy-router/models/kling/kling-v3-omni/code.mdx b/zh/development/comfy-router/models/kling/kling-v3-omni/code.mdx
index 9bbff5063b..729411f1f0 100644
--- a/zh/development/comfy-router/models/kling/kling-v3-omni/code.mdx
+++ b/zh/development/comfy-router/models/kling/kling-v3-omni/code.mdx
@@ -2,12 +2,12 @@
title: "通过 Comfy Router 使用 Kling V3 Omni"
description: "通过 Comfy Router 调用 kling/kling-v3-omni:端点、请求结构以及 Router 返回的响应。"
sidebarTitle: "Kling V3 Omni"
-translationSourceHash: 226ee8a6
+translationSourceHash: 29d1799c
translationFrom: development/comfy-router/models/kling/kling-v3-omni/code.mdx
translationBlockHashes:
"_intro": 98827333
"Quick start": 3a226de2
- "Schema": f9b37353
+ "Schema": 68bd0500
"Examples": 6c2642d6
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v3-omni/requests/$REQUEST_ID \
- 本任务结果的回调通知地址。若配置此项,任务状态发生变化时服务器将主动通知。
+ 本任务结果的回调通知地址。若配置此项,任务状态发生变化时服务器将主动通知。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
格式:`uri`
@@ -188,7 +188,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v3-omni/requests/$REQUEST_ID \
- 自定义任务 ID。在单个用户账号内必须唯一。
+ 自定义任务 ID。在单个用户账号内必须唯一。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
diff --git a/zh/development/comfy-router/models/kling/kling-v3/code.mdx b/zh/development/comfy-router/models/kling/kling-v3/code.mdx
index 614cc72b20..c996013049 100644
--- a/zh/development/comfy-router/models/kling/kling-v3/code.mdx
+++ b/zh/development/comfy-router/models/kling/kling-v3/code.mdx
@@ -2,13 +2,13 @@
title: "通过 Comfy Router 使用 Kling V3"
description: "通过 Comfy Router 调用 kling/kling-v3:端点、请求形状以及 Router 返回的响应。"
sidebarTitle: "Kling V3"
-translationSourceHash: ecfa3f9b
+translationSourceHash: e07d4035
translationFrom: development/comfy-router/models/kling/kling-v3/code.mdx
translationBlockHashes:
"_intro": 74a12e0f
"Quick start": 09c0a41a
"Serving providers": a8b20c72
- "Schema": 77550c0a
+ "Schema": 8e8b04e6
"Examples": 8623c725
---
@@ -177,7 +177,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v3/requests/$REQUEST_ID \
- 回调通知地址
+ 回调通知地址。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
格式:`uri`
@@ -247,7 +247,7 @@ curl https://api.comfy.org/v2/models/kling/kling-v3/requests/$REQUEST_ID \
- 自定义任务 ID
+ 自定义任务 ID。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
diff --git a/zh/development/comfy-router/models/kling/kling-video-o1/code.mdx b/zh/development/comfy-router/models/kling/kling-video-o1/code.mdx
index 1fd6d2c0a4..da101120b5 100644
--- a/zh/development/comfy-router/models/kling/kling-video-o1/code.mdx
+++ b/zh/development/comfy-router/models/kling/kling-video-o1/code.mdx
@@ -2,12 +2,12 @@
title: "将 Kling Video O1 与 Comfy Router 配合使用"
description: "通过 Comfy Router 调用 kling/kling-video-o1:endpoint、请求结构以及 Router 返回的响应。"
sidebarTitle: "Kling Video O1"
-translationSourceHash: 3c228231
+translationSourceHash: 892ccf77
translationFrom: development/comfy-router/models/kling/kling-video-o1/code.mdx
translationBlockHashes:
"_intro": a36df86f
"Quick start": 2dd48300
- "Schema": 6f4cf55b
+ "Schema": f693e2ef
"Examples": 6c2642d6
---
@@ -166,7 +166,7 @@ curl https://api.comfy.org/v2/models/kling/kling-video-o1/requests/$REQUEST_ID \
- 本任务结果的回调通知地址。若已配置,任务状态发生变化时服务器会主动通知。
+ 本任务结果的回调通知地址。若已配置,任务状态发生变化时服务器会主动通知。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
格式:`uri`
@@ -188,7 +188,7 @@ curl https://api.comfy.org/v2/models/kling/kling-video-o1/requests/$REQUEST_ID \
- 自定义任务 ID。在单个用户账号内必须唯一。
+ 自定义任务 ID。在单个用户账号内必须唯一。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
diff --git a/zh/development/comfy-router/models/kling/videos-avatar-image2video/code.mdx b/zh/development/comfy-router/models/kling/videos-avatar-image2video/code.mdx
index f59763d31c..3794f1bde1 100644
--- a/zh/development/comfy-router/models/kling/videos-avatar-image2video/code.mdx
+++ b/zh/development/comfy-router/models/kling/videos-avatar-image2video/code.mdx
@@ -2,12 +2,12 @@
title: "配合 Comfy Router 使用 Videos Avatar Image 2video"
description: "通过 Comfy Router 调用 kling/videos-avatar-image2video:端点、请求结构以及 Router 返回的响应。"
sidebarTitle: "Videos Avatar Image 2video"
-translationSourceHash: 444b1395
+translationSourceHash: 5181e917
translationFrom: development/comfy-router/models/kling/videos-avatar-image2video/code.mdx
translationBlockHashes:
"_intro": baca1542
"Quick start": 5605d33f
- "Schema": eeb06fe1
+ "Schema": 073bf8b2
"Examples": ce6803dd
---
@@ -164,13 +164,13 @@ curl https://api.comfy.org/v2/models/kling/videos-avatar-image2video/requests/$R
- 本任务结果的回调通知地址。
+ 本任务结果的回调通知地址。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
格式:`uri`
- 自定义任务 ID。在单个用户账户内必须唯一。
+ 自定义任务 ID。在单个用户账户内必须唯一。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
diff --git a/zh/development/comfy-router/models/kling/videos-lip-sync/code.mdx b/zh/development/comfy-router/models/kling/videos-lip-sync/code.mdx
index de571505d6..5b8012fba0 100644
--- a/zh/development/comfy-router/models/kling/videos-lip-sync/code.mdx
+++ b/zh/development/comfy-router/models/kling/videos-lip-sync/code.mdx
@@ -2,12 +2,12 @@
title: "通过 Comfy Router 使用视频唇形同步"
description: "通过 Comfy Router 调用 kling/videos-lip-sync:端点、请求结构以及 Router 返回的响应。"
sidebarTitle: "视频唇形同步"
-translationSourceHash: ddd2a405
+translationSourceHash: 6103bea9
translationFrom: development/comfy-router/models/kling/videos-lip-sync/code.mdx
translationBlockHashes:
"_intro": 0477697a
"Quick start": e13a4628
- "Schema": 90571e9f
+ "Schema": 4fb7c777
"Examples": d1dd6ed8
---
@@ -176,7 +176,7 @@ curl https://api.comfy.org/v2/models/kling/videos-lip-sync/requests/$REQUEST_ID
### 输入
- 回调通知地址。任务状态发生变化时,服务器会发出通知。
+ 回调通知地址。任务状态发生变化时,服务器会发出通知。此项会被忽略:comfy-api 在转发前会丢弃该字段;由 Comfy Router 代你轮询。
格式:`uri`
diff --git a/zh/development/comfy-router/models/runway/gen4-image/code.mdx b/zh/development/comfy-router/models/runway/gen4-image/code.mdx
index 4c11d24ba8..5eedc8a457 100644
--- a/zh/development/comfy-router/models/runway/gen4-image/code.mdx
+++ b/zh/development/comfy-router/models/runway/gen4-image/code.mdx
@@ -2,12 +2,12 @@
title: "通过 Comfy Router 使用 Gen 4 Image"
description: "通过 Comfy Router 调用 runway/gen4_image:端点、请求结构以及 Router 返回的响应。"
sidebarTitle: "Gen 4 Image"
-translationSourceHash: c5792f5c
+translationSourceHash: 51dc9815
translationFrom: development/comfy-router/models/runway/gen4-image/code.mdx
translationBlockHashes:
"_intro": f3b89ce9
"Quick start": 82a202eb
- "Schema": d889abf3
+ "Schema": 1160ec6d
"Examples": 291dbf54
---
@@ -168,7 +168,7 @@ curl https://api.comfy.org/v2/models/runway/gen4_image/requests/$REQUEST_ID \
- 包含编码图像的 HTTPS URL 或 data URI
+ 包含编码图像的 HTTPS URL、Runway 上传 URI(runway://)或 data URI
由 Router 在 `GET /v2/models/runway/gen4_image/openapi.json` 提供的 schema 生成,这也是请求到达提供商之前它用于校验调用的同一份文档。
diff --git a/zh/development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx b/zh/development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx
index e5f33d3207..309178558b 100644
--- a/zh/development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx
+++ b/zh/development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx
@@ -2,12 +2,12 @@
title: "将 Grok Imagine Image 2.0 与 Comfy Router 配合使用"
description: "通过 Comfy Router 调用 xai/grok-imagine-image-2.0:端点、请求结构以及 Router 返回的响应。"
sidebarTitle: "Grok Imagine Image 2.0"
-translationSourceHash: 83fe91a1
+translationSourceHash: e062dc40
translationFrom: development/comfy-router/models/xai/grok-imagine-image-2-0/code.mdx
translationBlockHashes:
"_intro": 614e2e15
"Quick start": ff9945c8
- "Schema": faf9e081
+ "Schema": cb29dfae
"Examples": 3222291b
---
@@ -172,9 +172,9 @@ curl https://api.comfy.org/v2/models/xai/grok-imagine-image-2.0/requests/$REQUES
- 输出图像的质量。对于 grok-imagine-image-2.0,此项用于选择价格档位(low/medium;medium 为默认值);其他模型目前会忽略此项。
+ 输出图像的质量。对于 grok-imagine-image-2.0,此项用于选择价格档位:low、medium 或 auto(省略时为 xAI 的默认值;auto 在生成时使用 low,编辑时使用 medium)。其他模型会忽略此项。
- 可选值:`low`、`medium`、`high`
+ 可能的值:`low`、`medium`、`high`、`auto`
diff --git a/zh/development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx b/zh/development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx
index f2ce00dd3e..57bfe834b7 100644
--- a/zh/development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx
+++ b/zh/development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx
@@ -2,12 +2,12 @@
title: "配合 Comfy Router 使用 Grok Imagine Image Pro"
description: "通过 Comfy Router 调用 xai/grok-imagine-image-pro:端点、请求形状以及 Router 返回的响应。"
sidebarTitle: "Grok Imagine Image Pro"
-translationSourceHash: 7932bb72
+translationSourceHash: 773b1560
translationFrom: development/comfy-router/models/xai/grok-imagine-image-pro/code.mdx
translationBlockHashes:
"_intro": 97d341e4
"Quick start": 3a4bd585
- "Schema": 5d56d158
+ "Schema": 805c771c
"Examples": 3222291b
---
@@ -172,9 +172,9 @@ curl https://api.comfy.org/v2/models/xai/grok-imagine-image-pro/requests/$REQUES
- 输出图像的质量。对于 grok-imagine-image-2.0,此项用于选择价格档位(low/medium;默认为 medium);其他模型目前会忽略该项。
+ 输出图像的质量。对于 grok-imagine-image-2.0,此项用于选择价格档位:low、medium 或 auto(省略时为 xAI 的默认值;auto 在生成时使用 low,编辑时使用 medium)。其他模型会忽略此项。
- 可选值:`low`、`medium`、`high`
+ 可能的值:`low`、`medium`、`high`、`auto`
diff --git a/zh/development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx b/zh/development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx
index 11a69c5911..67e5aebd4e 100644
--- a/zh/development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx
+++ b/zh/development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx
@@ -2,12 +2,12 @@
title: "配合 Comfy Router 使用 Grok Imagine Image Quality"
description: "通过 Comfy Router 调用 xai/grok-imagine-image-quality:端点、请求结构与 Router 返回的响应。"
sidebarTitle: "Grok Imagine Image Quality"
-translationSourceHash: 923968d2
+translationSourceHash: 9f6e16d5
translationFrom: development/comfy-router/models/xai/grok-imagine-image-quality/code.mdx
translationBlockHashes:
"_intro": 72081c22
"Quick start": 799275b8
- "Schema": e0fcef44
+ "Schema": e2c96ff6
"Examples": 3222291b
---
@@ -172,9 +172,9 @@ curl https://api.comfy.org/v2/models/xai/grok-imagine-image-quality/requests/$RE
- 输出图像的质量。对于 grok-imagine-image-2.0,此参数用于选择价格档位(low/medium;默认 medium);其他模型目前会忽略该项。
+ 输出图像的质量。对于 grok-imagine-image-2.0,此项用于选择价格档位:low、medium 或 auto(省略时为 xAI 的默认值;auto 在生成时使用 low,编辑时使用 medium)。其他模型会忽略此项。
- 可选值:`low`、`medium`、`high`
+ 可能的值:`low`、`medium`、`high`、`auto`
diff --git a/zh/development/comfy-router/models/xai/grok-imagine-image/code.mdx b/zh/development/comfy-router/models/xai/grok-imagine-image/code.mdx
index 50889fad9d..70f243a657 100644
--- a/zh/development/comfy-router/models/xai/grok-imagine-image/code.mdx
+++ b/zh/development/comfy-router/models/xai/grok-imagine-image/code.mdx
@@ -2,12 +2,12 @@
title: "使用 Grok Imagine Image 与 Comfy Router"
description: "通过 Comfy Router 调用 xai/grok-imagine-image:端点、请求结构以及 Router 返回的响应。"
sidebarTitle: "Grok Imagine Image"
-translationSourceHash: 9cfb938a
+translationSourceHash: 2e5c55ad
translationFrom: development/comfy-router/models/xai/grok-imagine-image/code.mdx
translationBlockHashes:
"_intro": a2e97c88
"Quick start": a5495331
- "Schema": 1d17b83a
+ "Schema": 171da7d5
"Examples": 3222291b
---
@@ -172,9 +172,9 @@ curl https://api.comfy.org/v2/models/xai/grok-imagine-image/requests/$REQUEST_ID
- 输出图像的质量。对于 grok-imagine-image-2.0,此参数用于选择价格档位(low/medium;默认为 medium);其他模型目前会忽略该参数。
+ 输出图像的质量。对于 grok-imagine-image-2.0,此项用于选择价格档位:low、medium 或 auto(省略时为 xAI 的默认值;auto 在生成时使用 low,编辑时使用 medium)。其他模型会忽略此项。
- 可能的值:`low`, `medium`, `high`
+ 可能的值:`low`, `medium`, `high`, `auto`
diff --git a/zh/development/comfy-router/realtime.mdx b/zh/development/comfy-router/realtime.mdx
new file mode 100644
index 0000000000..fee84d1083
--- /dev/null
+++ b/zh/development/comfy-router/realtime.mdx
@@ -0,0 +1,224 @@
+---
+title: "Comfy Router 实时语音会话"
+sidebarTitle: "实时语音"
+description: "通过 Comfy Router 打开 Grok Voice 实时 WebSocket 会话:端点、认证、按秒计费、会话限制,以及可能遇到的错误和关闭代码。"
+translationSourceHash: e4024a38
+translationFrom: development/comfy-router/realtime.mdx
+translationBlockHashes:
+ "_intro": a85f88e5
+ "Endpoint": 2ae36abf
+ "Authentication": 582120fe
+ "Connect": b61ae8c6
+ "Events": a3ac8c47
+ "Pricing": 25d35f6c
+ "Limits": 85e21dff
+ "Errors": 3085ba65
+ "Next": 3e8c1bd8
+---
+
+Comfy Router 中继与 xAI Grok Voice 的实时语音到语音会话,Grok Voice 由 fal 提供。你使用 Comfy API 密钥向 Router 打开一个 WebSocket。Router 会检查你的账户和积分,在上游打开会话,然后双向中继事件。会话按秒从你的 Comfy 积分中扣费。
+
+## 端点
+
+```text
+wss://api.comfy.org/v2/realtime/fal/xai/grok-voice/realtime
+```
+
+该请求是一次 WebSocket 升级(`GET`,并带有 `Connection: Upgrade` 和 `Upgrade: websocket`)。其他任何请求都会以 `426` 拒绝。
+
+## 认证
+
+在升级请求的请求头中发送你的 Comfy API 密钥,可以使用 `X-API-Key: comfyui-...` 或 `Authorization: Bearer comfyui-...`。Router 不会从查询字符串或 WebSocket 子协议中读取密钥。
+
+
+浏览器无法为 WebSocket 设置请求头,并且 Comfy API 密钥绝不能传到浏览器。请从你的服务器打开会话,并自行将音频中继到浏览器。
+
+
+## 连接
+
+升级成功后,即可发送和接收 xAI 为 Grok Voice 所记录的实时事件。下面这个示例会配置会话、发送一轮文本对话,并打印接收到的每个事件类型。
+
+
+
+```python Python
+# pip install websockets msgpack
+import asyncio
+import os
+
+import msgpack
+import websockets
+
+URL = "wss://api.comfy.org/v2/realtime/fal/xai/grok-voice/realtime"
+
+
+async def send(ws, event):
+ await ws.send(msgpack.packb(event))
+
+
+async def main():
+ async with websockets.connect(
+ URL,
+ additional_headers={"X-API-Key": os.environ["COMFY_API_KEY"]},
+ ) as ws:
+ await send(ws, {
+ "type": "session.update",
+ "session": {
+ "voice": "eve",
+ "instructions": "You are a helpful assistant.",
+ "turn_detection": {"type": "server_vad"},
+ },
+ })
+ await send(ws, {
+ "type": "conversation.item.create",
+ "item": {
+ "type": "message",
+ "role": "user",
+ "content": [{"type": "input_text", "text": "Hello!"}],
+ },
+ })
+ await send(ws, {"type": "response.create"})
+
+ async for message in ws:
+ if isinstance(message, str):
+ continue # fal 自己的 x-fal-message 帧
+ event = msgpack.unpackb(message)
+ print(event["type"])
+ if event["type"] == "response.done":
+ break
+
+
+asyncio.run(main())
+```
+
+```javascript Node.js
+// npm install ws @msgpack/msgpack
+import WebSocket from "ws";
+import { encode, decode } from "@msgpack/msgpack";
+
+const ws = new WebSocket(
+ "wss://api.comfy.org/v2/realtime/fal/xai/grok-voice/realtime",
+ { headers: { "X-API-Key": process.env.COMFY_API_KEY } },
+);
+
+ws.on("unexpected-response", (req, res) => {
+ // 升级请求被拒绝。JSON 响应体会说明原因。
+ let body = "";
+ res.on("data", (chunk) => (body += chunk));
+ res.on("end", () => console.error(res.statusCode, body));
+});
+
+const send = (event) => ws.send(encode(event));
+
+ws.on("open", () => {
+ send({
+ type: "session.update",
+ session: {
+ voice: "eve",
+ instructions: "You are a helpful assistant.",
+ turn_detection: { type: "server_vad" },
+ },
+ });
+ send({
+ type: "conversation.item.create",
+ item: {
+ type: "message",
+ role: "user",
+ content: [{ type: "input_text", text: "Hello!" }],
+ },
+ });
+ send({ type: "response.create" });
+});
+
+ws.on("message", (data, isBinary) => {
+ if (!isBinary) return; // fal 自己的 x-fal-message 帧
+ const event = decode(data);
+ console.log(event.type);
+ if (event.type === "response.done") ws.close();
+});
+
+ws.on("close", (code) => console.log("closed", code));
+```
+
+
+
+完成后请立即关闭套接字。计费会持续到会话关闭为止,而不是到最后一个响应结束。
+
+## 事件
+
+Router 不定义自己的事件协议。服务器事件会完全按照 fal 发送它们的方式送达你手上,而 Router 接受的客户端事件也会原样转发。有关事件列表、会话字段、音色和音频格式,请参阅:
+
+- [xAI 语音到语音](https://docs.x.ai/developers/model-capabilities/audio/speech-to-speech)以及 xAI 的 [realtime 事件 schema](https://docs.x.ai/voice-realtime.ws.json)
+- fal 的 [Grok Voice realtime 模型页面](https://fal.ai/models/xai/grok-voice/realtime)及其 [API 页面](https://fal.ai/models/xai/grok-voice/realtime/api)
+
+像示例中那样,把每个客户端事件作为一条 msgpack 二进制消息发送。这是 fal 的 realtime 客户端所使用的分帧方式,模型的事件也会以同样的方式返回,即从 `session.created` 开始的 msgpack 二进制消息。fal 还会发送自己的、类型为 `x-fal-message` 的 JSON 文本消息(计时信息),你可以跳过它们。Router 的检查也接受把客户端事件作为一条 JSON 文本消息发送,但除非你已经用你的客户端测试过 JSON,否则请使用 msgpack。
+
+Router 在转发每个客户端事件之前都会对其进行检查:
+
+- **事件类型:** `session.update`、`input_audio_buffer.append`、`input_audio_buffer.commit`、`input_audio_buffer.clear`、`conversation.item.create`、`conversation.item.delete`、`conversation.item.truncate`、`response.create`、`response.cancel`,以及 fal 的 `x-fal-session.configure`。
+- **模型:** `session.update` 中的 `model` 必须是 `grok-voice-latest`、`grok-voice-3.0` 或 `grok-voice-2.0`。
+- **工具:** 允许使用由你的客户端执行的函数工具。服务器端工具(网络搜索、X 搜索、文件搜索和 MCP)会被拒绝。
+- **媒体:** 图像和视频输入会被拒绝。会话仅支持语音和文本。
+- **大小:** 单条客户端消息最大为 1 MiB。
+
+被拒绝的事件不会被转发,Router 会以关闭码 `1008` 关闭会话。
+
+## 定价
+
+一次会话的费用为**每秒 $0.0011869**(约每分钟 $0.0712,或每秒 0.2504 积分、约每分钟 15.0 积分,按 211 积分 = 1 美元计算)。会话开启期间以 15 秒为一个增量计费,最后不足一个增量的部分按秒计费并向上取整。计费从升级开始,一直到 socket 关闭为止,无论期间是否有音频传输。
+
+## 限制
+
+| 限制 | 值 |
+| --- | --- |
+| 每个账户的会话数 | 同一时间只能有一个打开的会话。打开第二个会话会返回 `429`,并带有 `router.realtime.session_already_live`。 |
+| 会话时长 | 最多 30 分钟,且绝不会超过连接时你的积分余额所能覆盖的时长。 |
+| 会话期间的积分 | Router 每 15 秒重新检查你的余额,当余额无法再覆盖下一秒时结束会话。 |
+| 连接速率 | 每次升级尝试都会计入你的[每个调用方的请求速率](/zh/development/comfy-router/limitations#请求按调用方进行速率限制),并与其他 Router 调用共享。 |
+
+当会话达到时间限制或积分已用完时,连接可能会在没有关闭帧的情况下关闭(通常表现为关闭代码 `1006`)。请仅在充值之后重新连接;如果需要更多时间,请启动新会话。
+
+## 错误
+
+### 升级之前
+
+如果 Router 拒绝连接,它不会切换协议,而是返回 HTTP 状态码和 JSON 响应体:
+
+```json
+{
+ "detail": "Insufficient credits to open a realtime session.",
+ "error_type": "insufficient_credits",
+ "code": "router.realtime.insufficient_credits"
+}
+```
+
+根据 `code` 进行判断;`detail` 供人阅读。
+
+| 状态码 | `code` | 原因 | 处理方式 |
+| --- | --- | --- | --- |
+| `426` | `router.realtime.upgrade_required` | 请求不是 WebSocket 升级请求。 | 使用 WebSocket 客户端连接。 |
+| `401` | `router.realtime.unauthorized` | API 密钥缺失或无效。 | 在 `X-API-Key` 或 `Authorization: Bearer` 中发送有效密钥。 |
+| `402` | `router.realtime.insufficient_credits` | 你的余额不足以支付至少一秒的会话费用。 | 添加积分,然后重新连接。 |
+| `402` | `router.realtime.spend_denied` | 该会话将要从其扣费的钱包没有足够资金。响应体中的 `denied_reason` 和 `billed_workspace` 会指明是哪个钱包。 | 向该工作区添加积分,然后重新连接。 |
+| `403` | `router.realtime.provider_disabled` | 你的工作区的合作伙伴提供商策略不允许使用此提供商。 | 请工作区管理员允许使用。 |
+| `404` | `router.realtime.model_not_allowed` | URL 中的模型不可用于实时会话。 | 检查 URL。 |
+| `429` | `router.realtime.rate_limited` | 你超出了请求速率限制。 | 等待 `Retry-After`,然后重试。 |
+| `429` | `router.realtime.session_already_live` | 你的账户下已有另一个会话处于打开状态。 | 先关闭它。 |
+| `429` | `router.realtime.concurrency_limit` | 并发合作伙伴模型调用过多。 | 减少并发任务后重试。 |
+| `502` | `router.realtime.upstream_refused`、`router.realtime.token_mint_failed` | 上游提供商未能打开会话。 | 使用退避策略重试。 |
+| `503` | 其他任何 `router.realtime.*` 代码 | 实时会话暂时不可用。 | 使用退避策略重试。 |
+
+### 升级之后
+
+| 关闭代码 | 含义 | 处理方式 |
+| --- | --- | --- |
+| `1008` | 客户端事件被拒绝(参见[事件](#事件))。 | 修正该事件。会话已结束。 |
+| `1012` | Router 正在重启。 | 重新连接。会启动新会话,并从新的升级开始计费。 |
+| `1006`(没有关闭帧) | 当会话达到时间限制或积分用完时,客户端通常会上报此代码。网络中断看起来也一样。 | 添加积分或启动新会话。 |
+
+任何其他关闭代码都来自 fal 或 xAI。请参阅 [事件](#事件) 下链接的文档。
+
+## 下一步
+
+- [计费](/zh/development/comfy-router/billing):Router 如何收费以及如何核对用量。
+- [错误与重试](/zh/development/comfy-router/errors):其他 Router 调用返回的错误分类。
+- [限制](/zh/development/comfy-router/limitations):请求速率及其他限制。
diff --git a/zh/development/comfy-router/reference.mdx b/zh/development/comfy-router/reference.mdx
index 51f1a1ee9a..8f0df79ddf 100644
--- a/zh/development/comfy-router/reference.mdx
+++ b/zh/development/comfy-router/reference.mdx
@@ -2,17 +2,17 @@
title: "Comfy Router API 参考"
description: "每个 Comfy Router 端点、参数、响应体和错误分类,均由 Comfy API 契约生成。"
sidebarTitle: "API 参考"
-translationSourceHash: a6f99965
+translationSourceHash: aee933a1
translationFrom: development/comfy-router/reference.mdx
translationBlockHashes:
"_intro": 3f6e5d23
- "Endpoints": 222fd740
+ "Endpoints": e0879d3c
"Error buckets": 02a09cb4
"Response headers": 403c8bf5
- "Pre-flight cost estimates": 5952af3f
- "Result assets": 18fe6dad
+ "Pre-flight cost estimates": f0ba96a1
+ "Result assets": 5936427c
"Per-model input and output schemas": 61c6bde8
- "Schemas": 984bd216
+ "Schemas": c1245cc9
---
@@ -51,7 +51,7 @@ Comfy API 密钥也可以作为 Bearer token 发送。当同时提供两个凭
**列出 Comfy Router 可以运行的模型。**
-列出可用的模型 ID 和计费信息。当 `has_more` 为 `true` 时,使用 `next_cursor`。
+列出可用的模型 ID 和计费信息。当 `has_more` 为 true 时,使用 `next_cursor`。
**参数**
@@ -307,7 +307,7 @@ Comfy API 密钥也可以作为 Bearer token 发送。当同时提供两个凭
**在运行模型调用之前先为它定价,而无需实际运行。**
-返回一个以美元计的预检估算,表示用此模型运行该请求体将产生的费用,其定价依据与实际运行计费所依据的同一份费率卡(若某模型按其供应商上报的成本计费,则改为依据供应商公布的价格表来估算)。这是估算值,而非最终费用:你实际支付的是工作区用量与账单记录中结算后的费用。请求体会先按模型的输入 schema 进行校验,校验方式与默认运行(未设置 `strict_mode`,也未设置 `reject_unknown_fields`)相同,因此未通过模型 schema 的请求体在此处和在运行时都会得到相同的 `422`;不会向任何提供商派发请求,也不会产生任何扣费。该结果并非价格锁定:它按 `pricing_as_of` 时点生效的费率计价,而一次运行则按计费时生效的费率收费。在该功能逐步推出的期间,此路由会返回 `403`,并带有 `error_type: not_enabled`。
+返回一个以美元计的预检估算,表示用此模型运行该请求体将产生的费用,其定价依据与实际运行计费所依据的同一份费率卡(若某模型按其供应商上报的成本计费,则改为依据供应商公布的价格表来估算)。这是估算值,而非最终费用:你实际支付的是工作区用量与账单记录中结算后的费用。请求体会先按模型的输入 schema 进行校验,校验方式与默认运行(未设置 `strict_mode`,也未设置 `reject_unknown_fields`)相同,因此未通过模型 schema 的请求体在此处和在运行时都会得到相同的 `422`;不会向任何提供商派发请求,也不会产生任何扣费。该结果并非价格锁定:它按 `pricing_as_of` 时点生效的费率计价,而一次运行则按计费时生效的费率收费。在该功能逐步推出的期间,此路由会返回 `403`,并带有 `error_type: not_enabled`;Router 尚无法运行的模型会返回同样的 `403`,但带有运行路由自身的 `detail`,因此请读取 `detail` 以区分两者。
**参数**
@@ -998,10 +998,11 @@ Router 尚无法在运行前定价的模型列在[没有预检估算的模型](/
估算的局限。一个 `200` 的数字并不代表该次运行一定会被接受,也不代表一定按该金额收费:
- `/estimate` 不接受 `strict_mode` 或 `reject_unknown_fields`,因此只校验模型的原生约定:一个在 `strict_mode=true` 运行中按备用提供商自身 schema 可以接受的请求体,在这里可能得到 `422`;而某个未声明的顶层字段,在 `reject_unknown_fields=true` 的运行中会被拒绝,在这里却会被定价。Anthropic Messages 模型是例外:其 schema 允许未声明字段,因此 `reject_unknown_fields=true` 的运行不会拒绝任何字段,而估算只会为未声明的顶层字段 `tools`、`tool_choice`、`temperature`、`top_p`、`top_k`、`stop_sequences`、`metadata`、`thinking` 以及空的 `mcp_servers` 定价。任何其他未声明的顶层字段都会使其返回 `unknown`,并带有 `reason: not_quotable`。
-- `pricing_as_of` 是费率卡的获取时间;对于取自供应商公布价格表的 `estimated` 报价,它是读取该价格表的日期(两者都未读取时,则为估算作答的时间)。它不是价格锁定:运行按其被计费评级时生效的费率收费。
+- `pricing_as_of` 是费率卡的获取时间。取自供应商公布价格表的 `estimated` 报价携带的是读取该价格表的日期。计费数量由供应商公布的调度表预测、再按费率卡定价的 `exact` 或 `estimated` 报价,在该调度表的读取日期早于费率卡时携带该调度表的读取日期。费率卡与调度表都未读取时,它则是估算作答的时间。它不是价格锁定:运行按其被计费评级时生效的费率收费。
- `/estimate` 为 `model_provider` 指定的分支报价,或为原生提供商报价。它不接受 `fallback_provider` 或 `strict_mode` 参数。同步运行的回退重试落到另一个提供商时,按该提供商的费率计费,而该费率并非估算所报的费率;运行响应上的 `X-Comfy-Router-Fallback-Provider` 表明发生了这种情况。排队提交没有回退,因此其 `estimate` 报的就是实际运行的分支。
- 对于 `model_provider` 分支上的同一请求体,或对于在同级操作(sibling operation)上运行的请求体,`/estimate` 与排队提交的 `estimate` 可能为略有差异的文档定价。提交的 `estimate` 是按运行实际发送的文档定价的。
-- `/estimate` 始终报出平台费用。使用自有提供商密钥的运行不由 Comfy 计费,但 `/estimate` 不会检测这一点,仍会返回一个数值;只有排队提交才会返回 `reason: byok`。- 美元金额由未舍入的美分渲染,最多保留 8 位小数,可计费的不足 1 美分的 `amount` 绝不会显示为 `0`。`credits` 为 `round(amount × 211, 2)`,这与 `X-Comfy-Credits-Used` 对一次收费所采用的换算相同,因此对于极小的非零价格,`credits` 可能舍入为 `0`;在这一点很重要时,请按 `amount` 或 `amount_cents` 编制预算,而不是按 `credits`。该响应头仍是某次运行结束后的事后数值;余额保存在 Comfy 平台上。
+- `/estimate` 始终报出平台费用。使用自有提供商密钥的运行不由 Comfy 计费,但 `/estimate` 不会检测这一点,仍会返回一个数值;只有排队提交才会返回 `reason: byok`。
+- 美元金额由未舍入的美分渲染,最多保留 8 位小数,可计费的不足 1 美分的 `amount` 绝不会显示为 `0`。`credits` 为 `round(amount × 211, 2)`,这与 `X-Comfy-Credits-Used` 对一次收费所采用的换算相同,因此对于极小的非零价格,`credits` 可能舍入为 `0`;在这一点很重要时,请按 `amount` 或 `amount_cents` 编制预算,而不是按 `credits`。该响应头仍是某次运行结束后的事后数值;余额保存在 Comfy 平台上。
## 结果资产
@@ -1014,7 +1015,7 @@ Router 尚无法在运行前定价的模型列在[没有预检估算的模型](/
| `minimax/*` | 已完成视频 | 12 小时 |
| `xai/*` | 每一张已生成的图像,以及已完成视频 | 24 小时 |
-这些有效期从 URL 签名时开始计算,而不是从你打开它时开始。缓存或重放的 URL 可能剩余时间更少;重放不会为其续期。请及时下载资产。只有每一行中列出的资产会被复制:`byteplus/seedream-*` 和 `byteplus/seededit-*` 图像不在 BytePlus 视频行的覆盖范围内。
+这些有效期从 URL 签名时开始计算,而不是从你打开它时开始。缓存或重放的 URL 可能剩余时间更少;重放不会为其续期。一条 `Idempotency-Key` 记录的有效期可能长于它所保存的 URL,因此在这样的 URL 到期前一小时起,使用同一键重试会得到 `409 invalid_input`,而不是记录中的响应;若某条响应在送达时就已如此接近到期,则它在 5 分钟内仍可重放。请及时下载资产。只有每一行中列出的资产会被复制:`byteplus/seedream-*` 和 `byteplus/seededit-*` 图像不在 BytePlus 视频行的覆盖范围内。
复制只由模型的原生提供商执行。由替代提供商提供服务的运行(`model_provider` 指定了某个替代提供商,或原生运行的回退重试落到了替代提供商上,并通过 `X-Comfy-Router-Fallback-Provider` 披露)会返回该提供商自己的 URL,这些 URL 遵循提供商的过期时间,不会被复制。`model_provider` 取值 `default`、`comfy` 和 `comfyui` 时不指定替代提供商,因此这些运行属于原生运行并按上述方式复制;`model_provider` 运行的回退重试落回原生提供商时也同样如此。
@@ -1121,7 +1122,7 @@ Router 尚无法在运行前定价的模型列在[没有预检估算的模型](/
- 本报价所依据的费率卡的获取时间。估算值不是价格锁定:运行按计费时生效的费率收费,而不是按这一时刻的费率。从供应商公布的价格表取得的 `estimated` 报价(按供应商报告的费用计费的模型)改为携带读取该价格表的日期;而计费数量由该价格表预测、再按费率卡定价的报价(按供应商报告的积分计费的模型)携带两者中较早的日期。只要没有读取任何费率卡(`reason: pricing_unavailable`、`byok`,或无法从任何卡定价的 `not_quotable` 调用),它就是回答该报价的时间。
+ 本报价所依据的费率卡的获取时间。估算值不是价格锁定:运行按计费时生效的费率收费,而不是按这一时刻的费率。从供应商公布的价格表取得的 `estimated` 报价(按供应商报告的费用计费的模型)改为携带读取该价格表的日期;而计费数量由供应商公布的调度表预测、再按费率卡定价的报价,无论给出的是 `exact` 还是 `estimated` 答案,都携带该调度表的读取日期与费率卡获取时间中较早的一个(按供应商报告的积分计费的模型属于 `estimated` 情形)。只要没有读取任何费率卡(`reason: pricing_unavailable`、`byok`,或无法从任何卡定价的 `not_quotable` 调用),它就是回答该报价的时间。
date-time
+
ComfyUI/models/text_encoders/
ComfyUI/models/text_encoders/
ComfyUI/models/diffusion_models/
+ComfyUI/models/diffusion_models/
+
ComfyUI/models/diffusion_models/
+ Modelo de difusión Kandinsky 5.0 I2V Lite (5s). Colócalo en ComfyUI/models/diffusion_models/
+
ComfyUI/models/loras/
ComfyUI/models/text_encoders/
+
ComfyUI/models/loras/
ComfyUI/models/text_encoders/
+
ComfyUI/models/checkpoints/
ComfyUI/models/text_encoders/
+
ComfyUI/models/checkpoints/
+ Coloca en ComfyUI/models/checkpoints/
ComfyUI/models/loras/
+ ComfyUI/models/loras/
ComfyUI/models/loras/
+ Coloca en ComfyUI/models/loras/
ComfyUI/models/text_encoders/
+ ComfyUI/models/text_encoders/
ComfyUI/models/latent_upscale_models/
+ Coloca en ComfyUI/models/latent_upscale_models/
ComfyUI/models/loras/
ComfyUI/models/text_encoders/
ComfyUI/models/geometry_estimation/
Materiales de entrada
-Descarga este video de entrada de ejemplo para probar el flujo de trabajo: +Descarga este video de entrada de muestra para probar el flujo de trabajo:
@@ -420,11 +420,11 @@ Elimina un objeto concreto del primer plano de un video describiéndolo en el pr
Materiales de entrada
-Descarga este video de entrada de ejemplo para probar el flujo de trabajo: +Descarga este video de entrada de muestra para probar el flujo de trabajo:Materiales de entrada
-Descarga este video de entrada de ejemplo para probar el flujo de trabajo: +Descarga este video de entrada de muestra para probar el flujo de trabajo:
@@ -474,18 +474,18 @@ Amplía un video en cualquier dirección con el IC-LoRA Video Outpainting de LTX
Materiales de entrada
-Descarga este video de entrada de ejemplo para probar el flujo de trabajo: +Descarga este video de entrada de muestra para probar el flujo de trabajo:
@@ -494,7 +494,7 @@ Aplica el LoRA Googlyeyes de LTX-2.3 a un video de entrada para poner ojos salto
Abrir en Comfy Cloud
+
ComfyUI/models/loras/
ComfyUI/models/text_encoders/
ComfyUI/models/diffusion_models/
ComfyUI/models/text_encoders/
ComfyUI/models/vae/
ComfyUI/models/loras/
+ Habilita el modo turbo opcional del Lightning LoRA. Coloca en ComfyUI/models/loras/
ComfyUI/models/checkpoints/
@@ -84,10 +86,10 @@ ComfyUI/
│ └── sdpose_wholebody_fp16.safetensors
```
-## Consejos para los prompts
+## Consejos para escribir prompts
-1. **Duración del video**: El video objetivo dura de 5 a 15 segundos en la cuadrícula de fotogramas 17n+5 a 24fps (124 fotogramas = 5 segundos). Un video de control más largo que el objetivo se recorta a sus primeros fotogramas; uno más corto mantiene su último fotograma. Para igualar exactamente la duración del video de control, conecta la salida `batch_size` calculada del ejemplo con la entrada de longitud del nodo `MiniMax H3 Reference to Video`
-2. **Orientación y strength**: Mantén `guidance_scale` en 1.0. Aumenta el `strength` del patch por encima de 1 solo si el resultado se aleja del control
-3. **Relleno inteligente de video**: Conecta una máscara a la entrada `mask`: las regiones marcadas con `1` se regeneran bajo el control de la entrada opcional `source_video`, mientras el resto del fotograma permanece fijo
+1. **Duración del video**: El video objetivo dura entre 5 y 15 segundos en la cuadrícula de fotogramas 17n+5 a 24fps (124 fotogramas = 5 segundos). Si el video de control es más largo que el objetivo, se recorta a sus primeros fotogramas; si es más corto, mantiene su último fotograma. Para igualar exactamente la duración del video de control, conecta la salida `batch_size` calculada del ejemplo a la entrada de duración del nodo `MiniMax H3 Referencia a Video`
+2. **Orientación y fuerza**: Mantén `guidance_scale` en 1.0. Aumenta la `strength` del patch por encima de 1 solo si la salida se aleja del control
+3. **Relleno inteligente de video**: Conecta una máscara a la entrada `mask`: las regiones marcadas con `1` se regeneran bajo el control de la entrada opcional `source_video`, mientras que el resto del fotograma permanece fijo
4. **Modo turbo (opcional)**: Activa la casilla **Lightning LoRA** para usar el LoRA turbo de 4 pasos y generar mucho más rápido, con una calidad de audio y movimiento ligeramente inferior
-5. **Preparar los videos de control**: ComfyUI incluye nodos de preprocesamiento integrados para cada tipo de control. Consulta el [nodo Detect Edges (Canny)](https://docs.comfy.org/built-in-nodes/Canny) para bordes y el [tutorial Depth Anything 3](https://docs.comfy.org/tutorials/utility/depth-anything-3) para mapas de profundidad
+5. **Preparar videos de control**: ComfyUI incluye nodos de preprocesamiento integrados para cada tipo de control. Consulta el [nodo Detect Edges (Canny)](https://docs.comfy.org/built-in-nodes/Canny) para bordes y el [tutorial de Depth Anything 3](https://docs.comfy.org/tutorials/utility/depth-anything-3) para mapas de profundidad
diff --git a/es/tutorials/video/minimax/minimax-h3-multiframe.mdx b/es/tutorials/video/minimax/minimax-h3-multiframe.mdx
index 79e7241a9d..d9b87a3444 100644
--- a/es/tutorials/video/minimax/minimax-h3-multiframe.mdx
+++ b/es/tutorials/video/minimax/minimax-h3-multiframe.mdx
@@ -2,14 +2,16 @@
title: "Flujo de trabajo de referencia multifotograma de MiniMax H3 en ComfyUI"
description: "Crea continuaciones de video y escenas de varias tomas con MiniMax H3 en ComfyUI fijando fotogramas de referencia en la línea de tiempo con nodos Add Guide."
sidebarTitle: "Referencia multifotograma"
-translationSourceHash: 456918f4
+translationSourceHash: 92c8dde7
translationFrom: tutorials/video/minimax/minimax-h3-multiframe.mdx
translationBlockHashes:
"_intro": 3a03ecf1
"Model downloads": 263666fa
+ "Model storage": 17ed75e6
"Prompting tips": 12a34e31
"Prompt writing guide": 4f808c3a
---
+
Genera continuaciones de video y escenas de varios planos anclando fotogramas de referencia en puntos específicos a lo largo de la línea de tiempo de salida. El flujo de trabajo combina el nodo Reference to Video con nodos Add Guide encadenados: cada Add Guide fija una imagen estática (más audio opcional) a un índice de fotograma, de modo que el video pasa por esa composición exacta en ese momento.
@@ -54,7 +56,7 @@ Genera continuaciones de video y escenas de varios planos anclando fotogramas de
Colócalo en ComfyUI/models/vae/
ComfyUI/models/loras/
+ Habilita el modo turbo opcional del Lightning LoRA. Colócalo en ComfyUI/models/loras/
@@ -184,7 +186,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
Wan2.1-Fun-14B-Control.safetensors después de descargarlo. Archivo de 32 GB o más, requiere más VRAM
+ Modelo de difusión Wan2.1 Fun Control 14B. Renómbralo a Wan2.1-Fun-14B-Control.safetensors después de descargarlo. Tamaño de archivo de 32GB o más, mayores requisitos de VRAM
ComfyUI/models/diffusion_models/
+ Coloca el archivo en ComfyUI/models/diffusion_models/
ComfyUI/models/loras/
+ Coloca el archivo en ComfyUI/models/loras/
ComfyUI/models/text_encoders/
+ ComfyUI/models/text_encoders/
ComfyUI/models/clip_vision/
+ Coloca el archivo en ComfyUI/models/clip_vision/
ComfyUI/models/vae/
+ Coloca el archivo en ComfyUI/models/vae/
+
+
+
ComfyUI/models/diffusion_models/
+ Modelo de difusión de ruido alto. Colócalo en ComfyUI/models/diffusion_models/
ComfyUI/models/diffusion_models/
+ Modelo de difusión de ruido bajo. Colócalo en ComfyUI/models/diffusion_models/
+
ComfyUI/models/diffusion_models/
+ Modelo de difusión I2V de ruido alto. Colócalo en ComfyUI/models/diffusion_models/
ComfyUI/models/diffusion_models/
+ Modelo de difusión I2V de ruido bajo. Colócalo en ComfyUI/models/diffusion_models/
+