Descargar el archivo de flujo de trabajo en formato JSON
+Descargar archivo de flujo de trabajo en formato Json
También puedes descargar manualmente [ace_step_v1_3.5b.safetensors](https://huggingface.co/Comfy-Org/ACE-Step_ComfyUI_repackaged/blob/main/all_in_one/ace_step_v1_3.5b.safetensors) y guardarlo en la carpeta `ComfyUI/models/checkpoints` -### 2. Completa el flujo de trabajo paso a paso +### 2. Completar el flujo de trabajo paso a paso - + 1. Asegúrate de que el nodo `Load Checkpoints` haya cargado el modelo `ace_step_v1_3.5b.safetensors` -2. (Opcional) En el nodo `EmptyAceStepLatentAudio` puedes definir la duración de la música que se va a generar -3. (Opcional) En el nodo `LatentOperationTonemapReinhard` puedes ajustar el `multiplier` para controlar el volumen de la voz (valores más altos hacen que la voz destaque más) -4. (Opcional) Introduce los estilos musicales correspondientes, etc., en el campo `tags` de `TextEncodeAceStepAudio` +2. (Opcional) En el nodo `EmptyAceStepLatentAudio`, puedes establecer la duración de la música que se va a generar +3. (Opcional) En el nodo `LatentOperationTonemapReinhard`, puedes ajustar el `multiplier` para controlar el volumen de las voces (los números más altos dan como resultado voces más prominentes) +4. (Opcional) Introduce los estilos de música correspondientes, etc. en el campo `tags` de `TextEncodeAceStepAudio` 5. (Opcional) Introduce la letra correspondiente en el campo `lyrics` de `TextEncodeAceStepAudio` -6. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter`, para ejecutar la generación de audio -7. Cuando el flujo de trabajo termine,, puedes escuchar el audio generado en el nodo `Save Audio`. Puedes hacer clic para reproducirlo, y el audio también se guardará en `ComfyUI/output/audio` (el subdirectorio lo determina el nodo `Save Audio`). +6. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de audio +7. Cuando el flujo de trabajo termine, puedes previsualizar el audio generado en el nodo `Save Audio`. Puedes hacer clic para reproducirlo y escucharlo, y el audio también se guardará en `ComfyUI/output/audio` (el subdirectorio lo determina el nodo `Save Audio`). ## Flujo de trabajo de audio a audio con ACE-Step en ComfyUI -De forma similar a los flujos de trabajo de imagen a imagen, puedes ingresar un fragmento de música y usar el flujo de trabajo de abajo para remuestrear y generar música. También puedes ajustar la diferencia respecto al audio original controlando el parámetro `denoise` en el `Ksampler`. +De forma similar a los flujos de trabajo de imagen a imagen, puedes introducir una pieza musical y usar el flujo de trabajo de abajo para volver a muestrear y generar música. También puedes ajustar la diferencia respecto al audio original controlando el parámetro `denoise` del `Ksampler`. ### 1. Descargar el archivo del flujo de trabajo Haz clic en el botón de abajo para descargar el archivo del flujo de trabajo correspondiente. Arrástralo a ComfyUI para cargar la información del flujo de trabajo. -Descargar archivo de flujo de trabajo en formato JSON
+Descargar el archivo de flujo de trabajo en formato JSON
Descarga el siguiente archivo de audio como audio de entrada: -Descargar archivo de audio de ejemplo para la entrada
+Descargar el archivo de audio de ejemplo para la entrada
### 2. Completar el flujo de trabajo paso a paso - + 1. Asegúrate de que el nodo `Load Checkpoints` haya cargado el modelo `ace_step_v1_3.5b.safetensors` 2. Sube el archivo de audio proporcionado en el nodo `LoadAudio` -3. (Opcional) Ingresa los estilos musicales y la letra correspondientes en los campos `tags` y `lyrics` de `TextEncodeAceStepAudio`. Proporcionar la letra es muy importante para la edición de audio -4. (Opcional) Modifica el parámetro `denoise` del nodo `Ksampler` para ajustar el ruido que se añade durante el muestreo y así controlar la similitud con el audio original (los valores más pequeños dan como resultado una mayor similitud con el audio original; establecerlo en `1.00` equivale aproximadamente a no tener entrada de audio) +3. (Opcional) Introduce los estilos musicales y la letra correspondientes en los campos `tags` y `lyrics` de `TextEncodeAceStepAudio`. Proporcionar la letra es muy importante para la edición de audio +4. (Opcional) Modifica el parámetro `denoise` del nodo `Ksampler` para ajustar el ruido añadido durante el muestreo y controlar la similitud con el audio original (los valores más pequeños dan como resultado una mayor similitud con el audio original; establecerlo en `1.00` equivale aproximadamente a no tener entrada de audio) 5. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de audio 6. Cuando el flujo de trabajo termine, puedes previsualizar el audio generado en el nodo `Save Audio`. Puedes hacer clic para reproducirlo y escucharlo, y el audio también se guardará en `ComfyUI/output/audio` (el subdirectorio lo determina el nodo `Save Audio`). -También puedes usar la funcionalidad de modificación y edición de la letra de la página del proyecto ACE-Step, modificando la letra original para cambiar el efecto del audio. +También puedes implementar la funcionalidad de modificación y edición de la letra de la página del proyecto ACE-Step, modificando la letra original para cambiar el efecto del audio. ### 3. Notas adicionales sobre el flujo de trabajo -1. En el flujo de trabajo de ejemplo, puedes cambiar los `tags` de `TextEncodeAceStepAudio` de `male voice` a `female voice` para generar voces femeninas. -2. También puedes modificar los `lyrics` de `TextEncodeAceStepAudio` para cambiar la letra y, con ello, el audio generado. Consulta los ejemplos de la página del proyecto ACE-Step para más detalles. +1. En el flujo de trabajo de ejemplo, puedes cambiar `tags` en `TextEncodeAceStepAudio` de `male voice` a `female voice` para generar voces femeninas. +2. También puedes modificar `lyrics` en `TextEncodeAceStepAudio` para cambiar la letra y, con ello, el audio generado. Consulta los ejemplos de la página del proyecto ACE-Step para ver más detalles. ## Guía de prompts de ACE-Step -Actualmente, ACE usa dos tipos de prompts: `tags` y `lyrics`. +ACE actualmente usa dos tipos de prompts: `tags` y `lyrics`. -- `tags`: se usan principalmente para describir estilos musicales, escenas, etc. De forma similar a los prompts que usamos en otras generaciones, describen sobre todo el estilo general y los requisitos del audio, y se separan con comas en inglés. -- `lyrics`: se usan principalmente para describir la letra y admiten etiquetas de estructura como [verse], [chorus] y [bridge] para distinguir las distintas partes de la letra. También puedes escribir nombres de instrumentos para música puramente instrumental. +- `tags`: se usan principalmente para describir estilos musicales, escenas, etc. De forma similar a los prompts que usamos para otras generaciones, describen sobre todo el estilo general y los requisitos del audio, y se separan con comas en inglés. +- `lyrics`: se usan principalmente para describir la letra y admiten etiquetas de estructura como [verse], [chorus] y [bridge] para distinguir las distintas partes de la letra. También puedes introducir nombres de instrumentos para música puramente instrumental. -Puedes encontrar abundantes ejemplos de `tags` y `lyrics` en la [página del modelo ACE-Step](https://ace-step.github.io/). Puedes consultar esos ejemplos para probar los prompts correspondientes. La guía de prompts de este documento está organizada a partir del proyecto para ayudarte a probar combinaciones rápidamente y lograr el efecto que buscas. +Puedes encontrar abundantes ejemplos de `tags` y `lyrics` en la [página principal del modelo ACE-Step](https://ace-step.github.io/). Puedes consultar estos ejemplos para probar los prompts correspondientes. La guía de prompts de este documento está organizada a partir del proyecto para ayudarte a probar combinaciones rápidamente y conseguir el efecto que deseas. ### Etiquetas (prompt) -#### Estilos musicales populares +#### Estilos musicales convencionales -Usa combinaciones cortas de etiquetas para generar estilos musicales concretos +Usa combinaciones cortas de etiquetas para generar estilos musicales específicos - electronic - rock @@ -131,8 +133,8 @@ Combina situaciones de uso y atmósferas concretas para generar música que enca - clean vocals #### Términos profesionales -Usa algunos términos habituales del mundo de la música para controlar con precisión el resultado musical -- 110 bpm (110 pulsaciones por minuto) +Usa algunos términos profesionales habituales en la música para controlar con precisión el resultado musical +- 110 bpm (beats per minute is 110) - fast tempo - slow tempo @@ -145,9 +147,9 @@ Usa algunos términos habituales del mundo de la música para controlar con prec - variance=0.3 (controla el grado de diferencia entre la música generada y el estilo original) */} {/* - Edición de la letra: - - editar la letra: 'When I was young' -> 'When you were kid' (ejemplo de edición de la letra) */} + - edit lyrics: 'When I was young' -> 'When you were kid' (ejemplo de edición de la letra) */} -### Letras +### Letra #### Etiquetas de estructura de la letra @@ -158,9 +160,9 @@ Usa algunos términos habituales del mundo de la música para controlar con prec #### Soporte multilingüe -- ACE-Step V1 admite varios idiomas. Al usarlo, ACE-Step convierte los distintos idiomas a letras del alfabeto inglés y luego genera la música. -- En ComfyUI, todavía no hemos implementado por completo la conversión de todos los idiomas a letras del alfabeto inglés. Por ahora, solo están implementados los [caracteres japoneses hiragana y katakana](https://github.com/Comfy-Org/ComfyUI/commit/5d3cc85e13833aeb6ef9242cdae243083e30c6fc). -Así que, si necesitas usar varios idiomas para generar música, primero debes convertir el idioma correspondiente a letras del alfabeto inglés y luego escribir la abreviatura del código de idioma al comienzo de `lyrics`, como el chino `[zh]`, el coreano `[ko]`, etc. +- ACE-Step V1 admite varios idiomas. Al usarlo, ACE-Step convierte los distintos idiomas a letras del alfabeto inglés y después genera la música. +- En ComfyUI no hemos implementado por completo la conversión de todos los idiomas a letras del alfabeto inglés. Actualmente solo están implementados los [caracteres japoneses hiragana y katakana](https://github.com/Comfy-Org/ComfyUI/commit/5d3cc85e13833aeb6ef9242cdae243083e30c6fc). +Así que si necesitas usar varios idiomas para generar música, primero debes convertir el idioma correspondiente a letras del alfabeto inglés y luego introducir la abreviatura del código de idioma al principio de `lyrics`, por ejemplo chino `[zh]`, coreano `[ko]`, etc. Por ejemplo: @@ -193,7 +195,7 @@ Por ejemplo: [fr]un amour profond qui ne s'éloignera jamais ``` -Actualmente, ACE-Step admite 19 idiomas, pero los siguientes diez tienen mejor soporte: +Actualmente, ACE-Step admite 19 idiomas, pero los diez siguientes tienen mejor soporte: - Inglés - Chino: [zh] - Ruso: [ru] diff --git a/es/tutorials/audio/minimax/minimax-music-3.mdx b/es/tutorials/audio/minimax/minimax-music-3.mdx index e073e34608..40e0a6f30d 100644 --- a/es/tutorials/audio/minimax/minimax-music-3.mdx +++ b/es/tutorials/audio/minimax/minimax-music-3.mdx @@ -2,19 +2,21 @@ title: "MiniMax Music 3 en ComfyUI: generación de música con IA" description: "Aprende a usar MiniMax Music 3 en ComfyUI para generar canciones completas de hasta 5 minutos a partir de un caption musical estructurado y una letra." sidebarTitle: "MiniMax Music 3" -translationSourceHash: dd9d217b +translationSourceHash: 02b650c1 translationFrom: tutorials/audio/minimax/minimax-music-3.mdx translationBlockHashes: "_intro": 883223ea "Key features": 7a913ea4 "Getting started": e1d3e891 + "MiniMax Music 3 Text to Music workflow": 822050b7 "Output": a0e21d03 --- + import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"; -[MiniMax Music 3](https://github.com/MiniMax-AI/MiniMax-Music3) es el modelo de generación musical de MiniMax para crear canciones completas de hasta **cinco minutos** de duración. Condicionado por una letra y una descripción musical detallada, produce canciones estructuralmente coherentes con voces expresivas, arreglos que evolucionan y una calidad de audio estable en formatos largos. Puedes explorar ejemplos generados en la [página de demostración oficial](https://minimax-ai.github.io/music3-demo/).
+[MiniMax Music 3](https://github.com/MiniMax-AI/MiniMax-Music3) es el modelo de generación musical de MiniMax para crear canciones completas de hasta **cinco minutos** de duración. Condicionado por una letra y una descripción musical detallada, produce canciones estructuralmente coherentes con voces expresivas, arreglos que evolucionan y una calidad de audio estable en piezas largas. Puedes explorar ejemplos generados en la [página de demostración oficial](https://minimax-ai.github.io/music3-demo/).
MiniMax Music 3 utiliza una arquitectura autoregresiva jerárquica con un LLM global de 8B para la estructura musical de largo alcance, un LLM local de 0.6B para el detalle acústico a nivel de fotograma y un sistema de síntesis de estados ocultos continuos basado en Flow Matching y un Flow-VAE. Genera audio estéreo de 32 kHz y 16 bits. Los pesos del modelo están disponibles bajo la [Licencia Comunitaria de MiniMax-Music3](https://huggingface.co/MiniMaxAI/MiniMax-Music3/blob/main/LICENSE).
@@ -30,7 +32,7 @@ La [Licencia Comunitaria](https://huggingface.co/MiniMaxAI/MiniMax-Music3/blob/m
- **Canciones completas**: Genera pistas completas de hasta 5 minutos con intro, verso, preestribillo, estribillo, puente, interludio instrumental y outro
- **Control de dos entradas**: Una **Caption** estructurada define el estilo musical, el estado de ánimo, las voces y el arreglo, mientras que **Lyrics**, con etiquetas de sección (`[Intro]`, `[Verse]`, `[Chorus]`, `[Bridge]`, `[Instrumental]`, `[Outro]`), controla la estructura de la canción
- **Coherencia de largo alcance**: Mantiene los temas musicales, el ritmo, la identidad vocal y la progresión del arreglo a lo largo de secuencias largas
-- **Voces expresivas**: Síntesis vocal natural con control sobre la melodía, la pronunciación y las armonías superpuestas
+- **Voces expresivas**: Síntesis vocal natural con control sobre la melodía, la pronunciación y las armonías por capas
- **Pesos abiertos**: Ejecútalo localmente en ComfyUI con control total sobre cada parámetro
## Primeros pasos
@@ -39,13 +41,13 @@ MiniMax Music 3 es compatible con ComfyUI con pesos abiertos. Para empezar:
1. Actualiza ComfyUI a la última versión
2. Ve a **Biblioteca de plantillas** > **Audio** > elige el flujo de trabajo **MiniMax Music 3**
-3. Sigue la ventana emergente para descargar los modelos y ejecutar el flujo de trabajo
+3. Sigue las indicaciones de la ventana emergente para descargar los modelos y ejecutar el flujo de trabajo
Los archivos de modelo listos para ComfyUI (modelo de difusión reempaquetado, text encoder y VAE) están alojados en Hugging Face en el repositorio [Comfy-Org/MiniMax-Music-3](https://huggingface.co/Comfy-Org/MiniMax-Music-3). Los pesos originales del modelo están disponibles en el repositorio [MiniMaxAI/MiniMax-Music3](https://huggingface.co/MiniMaxAI/MiniMax-Music3).
## Flujo de trabajo de texto a música de MiniMax Music 3
-Genera una canción completa a partir de un caption musical estructurado y una letra.
+Genera una canción completa a partir de una descripción musical estructurada y una letra.
 @@ -54,21 +56,21 @@ Genera una canción completa a partir de un caption musical estructurado y una l
Abrir en Comfy Cloud
 +
 +
 @@ -50,16 +52,16 @@ Genera una imagen solo a partir de un prompt, sin archivos de entrada. El flujo
 +
 @@ -110,22 +112,22 @@ Sube este archivo al nodo `LoadImage` correspondiente:
1. Carga tu imagen fuente en el nodo `LoadImage`
2. Conéctala a `Set Reference Multi Latent`. La primera referencia es `
 -
 +
 +
 +
 +
 @@ -157,7 +159,7 @@ Genera imágenes con el modelo Krea-2 Turbo tomando como referencia el estilo de
Abrir en Comfy Cloud
 @@ -61,7 +64,7 @@ Genera una imagen solo a partir de un prompt, sin archivos de entrada. El potenc
 @@ -130,14 +133,14 @@ Con al menos una caja conectada, `MOSS-Image Layout Prompt` genera un prompt JSO
1. Actualiza ComfyUI a 0.42.0 o una versión posterior
2. Ve a **Template**, busca **MOSS-Image** y elige la variante de diseño
3. Descarga los modelos que se indican en [descargas de modelos](#descargas-de-modelos-de-moss-image)
-4. Dibuja una caja por elemento en `Create Bounding Boxes` y luego escribe un texto descriptivo para cada caja. Para una caja de texto, escribe el texto que quieres que se renderice
+4. Dibuja una caja por elemento en `Create Bounding Boxes` y luego escribe una descripción para cada caja. Para una caja de texto, escribe el texto que quieres que se renderice
5. Describe la escena completa en el prompt y haz clic en **Queue**
### MOSS-Image Base: Layout-Guided Text to Image {#image_moss_image_base_t2i_bboxes}
-El flujo de trabajo de layout con el checkpoint Base. Útil cuando quieres comparar cómo los dos checkpoints siguen el mismo layout de cajas.
+El flujo de trabajo de disposición con el checkpoint Base. Es útil cuando quieres comparar cómo los dos checkpoints siguen la misma disposición de cajas.
-
 +
 +
 +
 @@ -83,20 +85,19 @@ Sube este archivo al nodo `LoadImage` **74**:
│ └── 📂 vae/
│ └── qwen_image_layered_vae.safetensors
```
-
## Versión FP8
-De forma predeterminada usamos bf16, que requiere mucha VRAM. Si quieres reducir el uso de VRAM, puedes usar la versión fp8:
+Por defecto usamos bf16, que requiere mucha VRAM. Si necesitas un uso de VRAM menor, puedes usar la versión fp8:
- [qwen_image_layered_fp8mixed.safetensors](https://huggingface.co/Comfy-Org/Qwen-Image-Layered_ComfyUI/blob/main/split_files/diffusion_models/qwen_image_layered_fp8mixed.safetensors)
-Luego, actualiza el nodo **Cargar modelo de difusión** dentro del [Subgraph](/es/interface/features/subgraph) para usarla.
+Después, actualiza el nodo **Load Diffusion model** dentro del [Subgraph](/es/interface/features/subgraph) para usarla.
## Capas y salida
-El número de capas lo define el widget `layers` del nodo **Empty Qwen Image Layered Latent**, dentro del [Subgraph](/es/interface/features/subgraph).
+El número de capas lo define el widget `layers` del nodo **Latente Qwen Image en capas vacío**, dentro del [Subgraph](/es/interface/features/subgraph).
-Este modelo regenera la imagen completa además de las capas, así que una generación siempre se decodifica en `layers + 1` imágenes:
+Este modelo regenera la imagen completa además de las capas, así que una generación siempre decodifica `layers + 1` imágenes:
| `layers` | Imágenes decodificadas | Contenido |
| --- | --- | --- |
@@ -104,28 +105,28 @@ Este modelo regenera la imagen completa además de las capas, así que una gener
| `2` (valor predeterminado de la plantilla) | 3 | La imagen completa y luego 2 capas |
| `5` | 6 | La imagen completa y luego 5 capas |
-**La primera imagen es la imagen completa, no una capa.** El flujo de trabajo de imagen a capas la descarta automáticamente con un nodo `LatentCut` (`dim` `t`, `index` `1`) antes de la división del lote, de modo que la plantilla genera `layers` imágenes. Si construyes un gráfico personalizado sin ese nodo, descarta la primera imagen cuando solo quieras las capas. `layers` acepta `0`, lo que te da esa imagen por sí sola.
+**La primera imagen es la imagen completa, no una capa.** El flujo de trabajo de imagen a capas la descarta automáticamente con un nodo `Cortar latente` (`dim` `t`, `index` `1`) antes de la división del lote, por lo que la plantilla genera `layers` imágenes. Si construyes un gráfico personalizado sin ese nodo, descarta la primera imagen cuando solo quieras las capas. `layers` acepta `0`, lo que te da esa imagen por sí sola.
-**Si compones todas las capas de nuevo, vuelves a crear la imagen completa.** Úsalo como comprobación: si al apilar las capas no se reproduce la primera imagen, la descomposición no hizo lo que buscabas.
+**Recomponer todas las capas vuelve a crear la imagen completa.** Úsalo como comprobación: si al apilar las capas no se reproduce la primera imagen, la descomposición no hizo lo que querías.
-### Cómo se convierten las capas en imágenes separadas
+### Cómo las capas se convierten en imágenes separadas
-El nodo **Empty Qwen Image Layered Latent** asigna un latente 5D con forma `[batch_size, 16, layers + 1, height // 8, width // 8]`. Las capas ocupan el tercer eje, el mismo eje temporal que los modelos de video usan para los fotogramas. El nodo **LatentCutToBatch** con `dim` en `t` mueve ese eje a la dimensión del lote, así que después de **VAE Decode** cada capa es una imagen separada dentro del lote. La plantilla inserta un nodo `LatentCut` (`dim` `t`, `index` `1`) antes de `LatentCutToBatch` para descartar la entrada de la imagen completa, de modo que el lote decodificado solo contiene las capas.
+El nodo **Latente Qwen Image en capas vacío** asigna un latente 5D con forma `[batch_size, 16, layers + 1, height // 8, width // 8]`. Las capas ocupan el tercer eje, el mismo eje temporal que los modelos de video usan para los fotogramas. El nodo **Cortar latente a lote** con `dim` en `t` mueve ese eje a la dimensión del lote, de modo que después de la **Decodificación VAE** cada capa es una imagen separada dentro del lote. La plantilla inserta un nodo `Cortar latente` (`dim` `t`, `index` `1`) antes de **Cortar latente a lote** para descartar la entrada de la imagen completa, así que el lote decodificado contiene solo las capas.
-Por lo tanto, la posición de una capa en la pila es su índice en el lote, contando desde la imagen completa en el índice 0. No hay campo de z-index ni metadatos por capa que lleven ese orden, así que reordenar o filtrar el lote reordena las capas.
+La posición de una capa en la pila es, por lo tanto, su índice en el lote, contando desde la imagen completa en el índice 0. No existe un campo de z-index ni metadatos por capa que lleven ese orden, así que reordenar o filtrar el lote reordena las capas.
-El VAE de Qwen-Image-Layered decodifica a 4 canales, así que las capas decodificadas llevan un canal alfa.
+El VAE de Qwen-Image-Layered decodifica a 4 canales, por lo que las capas decodificadas llevan un canal alfa.
## Configuraciones del flujo de trabajo
### Configuraciones del sampler
-Este modelo es lento. Las configuraciones de muestreo originales son steps: 50 y CFG: 4.0, lo que al menos duplicará el tiempo de generación.
+Este modelo es lento. Las configuraciones de muestreo originales son steps: 50 y CFG: 4.0, lo que como mínimo duplica el tiempo de generación.
### Tamaño de entrada
-Para el tamaño de entrada, se recomienda 640px. Usa 1024px para una salida de alta resolución.
+Para el tamaño de entrada se recomienda 640px. Usa 1024px para una salida de alta resolución.
### Prompt (opcional)
-El prompt de texto está pensado para describir el contenido general de la imagen de entrada, incluidos los elementos que pueden estar parcialmente ocultos (por ejemplo, puedes especificar el texto que está detrás de un objeto en primer plano). No está diseñado para controlar explícitamente el contenido semántico de cada capa.
+El prompt de texto sirve para describir el contenido general de la imagen de entrada, incluidos los elementos que pueden estar parcialmente ocluidos (por ejemplo, puedes especificar el texto oculto detrás de un objeto en primer plano). No está diseñado para controlar de forma explícita el contenido semántico de cada capa.
diff --git a/es/tutorials/image/z-image/z-image-turbo.mdx b/es/tutorials/image/z-image/z-image-turbo.mdx
index 0d0a554811..17adc4743b 100644
--- a/es/tutorials/image/z-image/z-image-turbo.mdx
+++ b/es/tutorials/image/z-image/z-image-turbo.mdx
@@ -2,21 +2,24 @@
title: "Z-Image-Turbo en ComfyUI: texto a imagen en 8 pasos"
description: "Un modelo destilado de texto a imagen de 6B que renderiza en 8 pasos con 16GB de VRAM, con renderizado preciso de texto en chino e inglés en ComfyUI."
sidebarTitle: "Z-Image-Turbo"
-translationSourceHash: 3ba96151
+translationSourceHash: 33113227
translationFrom: tutorials/image/z-image/z-image-turbo.mdx
translationBlockHashes:
"_intro": 7084d4ab
+ "Z-Image-Turbo text-to-image workflow": b88a686f
+ "Z-Image-Turbo Fun Union ControlNet workflow": abab6a04
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
**Z-Image (造相)** es un modelo de generación de imágenes potente y muy eficiente con **6B** parámetros, desarrollado por Tongyi Lab de Alibaba. Utiliza una arquitectura **Scalable Single-Stream DiT** (S3-DiT) en la que los tokens de texto, los tokens semánticos visuales y los tokens del VAE de imagen se concatenan a nivel de secuencia para formar un único flujo de entrada, maximizando la eficiencia de los parámetros.
**Variantes del modelo**:
-- 🚀 **Z-Image-Turbo**: una versión destilada que iguala o supera a los principales competidores con solo **8 NFE** (Number of Function Evaluations). Ofrece una **latencia de inferencia inferior a un segundo** en GPUs H800 de clase empresarial y cabe en **dispositivos de consumo con 16 GB de VRAM**.
+- 🚀 **Z-Image-Turbo**: una versión destilada que iguala o supera a los principales competidores con solo **8 NFE** (Number of Function Evaluations). Ofrece una **latencia de inferencia inferior a un segundo** en GPUs H800 de clase empresarial y cabe en **dispositivos de consumo con 16GB de VRAM**.
- 🧱 **Z-Image-Base**: el modelo base sin destilar, pensado para el ajuste fino impulsado por la comunidad y el desarrollo personalizado.
-- ✍️ **Z-Image-Edit**: una variante ajustada para tareas de edición de imágenes, con una capacidad notable para seguir instrucciones.
+- ✍️ **Z-Image-Edit**: una variante ajustada para tareas de edición de imágenes, con una notable capacidad para seguir instrucciones.
**Aspectos destacados del modelo**:
- **Calidad fotorrealista**: ofrece una sólida generación de imágenes fotorrealistas sin perder una excelente calidad estética
@@ -30,28 +33,28 @@ import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
 +
 +
 @@ -55,14 +57,14 @@ La base para la libertad creativa. Estética diversa con una calidad fotorrealis
Codificador de texto para Z-Image.
 +
+
 +
+
 +
 -## Completar la ejecución del flujo de trabajo paso a paso
+## Completa la ejecución del flujo de trabajo paso a paso

@@ -73,11 +75,11 @@ En la plantilla correspondiente, hemos creado un prompt para analizar y generar
Puedes guiarte por los números de la imagen para completar la ejecución básica del flujo de trabajo de texto a imagen:
1. En el nodo `Load Image`, carga la imagen que necesitas que la IA interprete
-2. (Opcional) Si es necesario, puedes modificar el prompt en `Google Gemini` para que la IA ejecute tareas específicas
-3. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la conversación.
+2. (Opcional) Si lo necesitas, puedes modificar el prompt en `Google Gemini` para que la IA ejecute tareas específicas
+3. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la conversación.
4. Después de esperar a que la API devuelva los resultados, puedes ver el contenido correspondiente devuelto por la IA en el nodo `Preview Any`.
## Notas adicionales
-- Actualmente, el nodo de entrada de archivos `Gemini Input Files` requiere que primero cargues los archivos en el directorio `ComfyUI/input/`. Este nodo está en proceso de mejora y modificaremos la plantilla después de las actualizaciones
-- El flujo de trabajo incluye un ejemplo que usa `Batch Images` como entrada. Si tienes varias imágenes que necesitan interpretación de la IA, puedes consultar el diagrama de pasos y usar el clic derecho para establecer el modo del nodo correspondiente en `Always` y habilitarlo
+- Actualmente, el nodo de entrada de archivos `Gemini Input Files` requiere que primero cargues los archivos en el directorio `ComfyUI/input/`. Este nodo se está mejorando y modificaremos la plantilla después de las actualizaciones.
+- El flujo de trabajo incluye un ejemplo que usa `Batch Images` como entrada. Si tienes varias imágenes que necesitan la interpretación de la IA, puedes consultar el diagrama de pasos y usar el clic derecho para establecer el modo del nodo correspondiente en `Always` y habilitarlo.
diff --git a/es/tutorials/partner-nodes/ideogram/ideogram-v3.mdx b/es/tutorials/partner-nodes/ideogram/ideogram-v3.mdx
new file mode 100644
index 0000000000..c4f94d033b
--- /dev/null
+++ b/es/tutorials/partner-nodes/ideogram/ideogram-v3.mdx
@@ -0,0 +1,53 @@
+---
+title: "Ideogram 3.0 en ComfyUI: texto a imagen y edición de imágenes"
+description: "Ejecuta Ideogram 3.0 con los Nodos asociados de ComfyUI: genera imágenes fotorrealistas con texto preciso o edita un área enmascarada desde un prompt."
+sidebarTitle: "Ideogram 3.0"
+translationSourceHash: 452067eb
+translationFrom: tutorials/partner-nodes/ideogram/ideogram-v3.mdx
+---
+
+import ReqHint from "/snippets/es/tutorials/partner-nodes/req-hint.mdx";
+import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
+
+Ideogram 3.0 es un potente modelo de texto a imagen de Ideogram, conocido por su calidad fotorrealista, su representación precisa del texto y su control de estilo constante.
+
+El nodo Ideogram V3 actualmente admite dos modos:
+- Modo texto a imagen
+- Modo edición de imágenes (cuando proporcionas las entradas de imagen y máscara)
+
+
 @@ -102,7 +103,7 @@ Sube un video para generar una secuencia de profundidad por fotograma. Dentro de
Abrir en Comfy Cloud
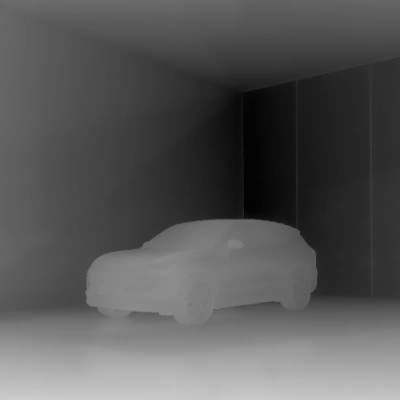 @@ -59,7 +63,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
### 1. Pasos para ejecutar
1. Carga tu imagen de entrada en el nodo `LoadImage`
-2. Encola el flujo de trabajo: el modelo base se ejecuta con la LoRA de profundidad y el nodo Marigold V2 Post-Process normaliza la predicción decodificada
+2. Pon en cola el flujo de trabajo: el modelo base se ejecuta con el LoRA de profundidad y el nodo Posprocesado de Marigold V2 normaliza la predicción decodificada
3. Guarda o previsualiza el mapa de profundidad resultante
### 2. Descargas de modelos
@@ -71,7 +75,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
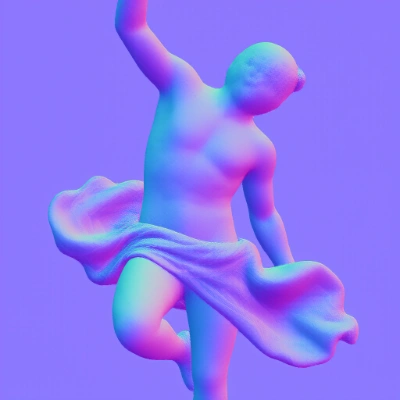 @@ -115,7 +118,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
### 1. Pasos para ejecutar
1. Carga tu imagen de entrada en el nodo `LoadImage`
-2. Encola el flujo de trabajo con la LoRA de normales cargada
+2. Encola el flujo de trabajo con el LoRA de normales cargado
3. Guarda o previsualiza el mapa de normales resultante
### 2. Descargas de modelos
@@ -127,7 +130,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
 +
 -### SDPose: Video Multi-Person Detection {#utility_sdpose_multi_person_video}
+### SDPose: detección de varias personas en video {#utility_sdpose_multi_person_video}
-Sube un video para detectar poses humanas. Admite la detección de una sola persona y de varias personas en la misma escena.
+Sube un video para detectar poses humanas. Admite la detección tanto de una sola persona como de varias personas dentro de la misma escena.
-
 +
 +
 -
 +
 +
 +
 +
 -
 +
 +