diff --git a/es/tutorials/3d/hunyuan3D-2.mdx b/es/tutorials/3d/hunyuan3D-2.mdx
index 577a584714..ba8df4acaf 100644
--- a/es/tutorials/3d/hunyuan3D-2.mdx
+++ b/es/tutorials/3d/hunyuan3D-2.mdx
@@ -2,7 +2,7 @@
title: "Hunyuan3D 2.0 y 2.1 en ComfyUI: flujos de imagen a malla 3D"
description: "Genera mallas 3D en ComfyUI desde una imagen o cuatro vistas consistentes con los modelos open source Hunyuan3D 2.0, 2.1 y turbo de Tencent."
sidebarTitle: "Hunyuan3D-2"
-translationSourceHash: c1132014
+translationSourceHash: 6f829cc4
translationFrom: tutorials/3d/hunyuan3D-2.mdx
translationBlockHashes:
"_intro": 659765dd
@@ -11,8 +11,10 @@ translationBlockHashes:
"Hunyuan3D-2 Single View Workflow": 46e82b79
"Hunyuan3D 2.1 Single View Workflow": 5a8b9bc8
"Community Resources": d12dc58a
+ "Hunyuan3D 2.0 Open-Source Model Series": 363ff037
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
# Introducción a Hunyuan3D 2.0
@@ -51,7 +53,7 @@ Esto cargará el flujo de trabajo correspondiente y te pedirá que descargues lo
## Ejemplo de flujo de trabajo de Hunyuan3D-2mv en ComfyUI
-En el flujo de trabajo de Hunyuan3D-2mv usaremos imágenes multi-vista para generar un modelo 3D. Ten en cuenta que las imágenes de varias vistas no son obligatorias en este flujo de trabajo: puedes usar solo la imagen de la vista `front` para generar un modelo 3D.
+En el flujo de trabajo de Hunyuan3D-2mv usaremos imágenes multivista para generar un modelo 3D. Ten en cuenta que las imágenes de varias vistas no son obligatorias en este flujo de trabajo: puedes usar solo la imagen de la vista `front` para generar un modelo 3D.
@@ -91,22 +93,22 @@ Sube estos archivos a los nodos `LoadImage` correspondientes:
### 1. Flujo de trabajo
-Descarga las imágenes de abajo y arrástralas a ComfyUI para cargar el flujo de trabajo.
+Descarga las siguientes imágenes y arrástralas a ComfyUI para cargar el flujo de trabajo.
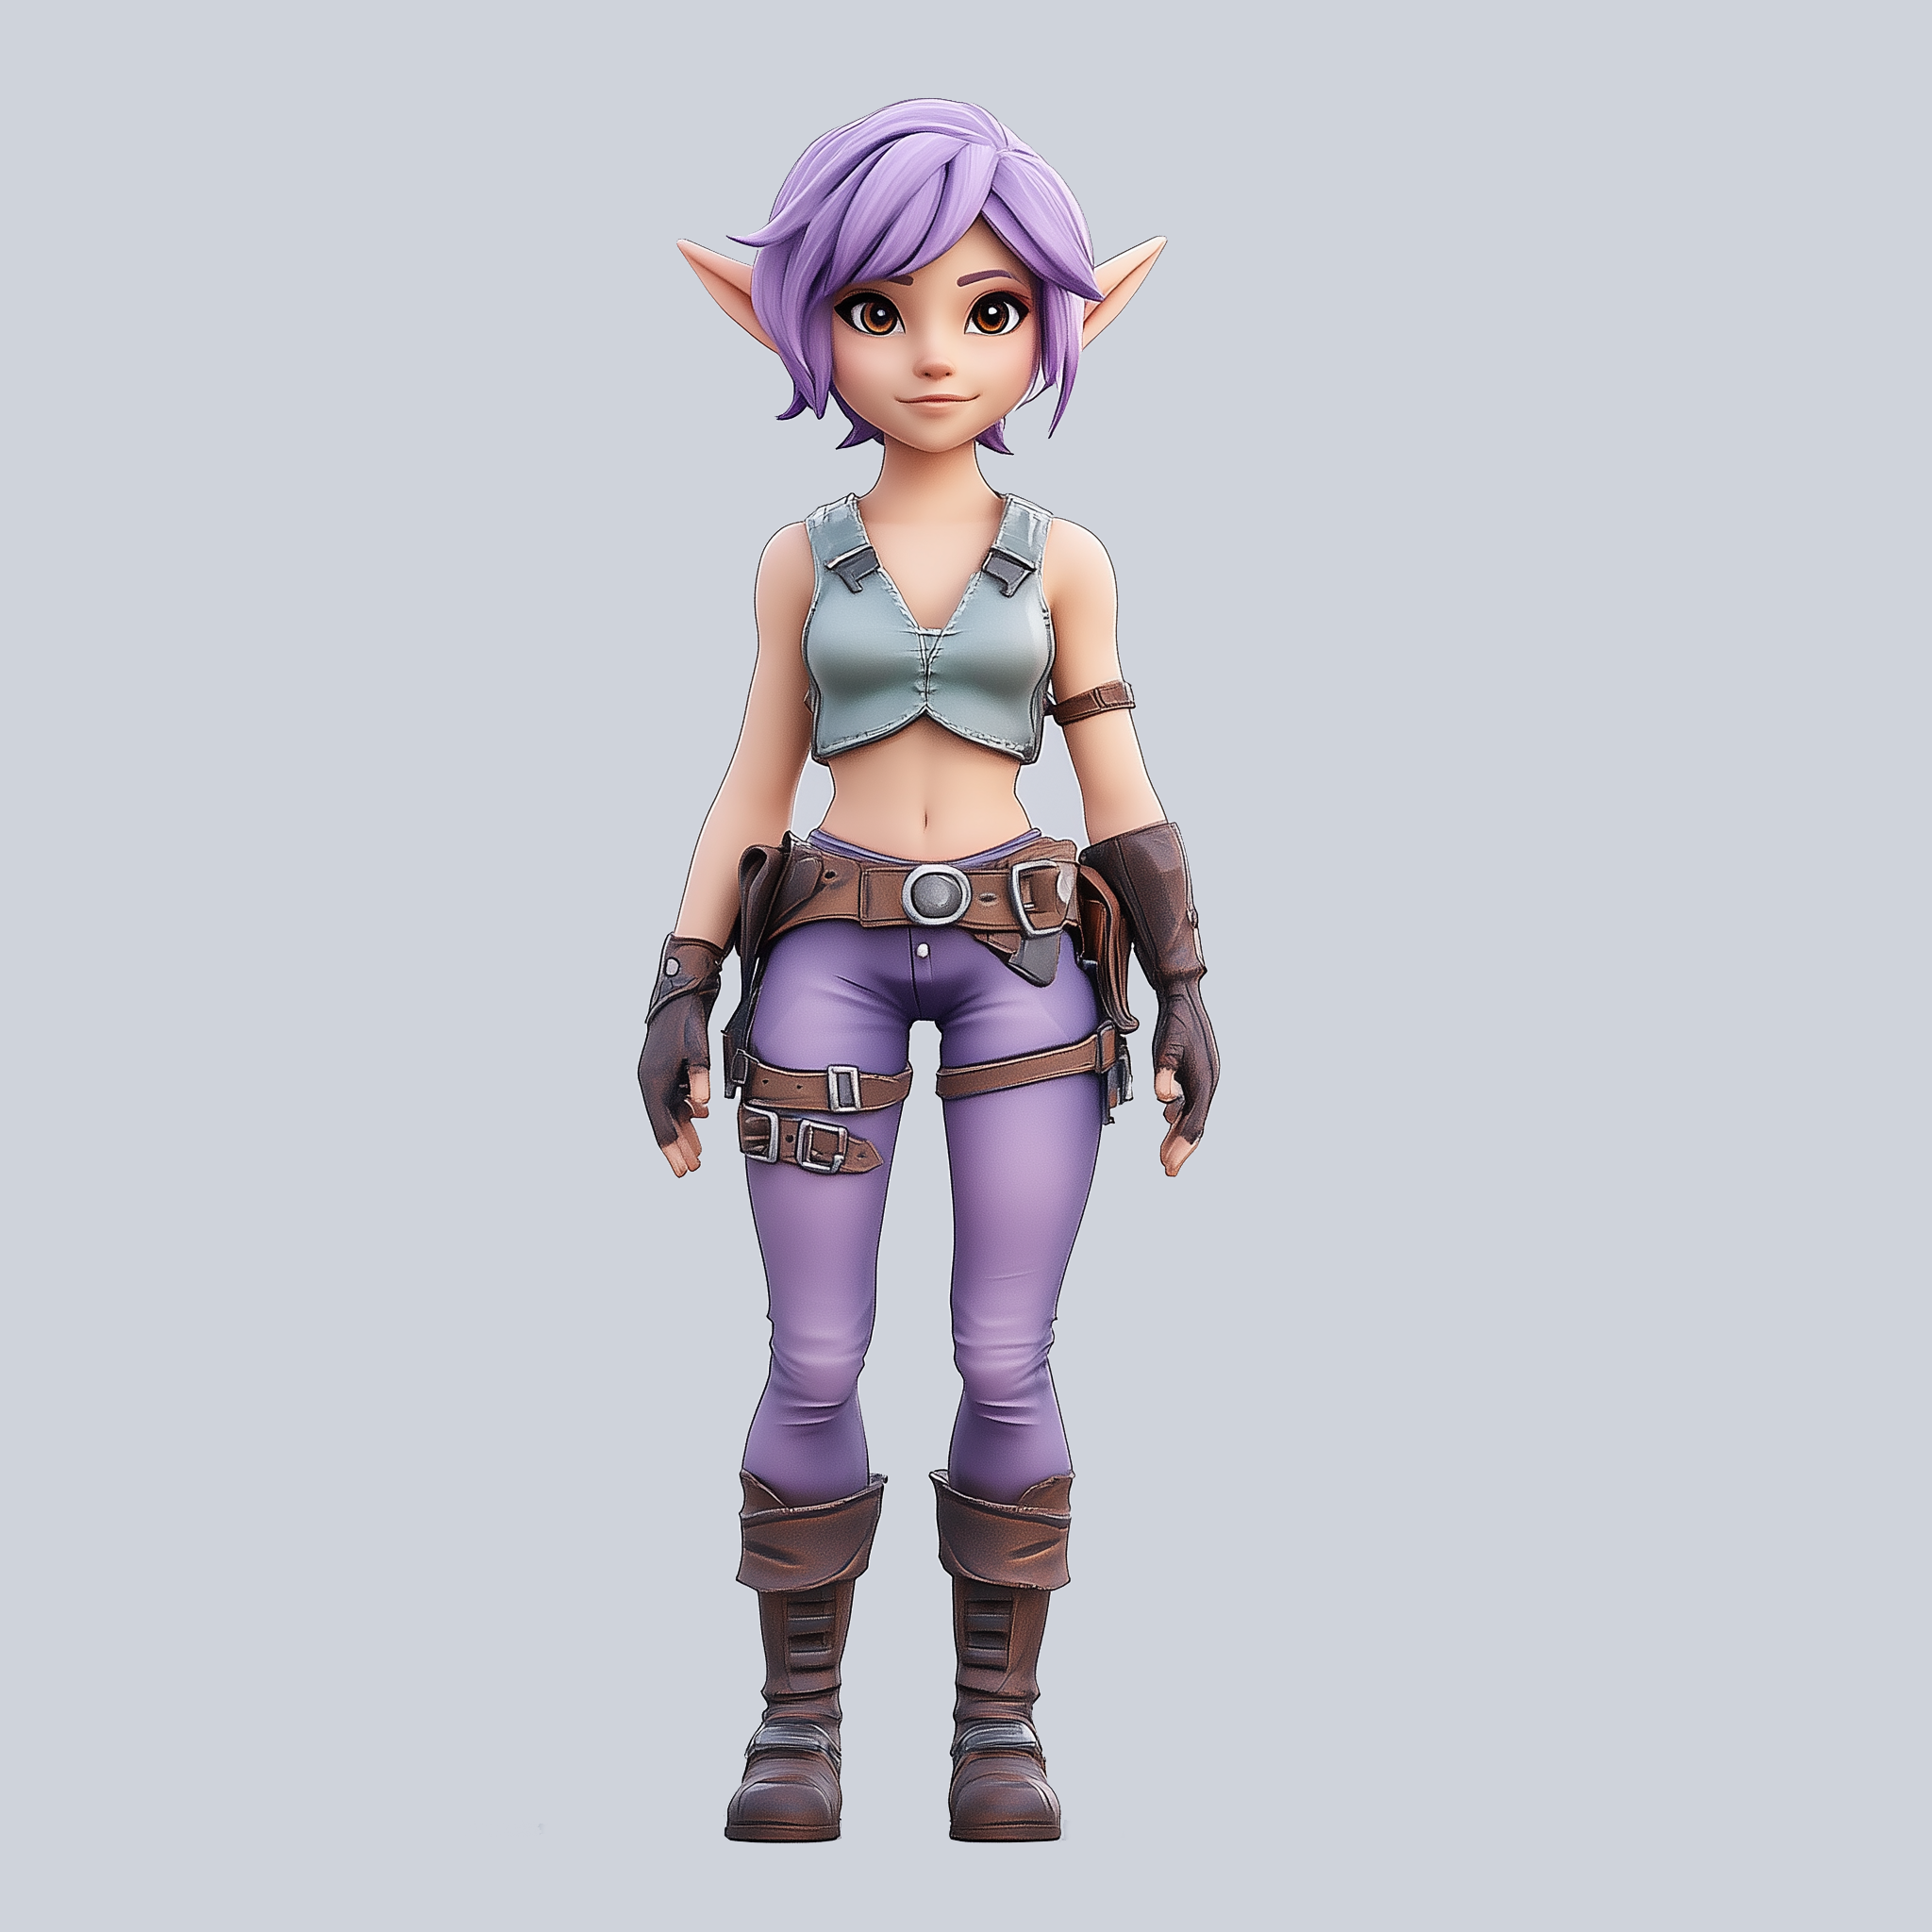
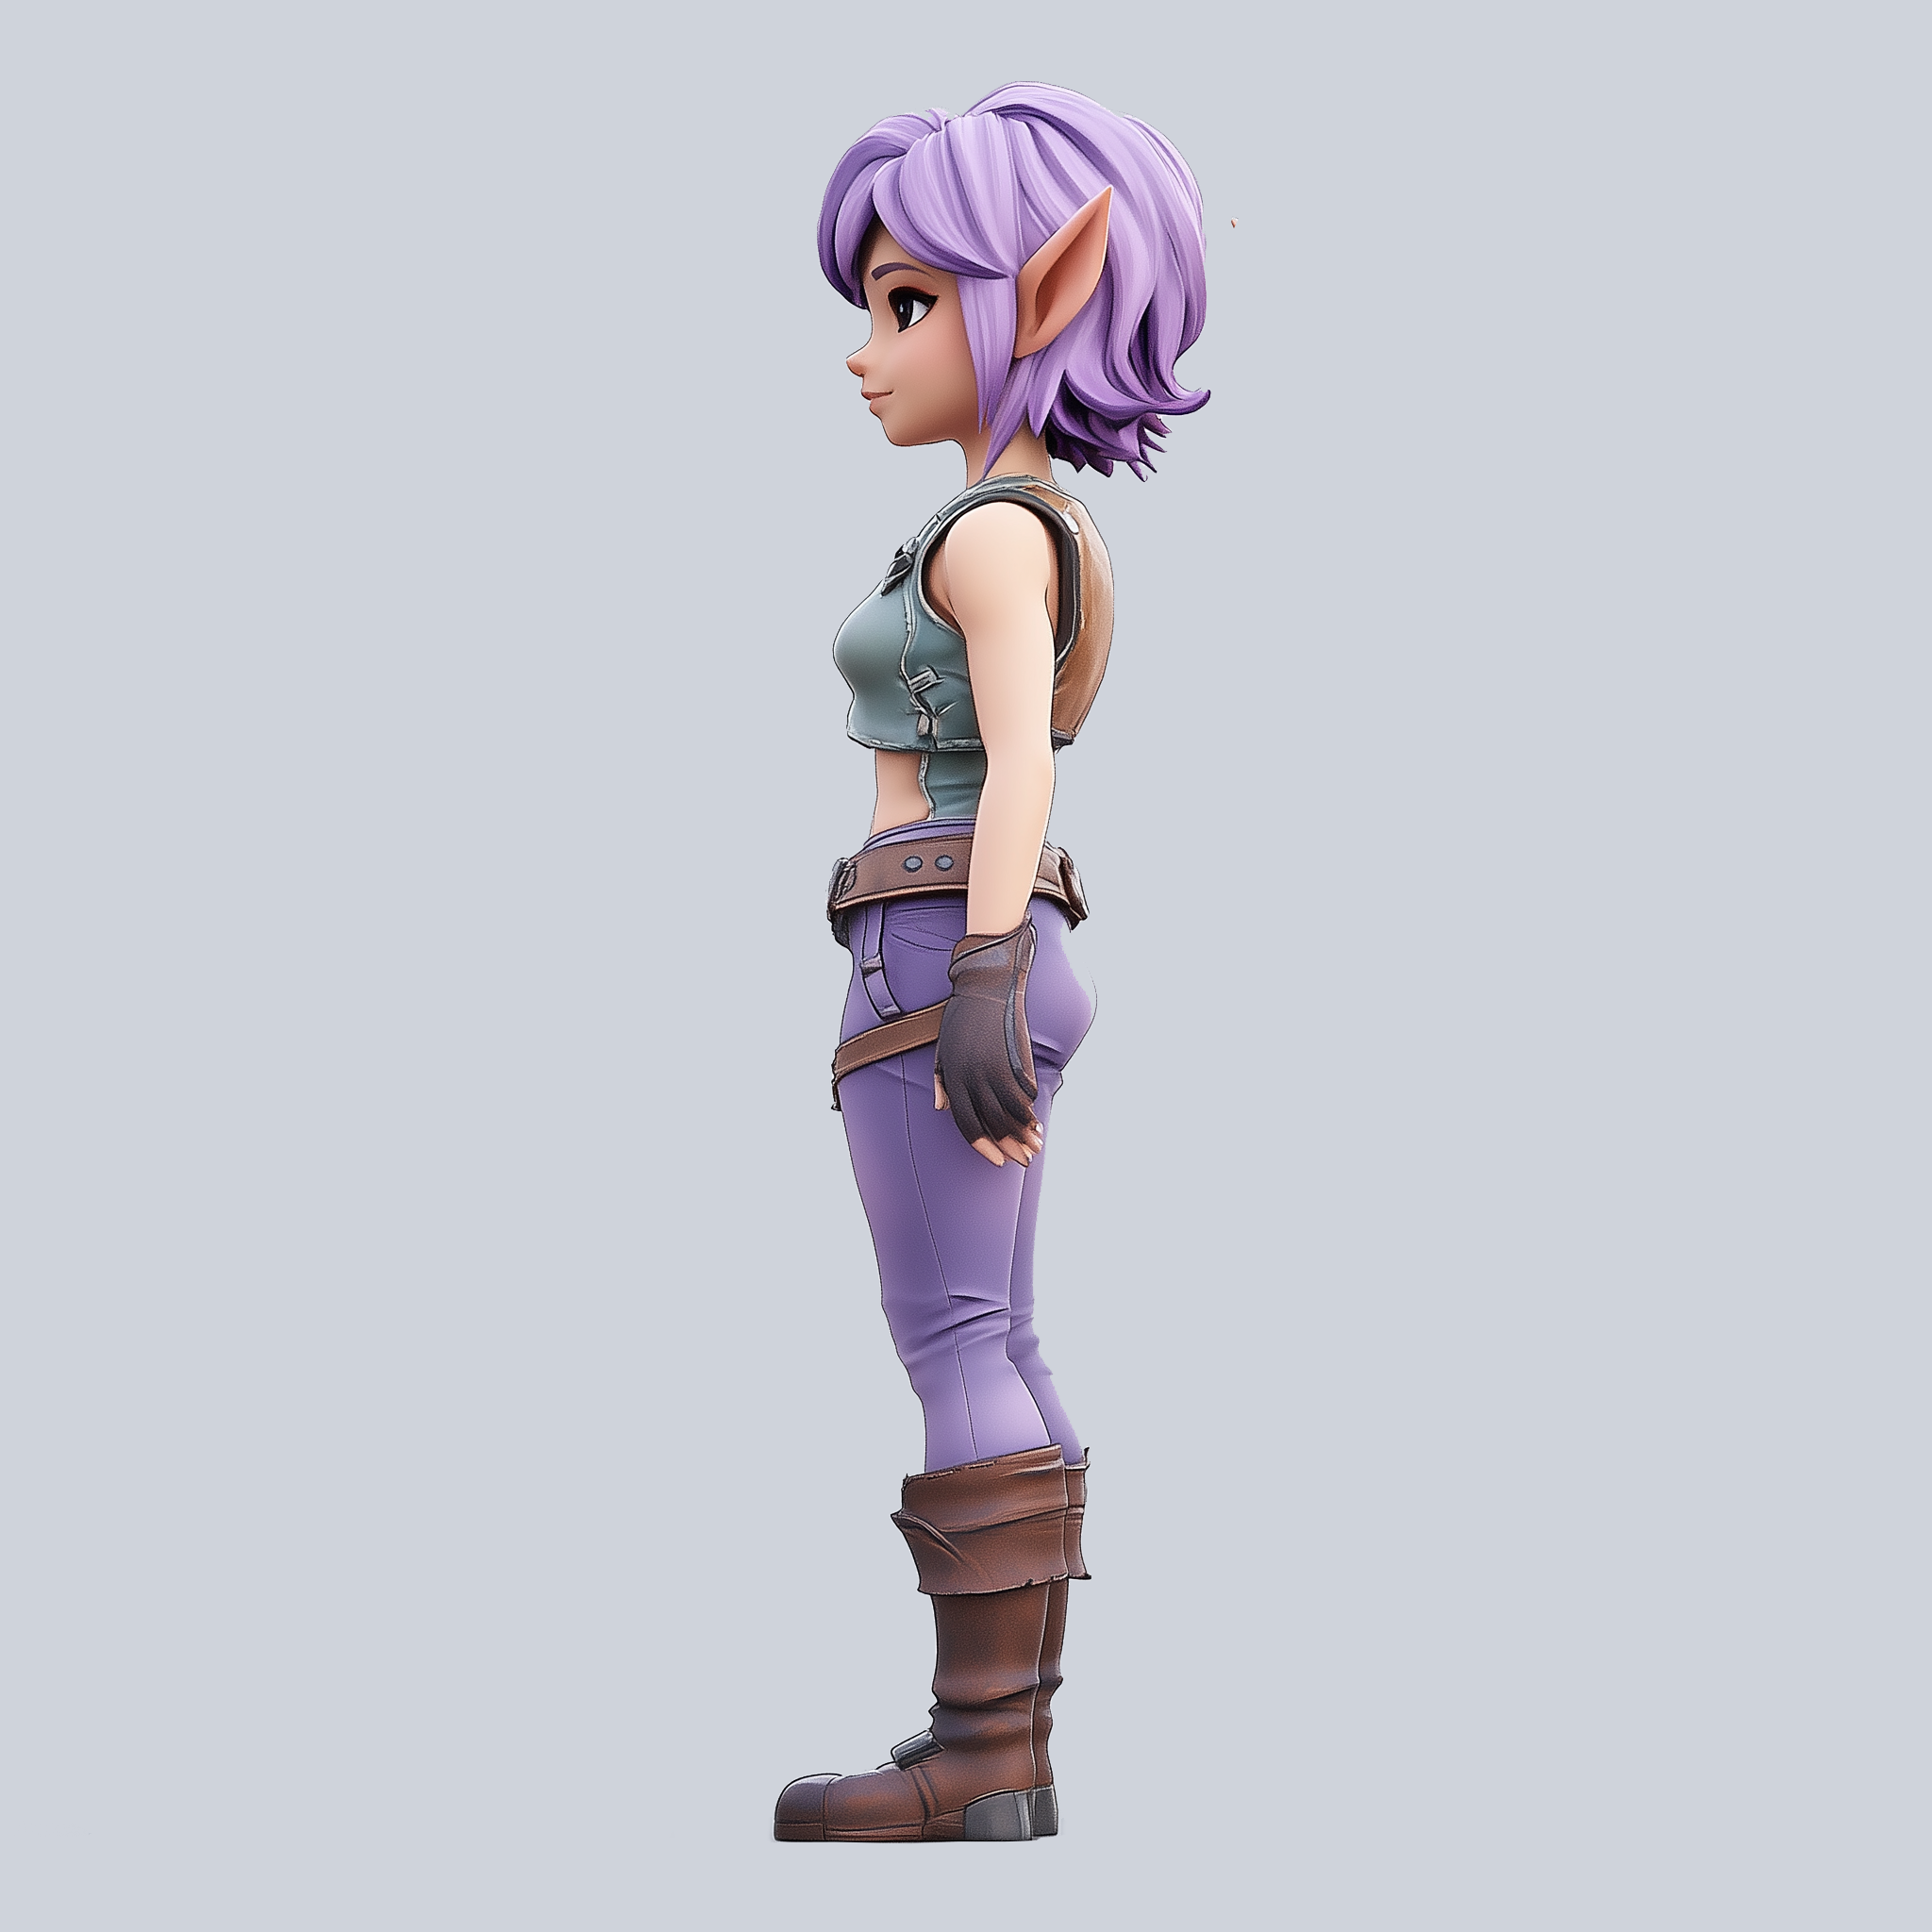
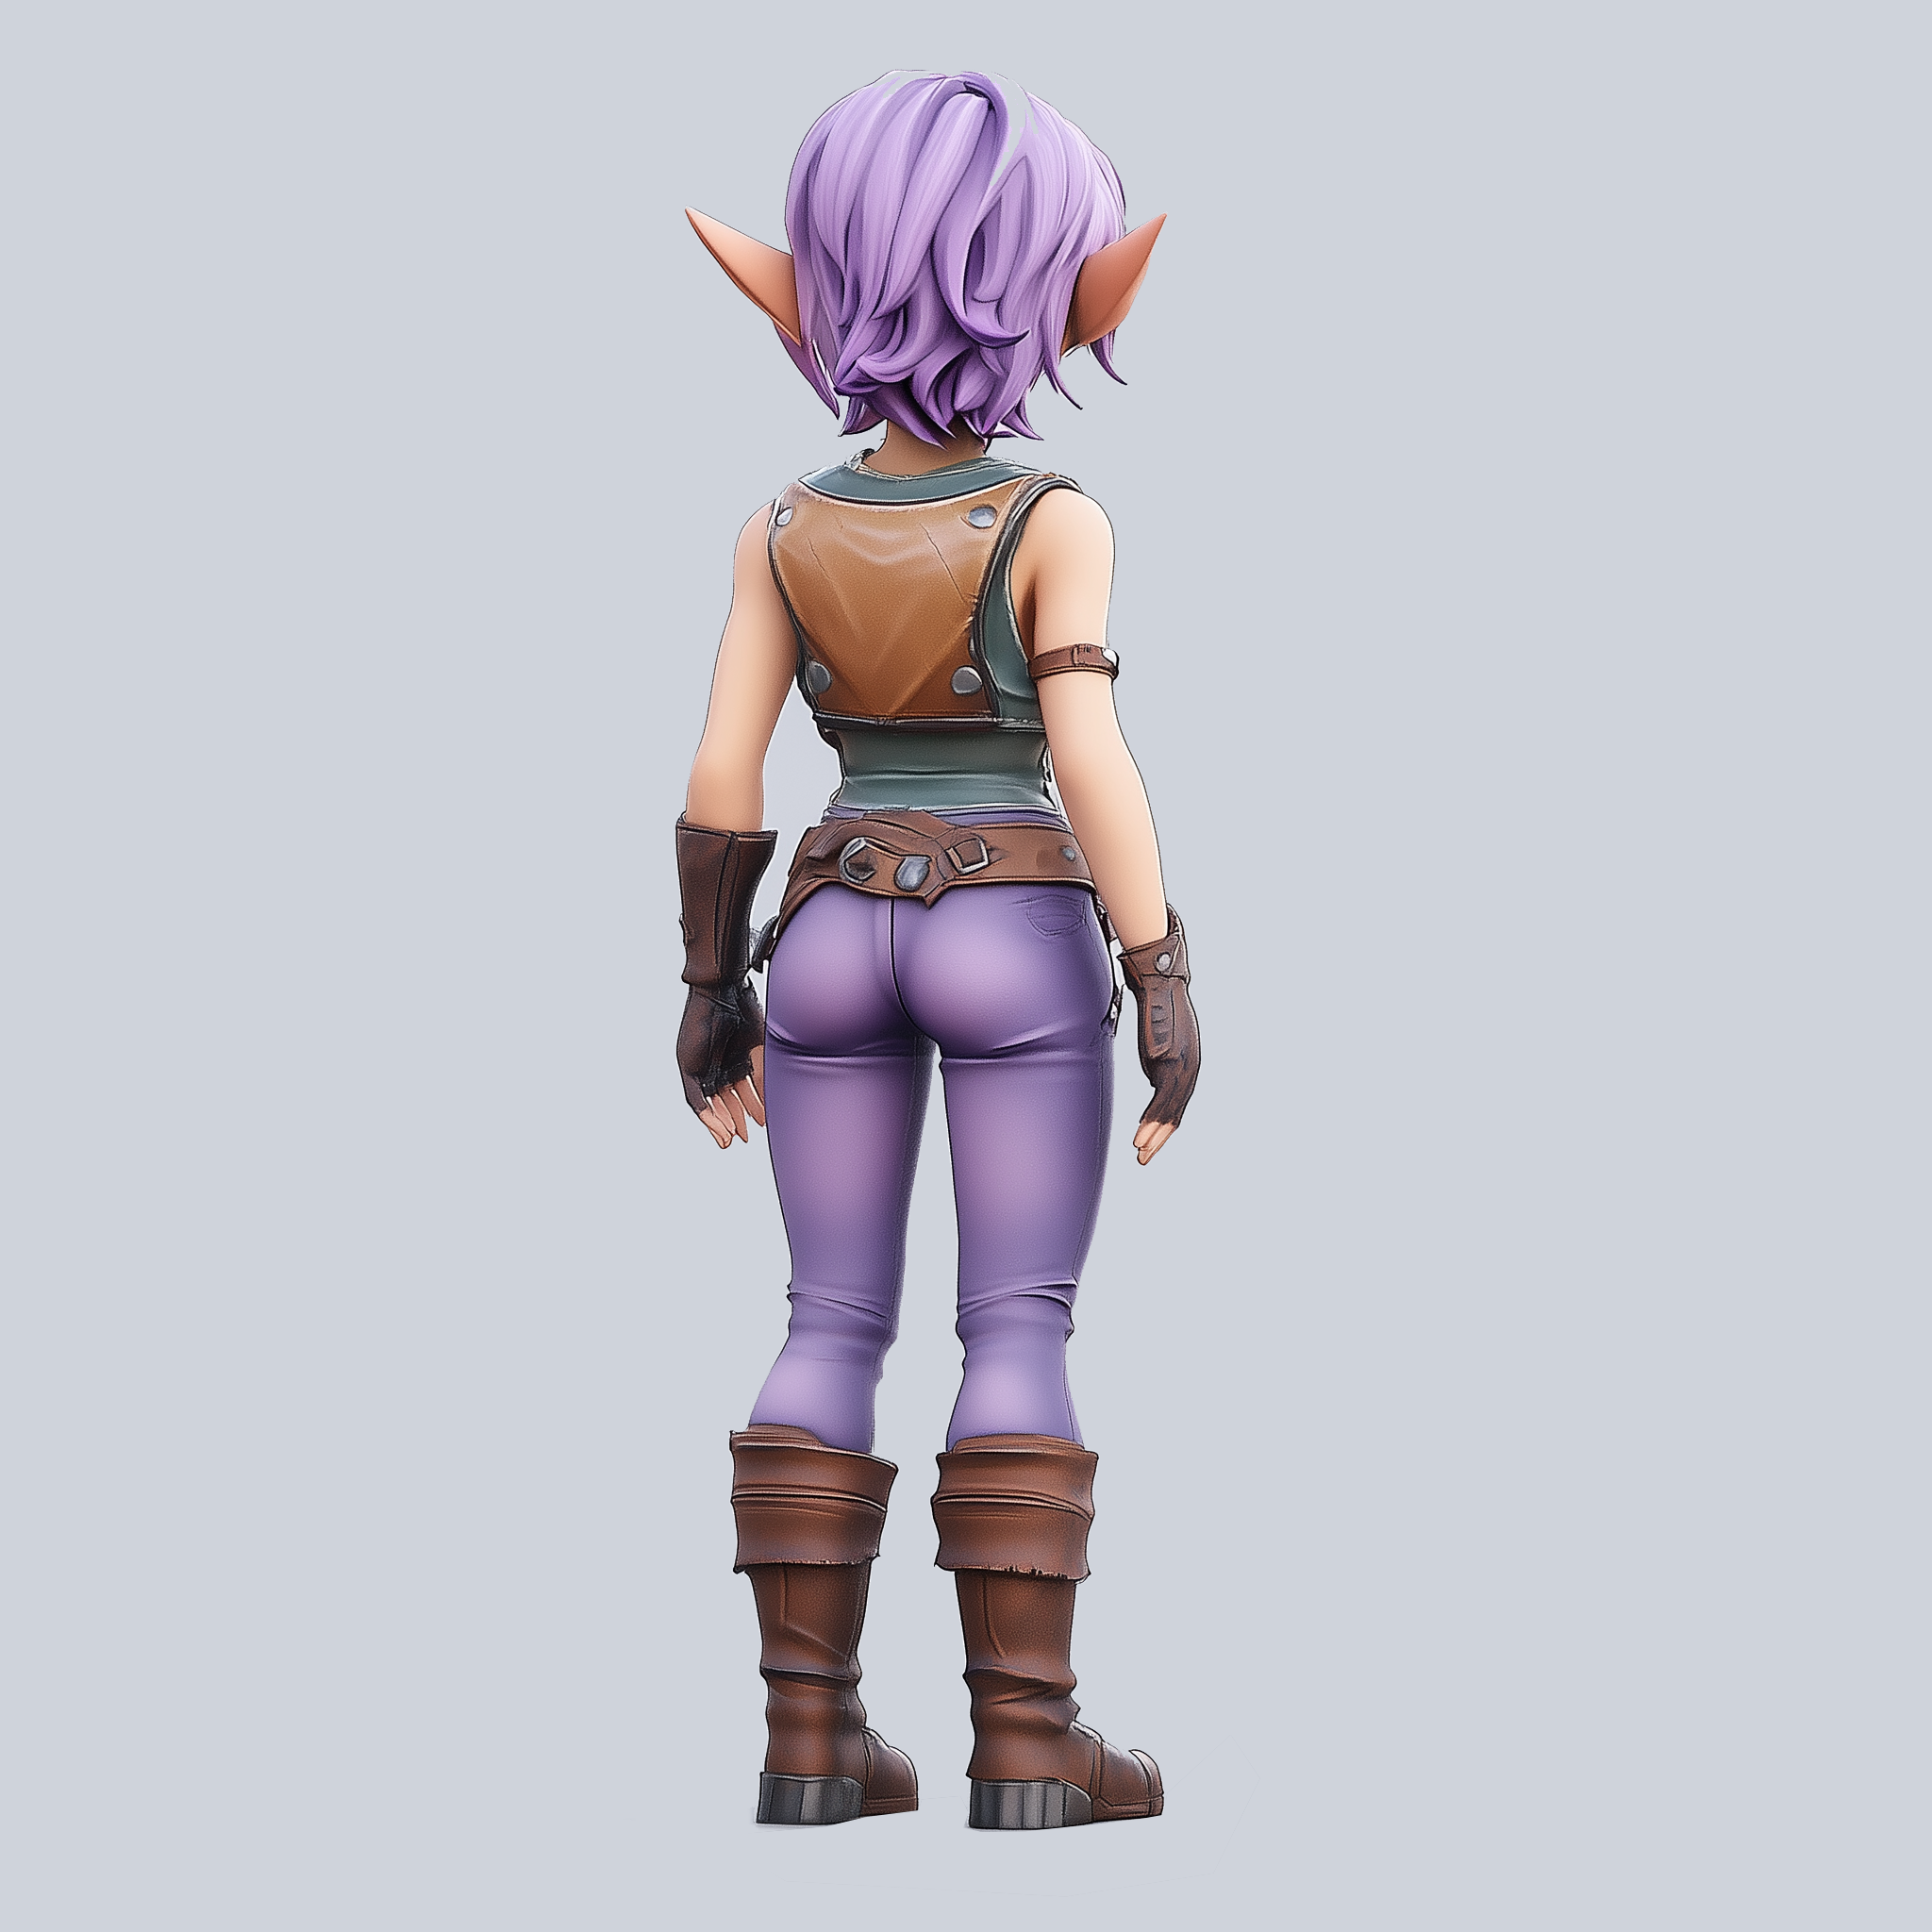
-Descarga las imágenes de abajo, las usaremos como imágenes de entrada.
+Descarga las siguientes imágenes, las usaremos como imágenes de entrada.
-En este ejemplo, las imágenes de entrada ya vienen preprocesadas para eliminar el exceso de fondo. En el uso real, puedes usar Nodos personalizados como [ComfyUI_essentials](https://github.com/cubiq/ComfyUI_essentials) para eliminar automáticamente el exceso de fondo.
+En este ejemplo, las imágenes de entrada ya están preprocesadas para eliminar el exceso de fondo. En la práctica, puedes usar nodos personalizados como [ComfyUI_essentials](https://github.com/cubiq/ComfyUI_essentials) para eliminar automáticamente el exceso de fondo.
### 2. Instalación manual del modelo
-Descarga el modelo de abajo y guárdalo en la carpeta correspondiente de ComfyUI
+Descarga el siguiente modelo y guárdalo en la carpeta correspondiente de ComfyUI
- hunyuan3d-dit-v2-mv: [model.fp16.safetensors](https://huggingface.co/tencent/Hunyuan3D-2mv/blob/main/hunyuan3d-dit-v2-mv/model.fp16.safetensors?download=true) - después de descargarlo, puedes renombrarlo a `hunyuan3d-dit-v2-mv.safetensors`
@@ -122,10 +124,10 @@ ComfyUI/

1. Asegúrate de que el Image Only Checkpoint Loader (modelo img2vid) haya cargado nuestro modelo `hunyuan3d-dit-v2-mv.safetensors` descargado y renombrado
-2. Carga las imágenes de vista correspondientes en cada nodo `Load Image`
+2. Carga las imágenes de vista correspondientes en cada uno de los nodos `Load Image`
3. Haz clic en el botón `Queue` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar el flujo de trabajo
-Si necesitas añadir más vistas, asegúrate de cargar las otras imágenes de vista en el nodo `Hunyuan3Dv2ConditioningMultiView` y de cargar las imágenes de vista correspondientes en los nodos `Load Image`.
+Si necesitas añadir más vistas, asegúrate de cargar las demás imágenes de vista en el nodo `Hunyuan3Dv2ConditioningMultiView` y de cargar las imágenes de vista correspondientes en los nodos `Load Image`.
## Flujo de trabajo Hunyuan3D-2mv-turbo
@@ -135,7 +137,7 @@ En el flujo de trabajo Hunyuan3D-2mv-turbo, usaremos el modelo Hunyuan3D-2mv-tur
Genera modelos 3D a partir de múltiples vistas con Hunyuan3D 2.0 MV Turbo.
-
+
@@ -169,12 +171,12 @@ Sube estos archivos a los nodos `LoadImage` correspondientes:
Descarga las siguientes imágenes y arrástralas a ComfyUI para cargar el flujo de trabajo.
-
+
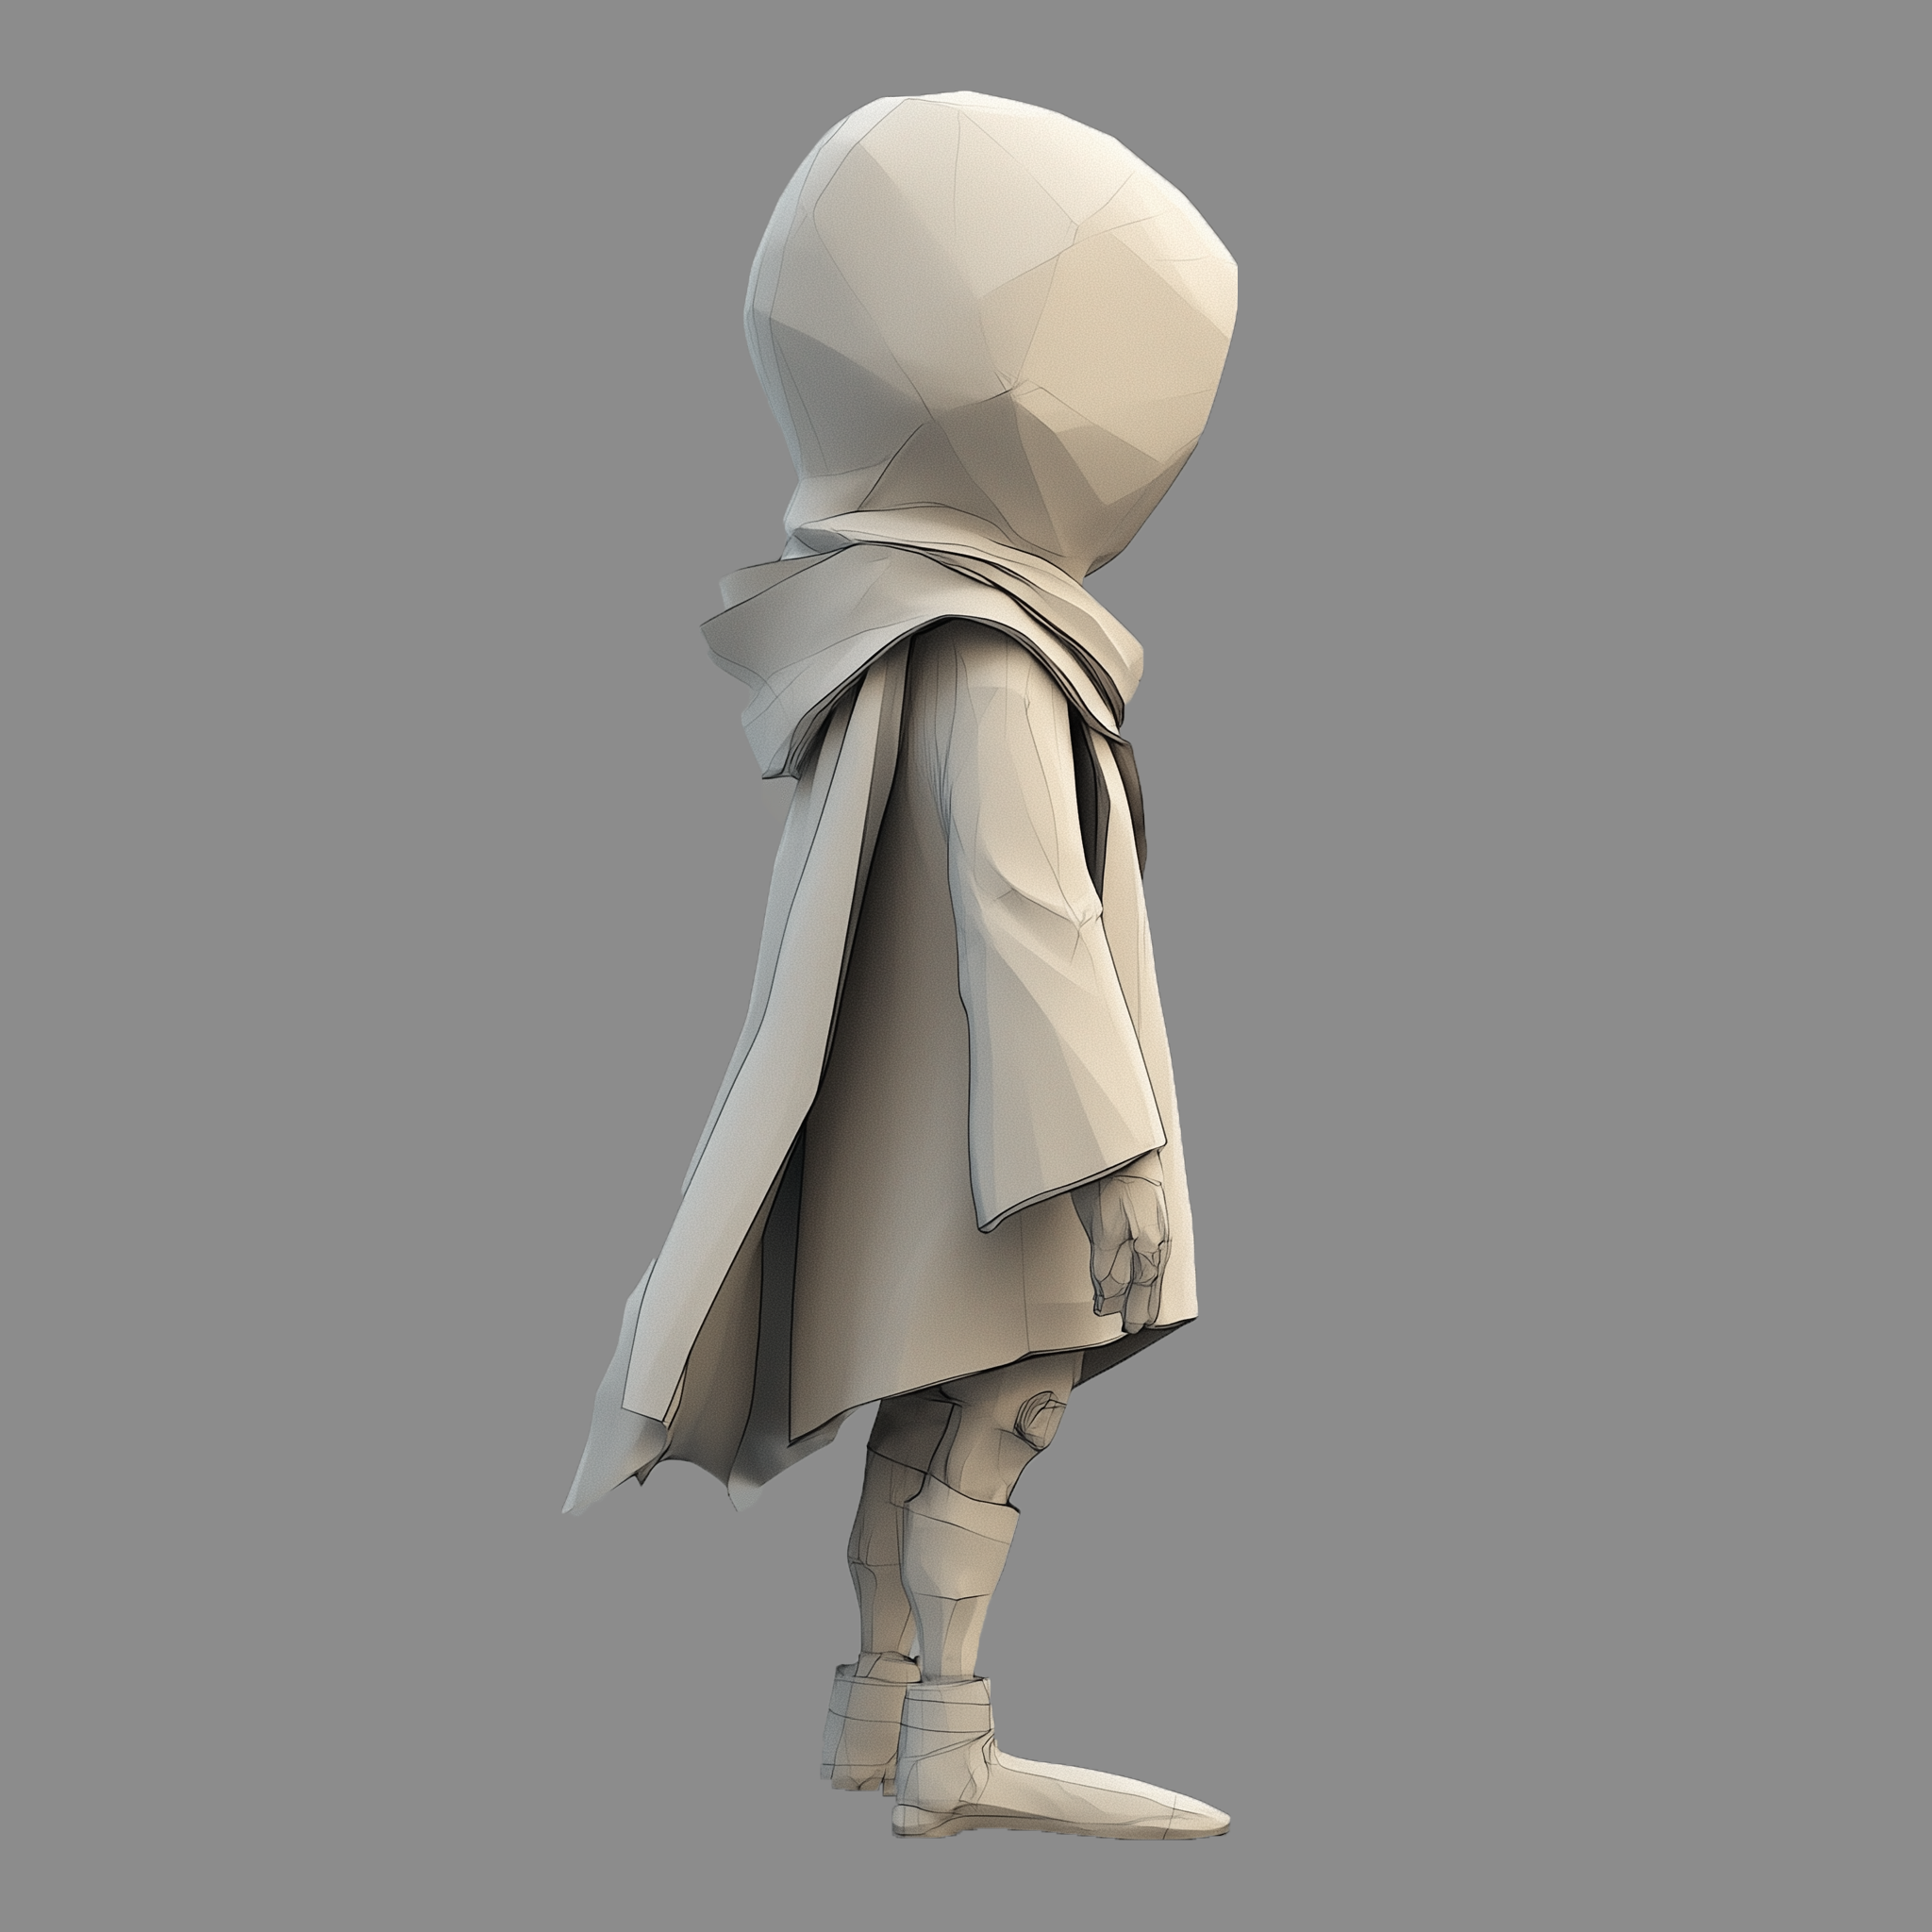
Descarga las siguientes imágenes, ya que las usaremos como imágenes de entrada.
-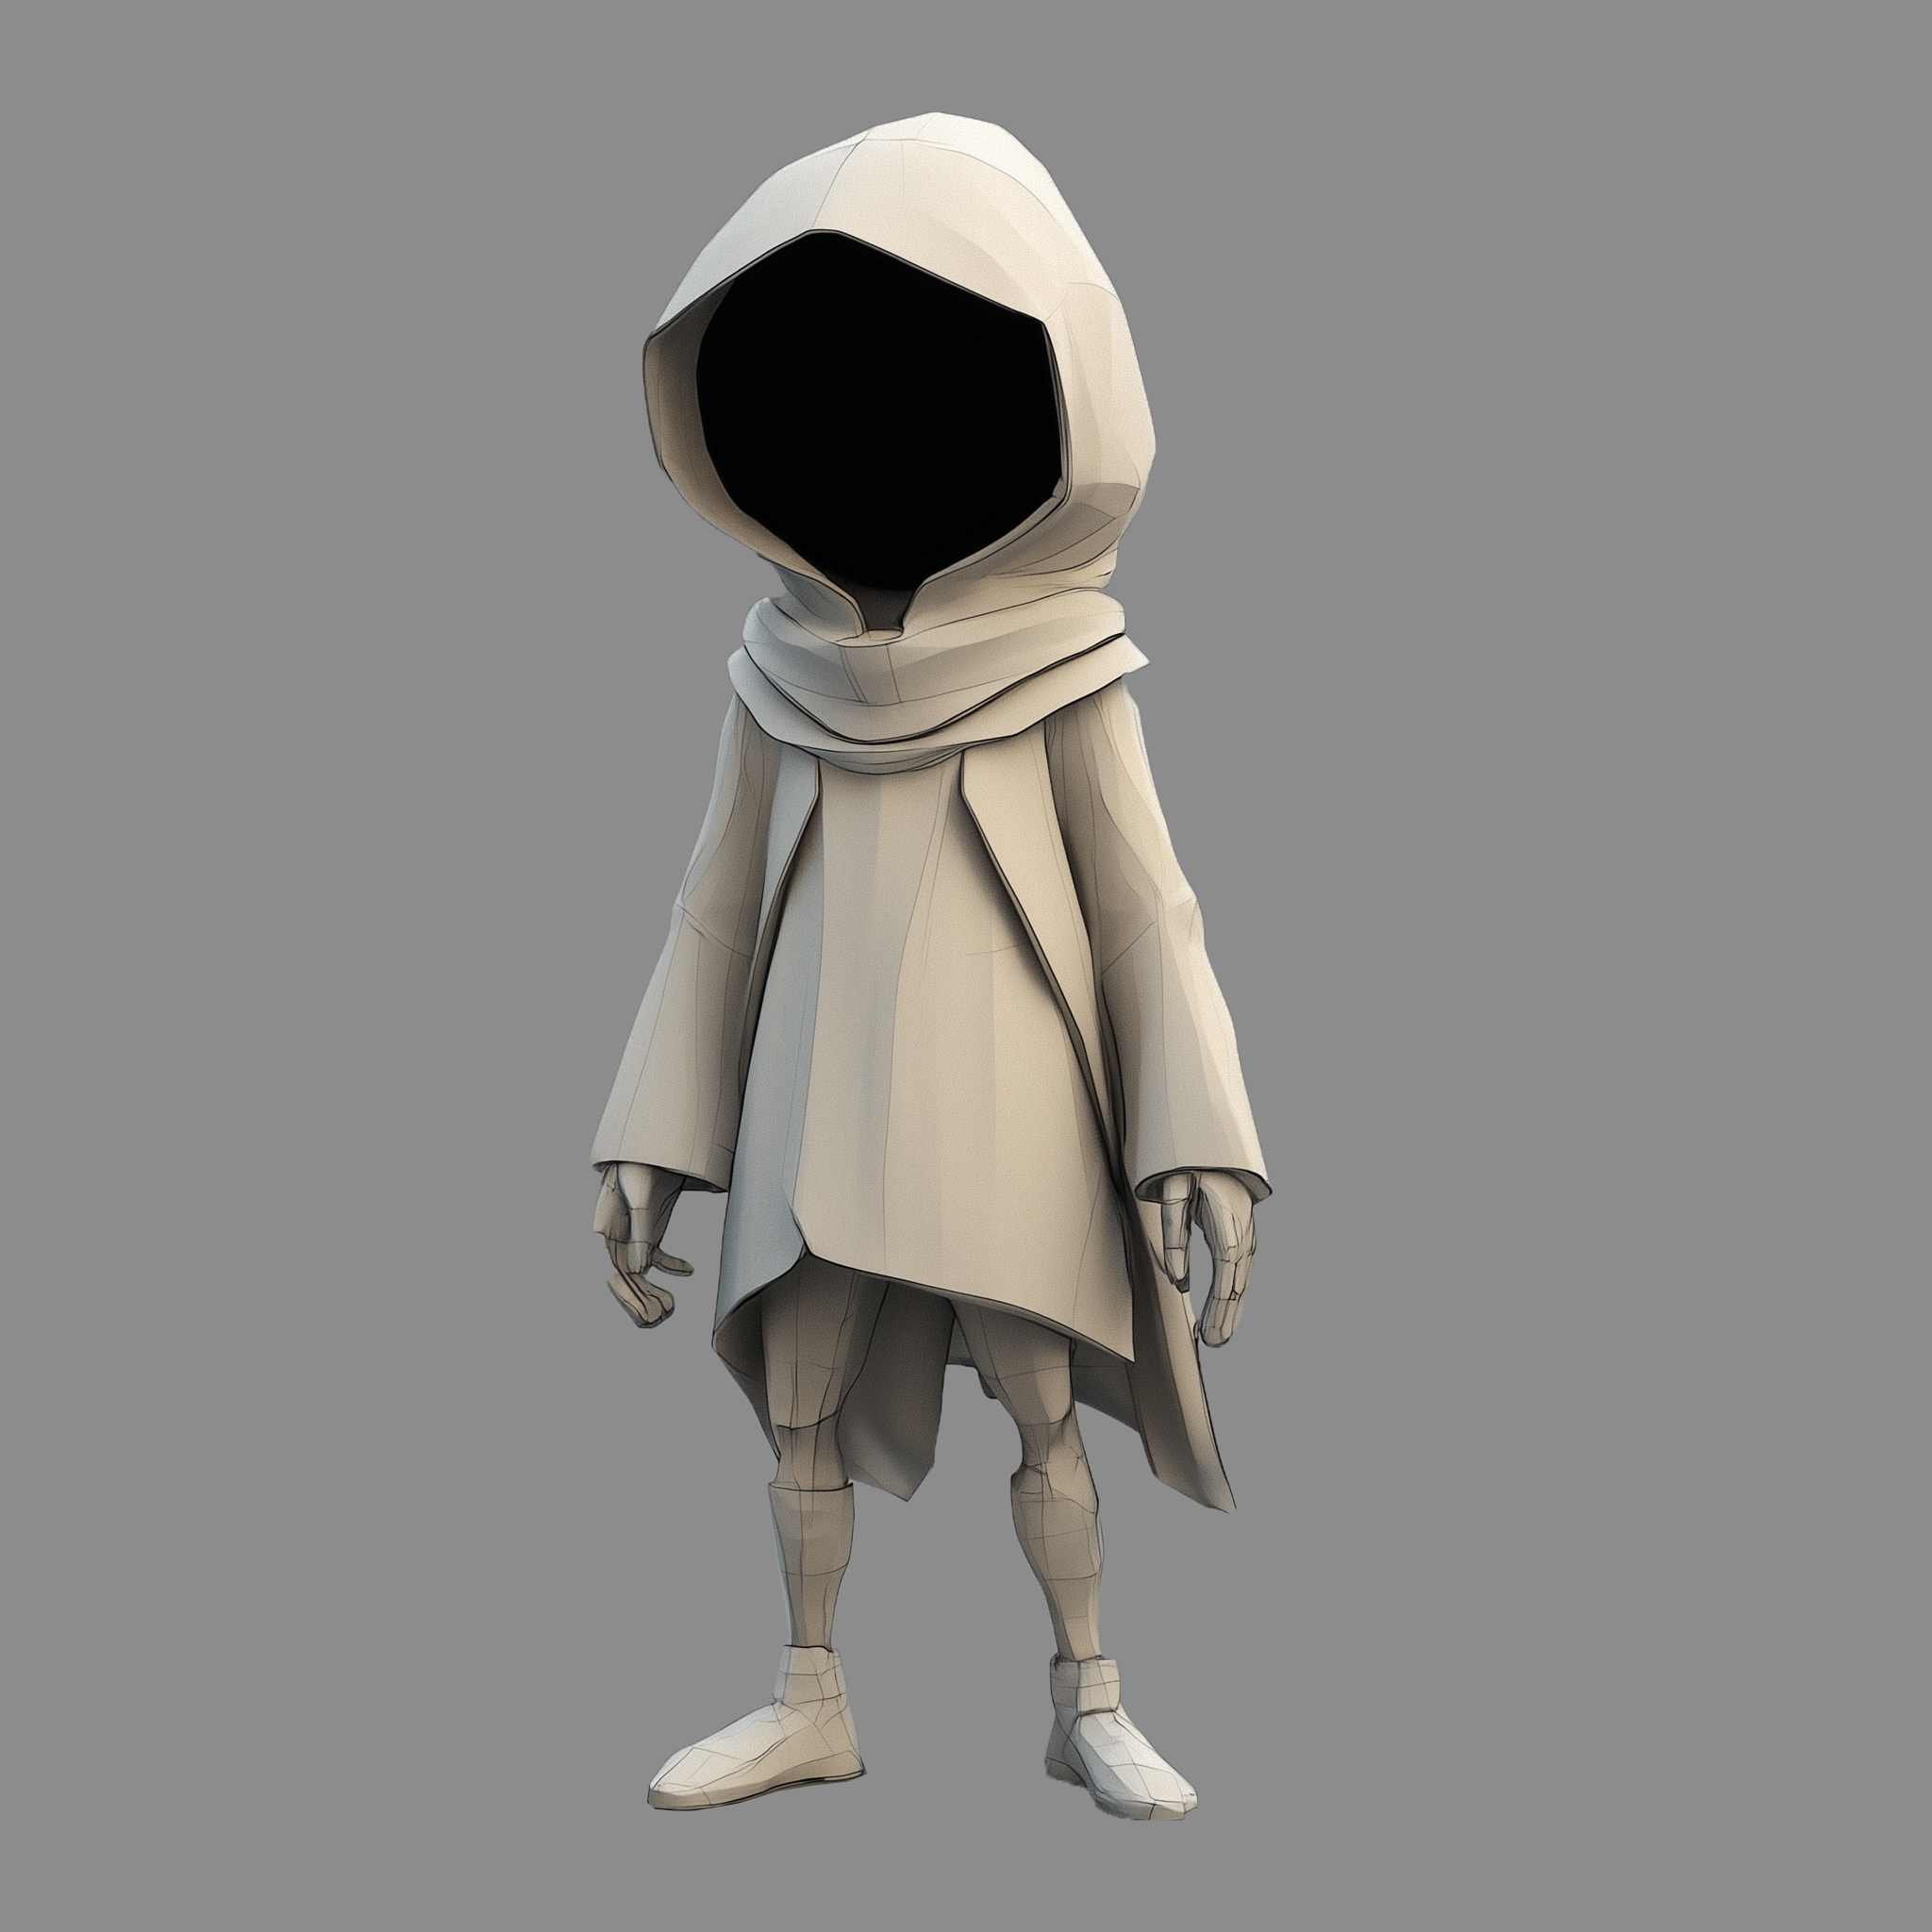
-
+
+
### 2. Instalación manual del modelo
@@ -258,7 +260,7 @@ ComfyUI/
## Flujo de trabajo de vista única de Hunyuan3D 2.1
-Hunyuan3D 2.1 es el modelo de forma posterior de Tencent, lanzado en junio de 2025. Refina la calidad geométrica de Hunyuan3D 2.0, y el checkpoint de ComfyUI reempaqueta el pipeline de forma en un solo archivo, así que este flujo de trabajo necesita una sola descarga de modelo en lugar de archivos DiT y VAE separados. Al igual que los otros flujos de trabajo de esta página, genera una malla sin textura.
+Hunyuan3D 2.1 es el modelo de forma sucesor de Tencent, lanzado en junio de 2025. Refina la calidad geométrica de Hunyuan3D 2.0, y el checkpoint de ComfyUI reempaqueta el pipeline de forma en un solo archivo, así que este flujo de trabajo necesita una sola descarga de modelo en lugar de archivos DiT y VAE separados. Al igual que los otros flujos de trabajo de esta página, genera una malla sin textura.
### HY 3D 2.1 {#3d_hunyuan3d-v2.1}
@@ -325,22 +327,22 @@ Actualmente, Hunyuan3D 2.0 ha publicado como código abierto varios modelos que
**Serie Hunyuan3D-2mini**
-| Modelo | Descripción | Fecha | Parámetros | Huggingface |
-|-----------------------|-------------------------------|------------|------------|-------------------------------------------------------------------------------------------|
-| Hunyuan3D-DiT-v2-mini | Modelo mini de imagen a forma | 2025-03-18 | 0.6B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2mini/tree/main/hunyuan3d-dit-v2-mini) |
+| Modelo | Descripción | Fecha | Parámetros | Huggingface |
+|-----------------------|-------------------------------|------------|------------|--------------------------------------------------------------------------------------------|
+| Hunyuan3D-DiT-v2-mini | Modelo mini de imagen a forma | 2025-03-18 | 0.6B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2mini/tree/main/hunyuan3d-dit-v2-mini) |
**Serie Hunyuan3D-2mv**
-| Modelo | Descripción | Fecha | Parámetros | Huggingface |
-|--------------------------|-----------------------------------------------------------------------------------------------------------------------|------------|------------|--------------------------------------------------------------------------------------------|
-| Hunyuan3D-DiT-v2-mv-Fast | Versión de destilación de guía; puede reducir a la mitad el tiempo de inferencia del DIT | 2025-03-18 | 1.1B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2mv/tree/main/hunyuan3d-dit-v2-mv-fast) |
-| Hunyuan3D-DiT-v2-mv | Modelo de imagen multivista a forma, adecuado para la creación 3D que requiere varios ángulos para entender la escena | 2025-03-18 | 1.1B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2mv/tree/main/hunyuan3d-dit-v2-mv) |
+| Modelo | Descripción | Fecha | Parámetros | Huggingface |
+|--------------------------|--------------------------------------------------------------------------------------------------------------|------------|------------|------------------------------------------------------------------------------------------|
+| Hunyuan3D-DiT-v2-mv-Fast | Versión con destilación de orientación, puede reducir a la mitad el tiempo de inferencia del DIT | 2025-03-18 | 1.1B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2mv/tree/main/hunyuan3d-dit-v2-mv-fast) |
+| Hunyuan3D-DiT-v2-mv | Modelo multivista de imagen a forma, adecuado para creaciones 3D que requieren varios ángulos para comprender la escena | 2025-03-18 | 1.1B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2mv/tree/main/hunyuan3d-dit-v2-mv) |
**Serie Hunyuan3D-2**
-| Modelo | Descripción | Fecha | Parámetros | Huggingface |
-|-------------------------|----------------------------------|------------|------------|-----------------------------------------------------------------------------------------|
-| Hunyuan3D-DiT-v2-0-Fast | Modelo de destilación de guía | 2025-02-03 | 1.1B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2/tree/main/hunyuan3d-dit-v2-0-fast) |
-| Hunyuan3D-DiT-v2-0 | Modelo de imagen a forma | 2025-01-21 | 1.1B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2/tree/main/hunyuan3d-dit-v2-0) |
-| Hunyuan3D-Paint-v2-0 | Modelo de generación de texturas | 2025-01-21 | 1.3B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2/tree/main/hunyuan3d-paint-v2-0) |
-| Hunyuan3D-Delight-v2-0 | Modelo Delight de imagen | 2025-01-21 | 1.3B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2/tree/main/hunyuan3d-delight-v2-0) |
+| Modelo | Descripción | Fecha | Parámetros | Huggingface |
+|-------------------------|----------------------------------------|------------|------------|---------------------------------------------------------------------------------------|
+| Hunyuan3D-DiT-v2-0-Fast | Modelo con destilación de orientación | 2025-02-03 | 1.1B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2/tree/main/hunyuan3d-dit-v2-0-fast) |
+| Hunyuan3D-DiT-v2-0 | Modelo de imagen a forma | 2025-01-21 | 1.1B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2/tree/main/hunyuan3d-dit-v2-0) |
+| Hunyuan3D-Paint-v2-0 | Modelo de generación de texturas | 2025-01-21 | 1.3B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2/tree/main/hunyuan3d-paint-v2-0) |
+| Hunyuan3D-Delight-v2-0 | Modelo Image Delight | 2025-01-21 | 1.3B | [Visitar](https://huggingface.co/tencent/Hunyuan3D-2/tree/main/hunyuan3d-delight-v2-0) |
diff --git a/es/tutorials/3d/pixal3d.mdx b/es/tutorials/3d/pixal3d.mdx
index 9a2aa2df41..d13f40b643 100644
--- a/es/tutorials/3d/pixal3d.mdx
+++ b/es/tutorials/3d/pixal3d.mdx
@@ -2,16 +2,18 @@
title: "Pixal3D en ComfyUI: modelos 3D PBR desde una sola imagen"
description: "Convierte una imagen en un modelo 3D con textura en ComfyUI con Pixal3D, el modelo de imagen a 3D de Tencent ARC con materiales PBR completos."
sidebarTitle: "Pixal3D"
-translationSourceHash: 489b52d9
+translationSourceHash: 6524a7b2
translationFrom: tutorials/3d/pixal3d.mdx
translationBlockHashes:
"_intro": c3d2e1ee
"How it works": 30b7a245
"Steps to run": 1a7d044c
+ "Model downloads": 890d9666
---
+
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-**Pixal3D** es un modelo abierto de imagen a 3D de Tencent ARC, presentado en SIGGRAPH 2026. Convierte una sola imagen en un recurso 3D de alta fidelidad con materiales PBR completos.
+**Pixal3D** es un modelo de imagen a 3D de código abierto de Tencent ARC, presentado en SIGGRAPH 2026. Convierte una sola imagen en un recurso 3D de alta fidelidad con materiales PBR completos.
La mayoría de los generadores nativos 3D sintetizan formas en un espacio canónico e inyectan señales de la imagen mediante atención, lo que deja ambiguas las asociaciones entre píxeles y 3D. Pixal3D, en cambio, usa generación alineada a píxeles: establece una correspondencia directa entre píxeles y 3D mediante retroproyección, de modo que el frente del modelo generado coincide 1:1 con tu imagen de entrada, sin texturas deformadas ni desalineadas.
@@ -99,44 +101,44 @@ Este flujo de trabajo usa los modelos que se indican a continuación. Descárgal
Pixal3D combina una generación consciente de la cámara y alineada por píxeles con un pipeline completo de posprocesamiento de malla:
-1. **Eliminación de fondo**: BiRefNet elimina el fondo de la imagen de entrada y el flujo de trabajo recorta el sujeto a un lienzo centrado. Un interruptor te permite saltar la eliminación de fondo
-2. **Estimación de cámara**: MoGe estima la geometría y el campo de visión de la cámara a partir de la imagen. El campo de visión impulsa el acondicionamiento alineado por píxeles
-3. **Generación de estructura**: se muestrea un latente de estructura dispersa y se decodifica en vóxeles, que luego se convierten en una malla aproximada
-4. **Refinamiento de forma**: la etapa de forma y la etapa de upsampling refinan la malla hasta la resolución objetivo (1536)
-5. **Generación de texturas**: una etapa de difusión de texturas produce vóxeles de material PBR (color base, metalicidad, rugosidad)
-6. **Posprocesamiento**: remesh DC, decimación QEM, desplegado UV y horneado de mapas de color base, normales y oclusión ambiental en la malla texturizada final
+1. **Eliminación de fondo**: BiRefNet elimina el fondo de la imagen de entrada y el flujo de trabajo recorta el sujeto a un lienzo centrado. Un interruptor te permite saltar la eliminación de fondo.
+2. **Estimación de la cámara**: MoGe estima la geometría y el campo de visión de la cámara a partir de la imagen. El campo de visión determina el acondicionamiento alineado por píxeles.
+3. **Generación de la estructura**: se muestrea un latente de estructura dispersa y se decodifica en vóxeles, que luego se convierten en una malla aproximada.
+4. **Refinamiento de la forma**: la etapa de forma y la etapa de upsampling refinan la malla hasta la resolución objetivo (1536).
+5. **Generación de texturas**: una etapa de difusión de texturas produce vóxeles de material PBR (color base, metalicidad, rugosidad).
+6. **Posprocesamiento**: remesh DC, decimación QEM, desplegado UV y horneado de mapas de color base, normales y oclusión ambiental en la malla texturizada final.
-## Pasos para ejecutar
+## Pasos para ejecutar {#steps-to-run}
-1. **Carga una imagen**: usa el nodo `LoadImage` para cargar una sola imagen del objeto.
-2. **Pon el flujo de trabajo en cola**: presiona Ctrl (Cmd en macOS) + Enter.
-3. **Espera a que se complete el pipeline**: las etapas de estructura, forma y textura se ejecutan en secuencia, seguidas del posprocesamiento.
-4. **Consulta el resultado**: revisa la malla en el nodo `Preview3DAdvanced`. El modelo 3D se guarda en `ComfyUI/output/3d/ComfyUI/`.
+1. **Carga una imagen**: usa el nodo `LoadImage` para cargar una sola imagen del objeto
+2. **Pon el flujo de trabajo en cola**: presiona Ctrl (Cmd en macOS) + Enter
+3. **Espera a que se ejecute el pipeline**: las etapas de estructura, forma y textura se ejecutan en secuencia, seguidas del posprocesamiento
+4. **Consulta el resultado**: revisa la malla en el nodo `Preview3DAdvanced`. El modelo 3D se guarda en `ComfyUI/output/3d/ComfyUI/`
## Descargas de modelos
-Descarga los modelos que usa este flujo de trabajo. Los dos checkpoints de difusión son obligatorios: el interruptor elige cuál se ejecuta. Colócalos en los subdirectorios correspondientes de `models/`.
+Descarga los modelos que usa este flujo de trabajo. Ambos checkpoints de difusión son requeridos: el selector determina cuál se ejecuta. Colócalos en los subdirectorios correspondientes de `models/`.
- pixal3d_int8_convrot.safetensors: modelo de difusión de Pixal3D, cargado de forma predeterminada
+ pixal3d_int8_convrot.safetensors: modelo de difusión Pixal3D, que se carga de forma predeterminada
- trellis_2_int8_convrot.safetensors: modelo de difusión de TRELLIS.2, cargado cuando el interruptor está en `true`
+ trellis_2_int8_convrot.safetensors: modelo de difusión TRELLIS.2, que se carga cuando el selector está en `true`
-
- trellis_2_shape_vae_bf16.safetensors: VAE para la decodificación de estructura y forma
+
+ trellis_2_shape_vae_bf16.safetensors: VAE para decodificar estructura y forma
-
- trellis_2_texture_vae_bf16.safetensors: VAE para la decodificación de texturas
+
+ trellis_2_texture_vae_bf16.safetensors: VAE para decodificar texturas
- dino_v3_L_naf_fp32.safetensors: codificador de visión CLIP para el acondicionamiento de imágenes
+ dino_v3_L_naf_fp32.safetensors: codificador de visión CLIP para el acondicionamiento de imagen
-
- moge_2_vitl_normal_fp16.safetensors: estimación de profundidad y de cámara para el acondicionamiento alineado por píxeles
+
+ moge_2_vitl_normal_fp16.safetensors: estimación de profundidad y cámara para el acondicionamiento alineado a píxeles
-
+
birefnet.safetensors: modelo de eliminación de fondo para el preprocesamiento
@@ -159,3 +161,4 @@ Descarga los modelos que usa este flujo de trabajo. Los dos checkpoints de difus
│ └── 📂 background_removal/
│ └── birefnet.safetensors
```
+
diff --git a/es/tutorials/3d/trellis2.mdx b/es/tutorials/3d/trellis2.mdx
index 4c1c2c761c..326da728f4 100644
--- a/es/tutorials/3d/trellis2.mdx
+++ b/es/tutorials/3d/trellis2.mdx
@@ -2,18 +2,20 @@
title: "TRELLIS.2 en ComfyUI: imagen a modelos 3D con texturas PBR"
description: "Convierte una sola imagen en un modelo 3D con textura en ComfyUI con TRELLIS.2, el modelo open source de 4B de Microsoft, junto a Pixal3D en un mismo flujo."
sidebarTitle: "TRELLIS.2"
-translationSourceHash: 3e73a8a0
+translationSourceHash: ec22c0fe
translationFrom: tutorials/3d/trellis2.mdx
translationBlockHashes:
"_intro": 5168e8d6
"How it works": e79c0e78
"Steps to run": f899f7e5
+ "Model downloads": 125142da
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-**TRELLIS.2** es un modelo de imagen a 3D de código abierto de Microsoft Research y el sucesor de TRELLIS. Es un modelo de 4B parámetros construido sobre VAE 3D nativos con compresión espacial de 16× y una representación de vóxeles dispersos llamada O-Voxel, que produce recursos 3D detallados con materiales PBR completos a partir de una sola imagen.
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
-TRELLIS.2 comparte su arquitectura base con Pixal3D: ambos usan el mismo codificador de imágenes DINOv3, los mismos VAE de forma y textura, y las mismas etapas de generación de estructura, forma y textura. Solo cambian el modelo de difusión principal y el formato de acondicionamiento. Si ya has ejecutado el [flujo de trabajo de Pixal3D](/es/tutorials/3d/pixal3d), la configuración del modelo es casi idéntica.
+**TRELLIS.2** es un modelo de código abierto de imagen a 3D de Microsoft Research y el sucesor de TRELLIS. Es un modelo de 4B parámetros construido sobre VAE 3D nativos con compresión espacial de 16× y una representación de vóxeles dispersos llamada O-Voxel, que produce recursos 3D detallados con materiales PBR completos a partir de una sola imagen.
+
+TRELLIS.2 comparte su arquitectura base con Pixal3D: ambos usan el mismo codificador de imágenes DINOv3, los mismos VAE de forma y textura, y las mismas etapas de generación de estructura, forma y textura. Solo difieren el modelo de difusión principal y el formato de acondicionamiento. Si ya has ejecutado el [flujo de trabajo de Pixal3D](/es/tutorials/3d/pixal3d), la configuración del modelo es casi idéntica.
### TRELLIS.2: modelo 3D a partir de una imagen {#trellis2}
@@ -50,11 +52,11 @@ Sube este archivo al nodo `LoadImage`:
## Cómo funciona
-TRELLIS.2 genera un recurso 3D en tres etapas de difusión y luego ejecuta un pipeline completo de posprocesamiento de la malla:
+TRELLIS.2 genera un recurso 3D en tres etapas de difusión y después ejecuta un pipeline completo de posprocesamiento de la malla:
1. **Eliminación de fondo**: BiRefNet elimina el fondo de la imagen de entrada y el flujo de trabajo recorta el sujeto a un lienzo centrado. Un interruptor te permite saltar la eliminación de fondo
2. **Generación de estructura**: se muestrea un latente de estructura dispersa y se decodifica en vóxeles, que luego se convierten en una malla aproximada
-3. **Refinamiento de forma**: la etapa de forma y la etapa de sobremuestreo refinan la malla hasta la resolución objetivo (1536)
+3. **Refinamiento de forma**: la etapa de forma y la etapa de upsampling refinan la malla hasta la resolución objetivo (1536)
4. **Generación de textura**: una etapa de difusión de textura produce vóxeles de material PBR (color base, metalicidad, rugosidad)
5. **Posprocesamiento**: DC remesh, QEM decimation, UV unwrapping y baking de mapas de color base, normal y oclusión ambiental en la malla texturizada final
@@ -63,30 +65,30 @@ TRELLIS.2 genera un recurso 3D en tres etapas de difusión y luego ejecuta un pi
1. **Carga una imagen**: usa el nodo `LoadImage` para cargar una sola imagen del objeto
2. **Cambia al pipeline de TRELLIS.2**: establece `Boolean (Switch to Trellis2)` en `true`. El flujo de trabajo carga el checkpoint de TRELLIS.2 automáticamente
3. **Envía el flujo de trabajo a la cola**: presiona Ctrl (Cmd en macOS) + Enter
-4. **Espera al pipeline**: las etapas de estructura, forma y textura se ejecutan en secuencia, seguidas del posprocesamiento
-5. **Visualiza el resultado**: revisa la malla en el nodo `Preview3DAdvanced`. El modelo 3D se guarda en `ComfyUI/output/3d/ComfyUI/`
+4. **Espera a que termine el pipeline**: las etapas de estructura, forma y textura se ejecutan en secuencia, seguidas del posprocesamiento
+5. **Revisa el resultado**: inspecciona la malla en el nodo `Preview3DAdvanced`. El modelo 3D se guarda en `ComfyUI/output/3d/ComfyUI/`
-## Descarga de modelos
+## Descargas de modelos
-Descarga los modelos que usa este flujo de trabajo. Los dos checkpoints de difusión son obligatorios: el interruptor elige cuál se ejecuta. Colócalos en los subdirectorios correspondientes de `models/`.
+Descarga los modelos que usa este flujo de trabajo. Los dos checkpoints de diffusion son requeridos: el interruptor selecciona cuál se ejecuta. Colócalos en los subdirectorios correspondientes de `models/`.
- trellis_2_int8_convrot.safetensors: modelo de difusión de TRELLIS.2, cargado cuando el interruptor está en `true`
+ trellis_2_int8_convrot.safetensors: modelo de diffusion de TRELLIS.2, se carga cuando el interruptor está en `true`
- pixal3d_int8_convrot.safetensors: modelo de difusión de Pixal3D, cargado de forma predeterminada
+ pixal3d_int8_convrot.safetensors: modelo de diffusion de Pixal3D, se carga por defecto
-
+
trellis_2_shape_vae_bf16.safetensors: VAE para la decodificación de estructura y forma
-
+
trellis_2_texture_vae_bf16.safetensors: VAE para la decodificación de texturas
- dino_v3_L_naf_fp32.safetensors: codificador de visión CLIP para el conditioning de imágenes. El dino_v3_vit_l.safetensors equivalente del repositorio TRELLIS.2 también funciona
+ dino_v3_L_naf_fp32.safetensors: codificador de visión CLIP para el acondicionamiento de imagen. El archivo equivalente dino_v3_vit_l.safetensors del repositorio de TRELLIS.2 también funciona
-
+
birefnet.safetensors: modelo de eliminación de fondo para el preprocesamiento
@@ -107,3 +109,4 @@ Descarga los modelos que usa este flujo de trabajo. Los dos checkpoints de difus
│ └── 📂 background_removal/
│ └── birefnet.safetensors
```
+
diff --git a/es/tutorials/3d/triposplat.mdx b/es/tutorials/3d/triposplat.mdx
index f8f3124ab0..b133ff3c77 100644
--- a/es/tutorials/3d/triposplat.mdx
+++ b/es/tutorials/3d/triposplat.mdx
@@ -2,7 +2,7 @@
title: "TripoSplat en ComfyUI: imagen a Gaussian splat 3D"
description: "Genera representaciones 3D Gaussian splat de alta calidad desde una sola imagen 2D con TripoSplat, con densidad y presupuesto controlables para el renderizado."
sidebarTitle: "TripoSplat"
-translationSourceHash: 453c982d
+translationSourceHash: 12824fc1
translationFrom: tutorials/3d/triposplat.mdx
translationBlockHashes:
"_intro": 09a020f2
@@ -10,8 +10,10 @@ translationBlockHashes:
"Workflow node guide": 83cd15a0
"Steps to run": 3bf53f69
"Output options": 9a1cc408
+ "Model downloads": 33be821b
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
**TripoSplat** es un modelo de código abierto que genera representaciones de **Gaussian splat 3D** directamente a partir de una sola imagen 2D. Fue desarrollado por VAST-AI y publicado bajo una licencia de código abierto.
@@ -50,12 +52,12 @@ Sube este archivo al nodo `LoadImage` correspondiente:
## Cómo funciona
-TripoSplat usa una **arquitectura feed-forward** que toma una sola imagen RGB y predice directamente un conjunto de primitivas Gaussianas 3D. El pipeline implica:
+TripoSplat usa una **arquitectura feed-forward** que toma una única imagen RGB y predice directamente un conjunto de primitivas gaussianas 3D. El pipeline incluye:
1. **Codificación de imagen**: la imagen de entrada se procesa con un codificador visual (DINOv2).
2. **Generación de triplanos**: las características se decodifican en una representación de triplanos.
-3. **Predicción de Gaussianas**: se muestrea el triplano para producir los parámetros de las Gaussianas (posición, escala, rotación, opacidad, color).
-4. **Renderizado**: las Gaussianas se renderizan desde puntos de vista arbitrarios mediante splatting diferenciable.
+3. **Predicción de gaussianas**: se muestrea el triplano para producir los parámetros de las gaussianas (posición, escala, rotación, opacidad, color).
+4. **Renderizado**: las gaussianas se renderizan desde puntos de vista arbitrarios mediante splatting diferenciable.
Este flujo de trabajo usa un nodo Subgraph para el procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y extender el flujo de trabajo.
@@ -69,16 +71,16 @@ TripoSplat usa una **arquitectura feed-forward** que toma una sola imagen RGB y
### TripoSplat (subgrafo)
-El nodo de subgrafo principal procesa la imagen y genera el splat gaussiano 3D. Parámetros expuestos:
+El nodo principal del subgrafo procesa la imagen y genera el splat gaussiano 3D. Parámetros expuestos:
| Parámetro | Predeterminado | Descripción |
|---|---|---|
| `switch` | N/D | Habilita o deshabilita el subgrafo |
-| `num_gaussians` | N/D | Número de primitivas gaussianas a generar (controla calidad/rendimiento) |
-| `seed` | N/D | Semilla aleatoria para reproducibilidad |
+| `num_gaussians` | N/D | Número de primitivas gaussianas a generar (controla la calidad y el rendimiento) |
+| `seed` | N/D | Semilla aleatoria para la reproducibilidad |
| `unet_name` | N/D | Checkpoint del modelo diffusion TripoSplat |
| `clip_name` | N/D | Modelo codificador de visión CLIP |
-| `vae_name` | N/D | VAE para codificar/decodificar (2 entradas: una para el VAE principal y otra para el codificador) |
+| `vae_name` | N/D | VAE para codificar y decodificar (2 entradas: una para el VAE principal y otra para el codificador) |
| `bg_removal_name` | N/D | Modelo de eliminación de fondo |
### CreateCameraInfo
@@ -88,7 +90,7 @@ El nodo de subgrafo principal procesa la imagen y genera el splat gaussiano 3D.
### RenderSplat
- Renderiza el splat gaussiano en una imagen 2D desde el ángulo de cámara definido
-- Parámetros: resolución de salida (predeterminado 1024×1024), configuraciones de calidad de imagen
+- Parámetros: resolución de salida (predeterminada: 1024×1024), configuraciones de calidad de imagen
### SplatToMesh
- Convierte el splat gaussiano en una malla (opcional)
@@ -110,7 +112,7 @@ El nodo de subgrafo principal procesa la imagen y genera el splat gaussiano 3D.
1. **Carga una imagen**: usa el nodo **LoadImage** para cargar una sola imagen 2D
2. **Ejecuta el subgrafo TripoSplat**: el modelo generará una representación Gaussian splat
-3. **Elige el formato de salida**: exporta como GLB, SPZ, video o renderiza a malla
+3. **Elige el formato de salida**: exporta como GLB, SPZ, video o renderiza a una malla
4. **Consulta los resultados**: usa el archivo 3D creado o la vista previa renderizada
## Opciones de salida
@@ -118,28 +120,28 @@ El nodo de subgrafo principal procesa la imagen y genera el splat gaussiano 3D.
| Nodo | Formato | Caso de uso |
|---|---|---|
| **SaveGLB** | `.glb` | Formato de archivo 3D estándar, importable en software 3D |
-| **SplatToFile3D** | `.spz` | Formato comprimido de Gaussian splat para un almacenamiento eficiente |
+| **SplatToFile3D** | `.spz` | Formato comprimido de Gaussian splat para almacenamiento eficiente |
| **RenderSplat** | Imagen 2D | Vista previa rápida del resultado desde cualquier ángulo |
| **SplatToMesh** | Malla | Convierte a una malla tradicional para seguir editando |
-## Descarga de modelos
+## Descargas de modelos
-Descarga el modelo de TripoSplat y los archivos necesarios. Colócalos en los subdirectorios correspondientes de `models/`.
+Descarga el modelo TripoSplat y los archivos requeridos. Colócalos en las subcarpetas correspondientes de `models/`.
- triposplat_fp16.safetensors: checkpoint del modelo de difusión de TripoSplat
+ triposplat_fp16.safetensors: checkpoint del modelo diffusion TripoSplat
-
+
triposplat_vae_decoder_fp16.safetensors: decodificador VAE
-
+
flux2-vae.safetensors: VAE de FLUX.2 para la codificación latente
-
+
dino_v3_vit_h.safetensors: codificador de visión CLIP (DINOv2)
-
+
birefnet.safetensors: modelo de eliminación de fondo para el preprocesamiento
@@ -158,3 +160,4 @@ Descarga el modelo de TripoSplat y los archivos necesarios. Colócalos en los su
│ └── 📂 background_removal/
│ └── birefnet.safetensors
```
+
diff --git a/es/tutorials/controlnet/pose-controlnet-2-pass.mdx b/es/tutorials/controlnet/pose-controlnet-2-pass.mdx
index bec3d42158..a3729380ad 100644
--- a/es/tutorials/controlnet/pose-controlnet-2-pass.mdx
+++ b/es/tutorials/controlnet/pose-controlnet-2-pass.mdx
@@ -2,16 +2,18 @@
title: "Pose ControlNet en ComfyUI: OpenPose y flujos de trabajo de dos pasadas"
description: "Usa esqueletos de OpenPose para controlar la postura del personaje y afina el detalle con un flujo de trabajo de dos pasadas para imágenes grandes."
sidebarTitle: "Pose ControlNet"
-translationSourceHash: 88d83e4a
+translationSourceHash: b939c04c
translationFrom: tutorials/controlnet/pose-controlnet-2-pass.mdx
translationBlockHashes:
"Introduction to OpenPose": 3dd3b023
"ComfyUI 2-Pass Pose ControlNet Usage Example": 89bf8647
+ "Explanation of the Pose ControlNet 2-Pass Workflow": 8396d044
"Advantages of 2-Pass Image Generation": fba5db79
---
+
## Introducción a OpenPose
-[OpenPose](https://github.com/CMU-Perceptual-Computing-Lab/openpose) es un sistema de código abierto para la estimación de pose de varias personas en tiempo real, desarrollado por la Universidad Carnegie Mellon (CMU), que supone un avance significativo en el campo de la visión por computador. El sistema puede detectar simultáneamente a varias personas en una imagen y captura:
+[OpenPose](https://github.com/CMU-Perceptual-Computing-Lab/openpose) es un sistema de código abierto para la estimación de pose de varias personas en tiempo real, desarrollado por la Universidad Carnegie Mellon (CMU), que supone un avance significativo en el campo de la visión por computadora. El sistema puede detectar simultáneamente a varias personas en una imagen y captura:
- **Esqueleto corporal**: 18 puntos clave, incluidos cabeza, hombros, codos, muñecas, caderas, rodillas y tobillos
- **Expresiones faciales**: 70 puntos clave faciales para capturar microexpresiones y contornos faciales
@@ -29,21 +31,21 @@ En particular, con los modelos más antiguos de la serie Stable Diffusion 1.5, l
Descarga la imagen del flujo de trabajo que aparece a continuación y arrástrala a ComfyUI para cargar el flujo de trabajo:
-
+
-Las imágenes que contienen el JSON del flujo de trabajo en sus metadatos se pueden arrastrar directamente a ComfyUI o cargar con el menú `Workflows` -> `Open (ctrl+o)`.
-Esta imagen ya incluye los enlaces de descarga de los modelos correspondientes, y al arrastrarla a ComfyUI se te pedirá automáticamente que descargues los modelos.
+Las imágenes que contienen el JSON del flujo de trabajo en sus metadatos puedes arrastrarlas directamente a ComfyUI o cargarlas con el menú `Workflows` -> `Open (ctrl+o)`.
+Esta imagen ya incluye los enlaces de descarga de los modelos correspondientes; al arrastrarla a ComfyUI, se te pedirá automáticamente que descargues los modelos.
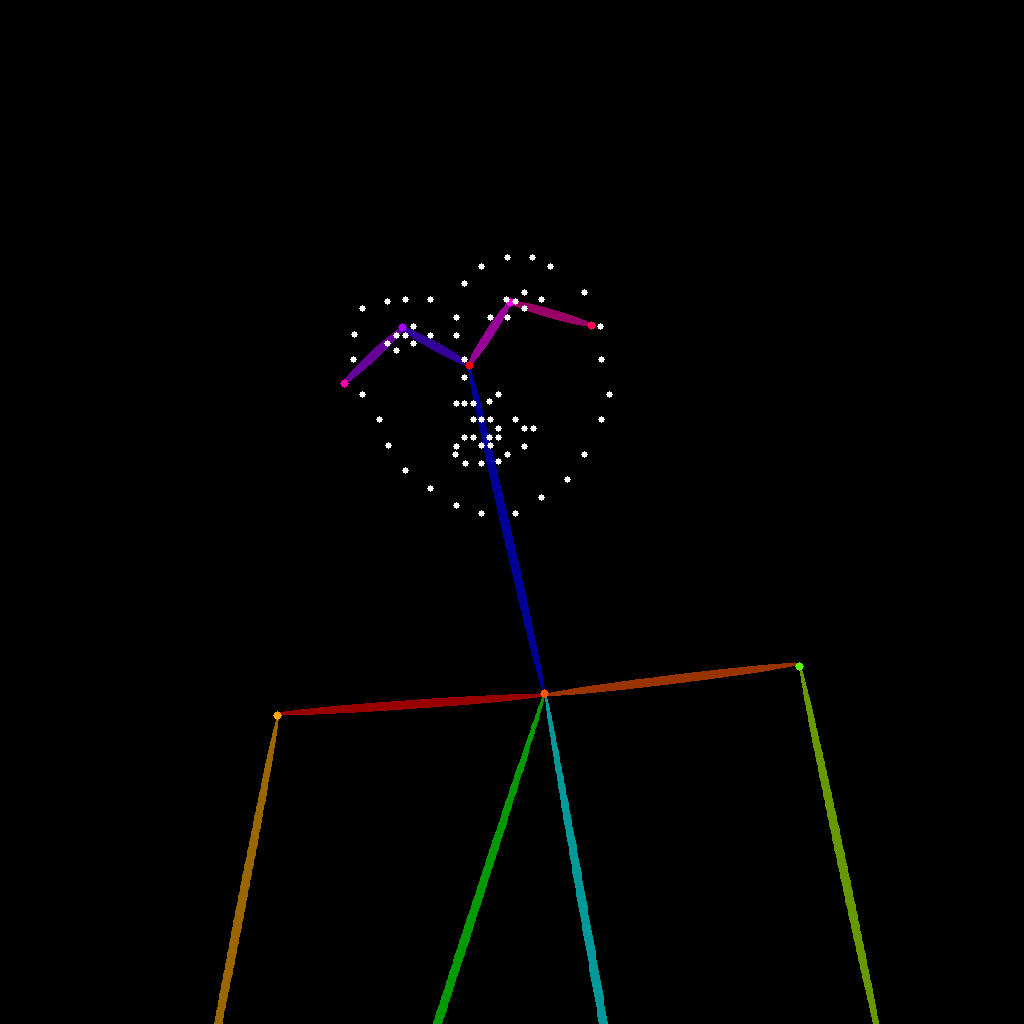
-Descarga la imagen que aparece a continuación, la cual usaremos como entrada:
+Descarga la imagen que aparece a continuación, que usaremos como entrada:
### 2. Instalación manual de los modelos
-Si tu red no puede completar correctamente la descarga automática de los modelos correspondientes, intenta descargar manualmente los modelos que aparecen a continuación y colócalos en los directorios indicados:
+Si tu red no puede completar correctamente la descarga automática de los modelos correspondientes, intenta descargar manualmente los modelos que aparecen a continuación y colócalos en los directorios especificados:
- [control_v11p_sd15_openpose_fp16.safetensors](https://huggingface.co/comfyanonymous/ControlNet-v1-1_fp16_safetensors/blob/main/control_v11p_sd15_openpose_fp16.safetensors?download=true)
@@ -65,22 +67,22 @@ ComfyUI/
### 3. Ejecución del flujo de trabajo paso a paso
-
+
Sigue estos pasos según los marcadores numerados de la imagen:
1. Asegúrate de que `Load Checkpoint` pueda cargar **majicmixRealistic_v7.safetensors**
2. Asegúrate de que `Load VAE` pueda cargar **vae-ft-mse-840000-ema-pruned.safetensors**
3. Asegúrate de que `Load ControlNet Model` pueda cargar **control_v11p_sd15_openpose_fp16.safetensors**
-4. Haz clic en el botón de selección del nodo `Load Image` para subir la imagen de entrada de pose proporcionada anteriormente, o usa tu propio mapa de esqueleto OpenPose
+4. Haz clic en el botón de selección del nodo `Load Image` para subir la imagen de pose de entrada proporcionada anteriormente, o usa tu propio mapa de esqueleto OpenPose
5. Asegúrate de que `Load Checkpoint` pueda cargar **japaneseStyleRealistic_v20.safetensors**
6. Haz clic en el botón `Queue` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de la imagen
-## Explicación del flujo de trabajo Pose ControlNet en dos pasadas
+## Explicación del flujo de trabajo Pose ControlNet de dos pasadas
-Este flujo de trabajo usa un enfoque de generación de imágenes en dos pasadas, que divide el proceso de creación de la imagen en dos fases:
+Este flujo de trabajo utiliza un enfoque de generación de imágenes en dos pasadas, que divide el proceso de creación de la imagen en dos fases:
-### Primera fase: generación de la imagen básica de la pose
+### Primera fase: generación de la imagen de pose básica
En la primera fase, el modelo **majicmixRealistic_v7** se combina con Pose ControlNet para generar una imagen inicial de la pose del personaje:
@@ -90,29 +92,29 @@ En la primera fase, el modelo **majicmixRealistic_v7** se combina con Pose Contr
4. El primer nodo `KSampler` (normalmente con 20-30 pasos) genera una imagen básica de la pose del personaje
5. La imagen en espacio de píxeles de la primera fase se obtiene mediante `VAE Decode`
-Esta fase se centra principalmente en la postura correcta del personaje, la pose y la estructura básica, asegurando que el personaje generado se ajuste a la pose del esqueleto de entrada.
+Esta fase se centra principalmente en la postura, la pose y la estructura básica correctas del personaje, y asegura que el personaje generado se ajuste a la pose del esqueleto de entrada.
-### Segunda fase: optimización del estilo y mejora de detalles
+### Segunda fase: optimización de estilo y mejora de detalles
-En la segunda fase, la imagen de salida de la primera fase se usa como referencia, y el modelo **japaneseStyleRealistic_v20** realiza la estilización y la mejora de detalles:
+En la segunda fase, la imagen de salida de la primera fase sirve como referencia, y el modelo **japaneseStyleRealistic_v20** realiza la estilización y la mejora de detalles:
-1. La imagen generada en la primera fase crea un espacio latent de mayor resolución mediante el nodo `Upscale latent`
+1. La imagen generada en la primera fase crea un espacio latente de mayor resolución mediante el nodo `Upscale latent`
2. El segundo `Load Checkpoint` carga el modelo japaneseStyleRealistic_v20, que se centra en los detalles y el estilo
-3. El segundo nodo `KSampler` usa una fuerza de `denoise` más baja (normalmente 0.4-0.6) para el refinado, conservando la estructura básica de la primera fase
-4. Por último, se obtiene una imagen de mayor calidad y resolución mediante los segundos nodos `VAE Decode` y `Save Image`
+3. El segundo nodo `KSampler` utiliza una intensidad de `denoise` más baja (normalmente 0.4-0.6) para el refinamiento, y conserva la estructura básica de la primera fase
+4. Por último, el segundo `VAE Decode` y los nodos `Save Image` producen una imagen de mayor calidad y resolución
-Esta fase se centra principalmente en la coherencia del estilo, la riqueza de detalles y la mejora de la calidad general de la imagen.
+Esta fase se centra principalmente en la consistencia del estilo, la riqueza de detalles y la mejora de la calidad general de la imagen.
## Ventajas de la generación de imágenes en dos pasadas
En comparación con la generación en una sola pasada, el método de generación de imágenes en dos pasadas ofrece las siguientes ventajas:
-1. **Mayor resolución**: El procesamiento en dos pasadas puede generar imágenes de alta resolución que superan las capacidades de la generación en una sola pasada.
-2. **Mezcla de estilos**: Puede combinar las ventajas de diferentes modelos, como usar un modelo realista en la primera fase y un modelo estilizado en la segunda fase.
-3. **Mejores detalles**: La segunda fase puede centrarse en optimizar los detalles sin tener que preocuparse por la estructura general.
-4. **Control preciso**: Una vez completado el control de pose en la primera fase, la segunda fase puede centrarse en refinar el estilo y los detalles.
-5. **Menor carga de la GPU**: Generar en dos pasadas permite obtener imágenes grandes de alta calidad con recursos limitados de GPU.
+1. **Mayor resolución**: el procesamiento en dos pasadas puede generar imágenes de alta resolución que superan las capacidades de la generación en una sola pasada
+2. **Mezcla de estilos**: puede combinar las ventajas de distintos modelos, por ejemplo, usar un modelo realista en la primera fase y un modelo estilizado en la segunda fase
+3. **Mejores detalles**: la segunda fase puede centrarse en optimizar los detalles sin tener que preocuparse por la estructura general
+4. **Control preciso**: una vez completado el control de pose en la primera fase, la segunda fase puede centrarse en refinar el estilo y los detalles
+5. **Menor carga de GPU**: generar en dos pasadas permite obtener imágenes grandes de alta calidad con recursos de GPU limitados
-Para aprender más sobre las técnicas para mezclar varios ControlNet, consulta el tutorial [Mezclar modelos ControlNet](/es/tutorials/controlnet/mixing-controlnets).
+Aprende más sobre las técnicas para mezclar varios ControlNets en el tutorial [Mezcla de modelos ControlNet](/es/tutorials/controlnet/mixing-controlnets).
diff --git a/es/tutorials/flux/flux-1-fill-dev.mdx b/es/tutorials/flux/flux-1-fill-dev.mdx
index 5a3759d37e..2ff2cbbe24 100644
--- a/es/tutorials/flux/flux-1-fill-dev.mdx
+++ b/es/tutorials/flux/flux-1-fill-dev.mdx
@@ -2,38 +2,40 @@
title: "Ejemplo de ComfyUI Flux.1 fill dev"
description: "Aprende a usar Flux.1 fill dev para crear flujos de trabajo de relleno inteligente y extensión de imagen."
sidebarTitle: "Flux.1 fill dev"
-translationSourceHash: d44cacbe
+translationSourceHash: d4b82038
translationFrom: tutorials/flux/flux-1-fill-dev.mdx
translationBlockHashes:
"_intro": 73fb6ba4
"Introduction to Flux.1 fill dev Model": 6dfbcfd4
+ "Flux.1 Fill dev and related models installation": cf7747cd
"Flux.1 Fill dev inpainting workflow": 016cb519
"Flux.1 Fill dev Outpainting Workflow": b0f0715d
---
+

## Introducción al modelo Flux.1 fill dev
-Flux.1 fill dev es una de las herramientas principales de la [suite FLUX.1 Tools](https://blackforestlabs.ai/flux-1-tools/) lanzada por [Black Forest Labs](https://blackforestlabs.ai/), diseñada específicamente para inpainting y outpainting de imágenes.
+Flux.1 fill dev es una de las herramientas principales de la [suite FLUX.1 Tools](https://blackforestlabs.ai/flux-1-tools/) lanzada por [Black Forest Labs](https://blackforestlabs.ai/), diseñada específicamente para el relleno inteligente y la extensión de imágenes.
Características principales de Flux.1 fill dev:
-- Potentes capacidades de inpainting y outpainting de imágenes, con resultados solo superados por la versión comercial FLUX.1 Fill [pro].
+- Potentes capacidades de relleno inteligente y extensión de imágenes, con resultados solo superados por la versión comercial FLUX.1 Fill [pro].
- Excelente capacidad para comprender y seguir el prompt, capturando con precisión la intención del usuario y manteniendo una alta consistencia con la imagen original.
-- Tecnología avanzada de entrenamiento con destilación guiada, que hace el modelo más eficiente sin dejar de producir salidas de alta calidad.
-- Términos de licencia flexibles: las salidas generadas se pueden usar para uso personal, científico y comercial. Consulta la [licencia no comercial de FLUX.1 [dev]](https://huggingface.co/black-forest-labs/FLUX.1-dev/blob/main/LICENSE.md) para más detalles.
+- Tecnología avanzada de entrenamiento con destilación guiada, que hace que el modelo sea más eficiente sin dejar de producir salidas de alta calidad.
+- Términos de licencia flexibles: las salidas generadas pueden usarse para fines personales, científicos y comerciales. Consulta la [licencia no comercial de FLUX.1 [dev]](https://huggingface.co/black-forest-labs/FLUX.1-dev/blob/main/LICENSE.md) para más detalles.
Repositorio de código abierto: [FLUX.1 [dev]](https://huggingface.co/black-forest-labs/FLUX.1-dev)
-Esta guía mostrará flujos de trabajo de inpainting y outpainting basados en el modelo Flux.1 fill dev.
-Si no estás familiarizado con los flujos de trabajo de inpainting y outpainting, puedes consultar el [ejemplo de inpainting de ComfyUI Layout](/es/tutorials/basic/inpaint) y el [ejemplo de extensión de imagen de ComfyUI](/es/tutorials/basic/outpaint) para ver explicaciones relacionadas.
+Esta guía mostrará flujos de trabajo de relleno inteligente y extensión de imágenes basados en el modelo Flux.1 fill dev.
+Si no estás familiarizado con los flujos de trabajo de relleno inteligente y extensión de imágenes, puedes consultar el [ejemplo de relleno inteligente de ComfyUI Layout](/es/tutorials/basic/inpaint) y el [ejemplo de extensión de imagen de ComfyUI](/es/tutorials/basic/outpaint) para ver explicaciones relacionadas.
-## Instalación de Flux.1 Fill dev y de los modelos relacionados
+## Instalación de Flux.1 Fill dev y modelos relacionados
-Antes de empezar, completemos la instalación de los archivos del modelo Flux.1 Fill dev. Los flujos de trabajo de inpainting y outpainting que vienen a continuación usan exactamente los mismos archivos de modelo.
-Si ya has usado antes la versión completa del [flujo de trabajo de texto a imagen de Flux.1](/es/tutorials/flux/flux-1-text-to-image),
-en esta sección solo necesitas descargar el archivo de modelo **flux1-fill-dev.safetensors**.
+Antes de empezar, completemos la instalación de los archivos del modelo Flux.1 Fill dev. Los flujos de trabajo de Relleno inteligente y extensión de imagen usarán exactamente los mismos archivos de modelo.
+Si ya has usado antes la versión completa del [flujo de trabajo Flux.1 de texto a imagen](/es/tutorials/flux/flux-1-text-to-image),
+solo necesitas descargar el archivo de modelo **flux1-fill-dev.safetensors** en esta sección.
-Sin embargo, como la descarga del modelo correspondiente exige aceptar antes el acuerdo de uso, visita la página [black-forest-labs/FLUX.1-Fill-dev](https://huggingface.co/black-forest-labs/FLUX.1-Fill-dev) y asegúrate de haber aceptado el acuerdo correspondiente, como se muestra en la imagen de abajo.
+Sin embargo, como la descarga del modelo correspondiente requiere aceptar el acuerdo de uso correspondiente, visita la página [black-forest-labs/FLUX.1-Fill-dev](https://huggingface.co/black-forest-labs/FLUX.1-Fill-dev) y asegúrate de haber aceptado el acuerdo correspondiente, como se muestra en la imagen siguiente.

Lista completa de modelos:
@@ -57,18 +59,18 @@ ComfyUI/
## Flujo de trabajo de relleno inteligente con Flux.1 Fill dev
-### Flux.1 Inpaint {#flux_fill_inpaint_example}
+### Relleno inteligente con Flux.1 {#flux_fill_inpaint_example}
-Rellena las partes faltantes de las imágenes con Flux.1 Fill Inpainting.
+Rellena las partes faltantes de las imágenes con el relleno inteligente de Flux.1 Fill.
-
+
Abrir en Comfy Cloud
- Descarga el JSON o busca "Flux.1 Inpaint" en la biblioteca de plantillas
+ Descarga el JSON o busca "Flux.1 Inpaint" en la Biblioteca de plantillas
@@ -78,7 +80,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
- `LoadImage`, nodo 17 · `flux_fill_inpaint_example_input_image.png`
+ Nodo `LoadImage` 17 · `flux_fill_inpaint_example_input_image.png`
@@ -90,14 +92,14 @@ Sube este archivo al nodo `LoadImage` correspondiente:
-
+
### 1. Flujo de trabajo de relleno inteligente y recursos
-La imagen correspondiente ya contiene un canal alpha, así que no necesitas dibujar una máscara por separado.
-Si quieres dibujar tu propia máscara, [haz clic aquí](https://raw.githubusercontent.com/Comfy-Org/example_workflows/main/flux/inpaint/flux_fill_inpaint_input_original.png) para obtener la imagen sin máscara y consulta la sección de uso de MaskEditor en el [Ejemplo de relleno inteligente de diseño de ComfyUI](/es/tutorials/basic/inpaint#usar-el-editor-de-máscara) para aprender a dibujar una máscara en el nodo `Load Image`.
+La imagen correspondiente ya incluye un canal alfa, así que no necesitas dibujar una máscara por separado.
+Si quieres dibujar tu propia máscara, [haz clic aquí](https://raw.githubusercontent.com/Comfy-Org/example_workflows/main/flux/inpaint/flux_fill_inpaint_input_original.png) para obtener la imagen sin máscara, y consulta la sección de uso del Editor de máscara en el [ejemplo de relleno inteligente de diseño de ComfyUI](/es/tutorials/basic/inpaint#usar-el-editor-de-máscara) para aprender a dibujar una máscara en el nodo `Load Image`.
### 2. Pasos para ejecutar el flujo de trabajo
@@ -109,16 +111,16 @@ Si quieres dibujar tu propia máscara, [haz clic aquí](https://raw.githubuserco
- clip_name1: `t5xxl_fp16.safetensors`
- clip_name2: `clip_l.safetensors`
3. Asegúrate de que el nodo `Load VAE` tenga cargado `ae.safetensors`.
-4. Sube la imagen de entrada proporcionada en el documento al nodo `Load Image`; si usas la versión sin máscara, recuerda completar el dibujo de la máscara con el editor de máscara
-5. Haz clic en el botón `Queue` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar el flujo de trabajo
+4. Sube la imagen de entrada que se proporciona en el documento al nodo `Load Image`; si usas la versión sin máscara, recuerda completar el dibujo de la máscara con el Editor de máscara.
+5. Haz clic en el botón `Queue` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar el flujo de trabajo.
## Flujo de trabajo de outpainting con Flux.1 Fill dev
-### Flux.1 Outpaint {#flux_fill_outpaint_example}
+### Outpaint de Flux.1 {#flux_fill_outpaint_example}
-Amplía las imágenes más allá de sus límites con outpainting de Flux.1.
+Extiende las imágenes más allá de sus límites con el outpainting de Flux.1.
-
+
@@ -135,7 +137,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
- Nodo `LoadImage` 17 · `flux_fill_outpaint_example_input_image.png`
+ nodo `LoadImage` 17 · `flux_fill_outpaint_example_input_image.png`
@@ -143,11 +145,11 @@ Sube este archivo al nodo `LoadImage` correspondiente:
-### 1. Flujo de trabajo y recurso de outpainting
+### 1. Flujo de trabajo de outpainting y recursos
### 2. Pasos para ejecutar el flujo de trabajo
-
+
1. Asegúrate de que el nodo `Load Diffusion Model` tenga cargado `flux1-fill-dev.safetensors`.
2. Asegúrate de que el nodo `DualCLIPLoader` tenga cargados los siguientes modelos:
diff --git a/es/tutorials/flux/flux-1-kontext-dev.mdx b/es/tutorials/flux/flux-1-kontext-dev.mdx
index c196d2edc8..d9952f2eaf 100644
--- a/es/tutorials/flux/flux-1-kontext-dev.mdx
+++ b/es/tutorials/flux/flux-1-kontext-dev.mdx
@@ -2,15 +2,17 @@
title: "FLUX.1 Kontext Dev en ComfyUI: edición de imágenes en local"
description: "Edita imágenes en local en ComfyUI con FLUX.1 Kontext Dev, el modelo de 12B de Black Forest Labs para ediciones consistentes, estilo y refinado iterativo."
sidebarTitle: "FLUX.1 Kontext Dev"
-translationSourceHash: 391031ed
+translationSourceHash: 6b87ee9a
translationFrom: tutorials/flux/flux-1-kontext-dev.mdx
translationBlockHashes:
"_intro": 51c48128
"About FLUX.1 Kontext Dev": bb2f00f7
+ "Model Download": e6b40970
"FLUX.1 Kontext Dev Workflow": 8408eb0d
---
+
import PromptTechniques from "/snippets/es/tutorials/flux/prompt-techniques.mdx";
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
## Descarga de modelos
-Para ejecutar correctamente los flujos de trabajo de esta guía, primero necesitas descargar los siguientes archivos de modelo. También puedes obtener directamente los enlaces de descarga de los modelos desde los flujos de trabajo correspondientes, que ya incluyen la información de descarga de los archivos de modelo.
+Para ejecutar los flujos de trabajo de esta guía correctamente, primero necesitas descargar los siguientes archivos de modelo. También puedes obtener directamente los enlaces de descarga de los modelos desde los flujos de trabajo correspondientes, que ya incluyen la información de descarga de los archivos de modelo.
**Modelo de difusión**
- [flux1-dev-kontext_fp8_scaled.safetensors](https://huggingface.co/Comfy-Org/flux1-kontext-dev_ComfyUI/blob/main/split_files/diffusion_models/flux1-dev-kontext_fp8_scaled.safetensors)
-Si quieres usar los pesos originales, puedes visitar el repositorio correspondiente de Black Forest Labs para obtener y usar los pesos originales del modelo.
+Si quieres usar los pesos originales, puedes visitar el repositorio correspondiente de Black Forest Labs para obtener y usar los pesos del modelo original.
**VAE**
@@ -61,7 +63,7 @@ Si quieres usar los pesos originales, puedes visitar el repositorio correspondie
- [clip_l.safetensors](https://huggingface.co/comfyanonymous/flux_text_encoders/blob/main/clip_l.safetensors)
- [t5xxl_fp16.safetensors](https://huggingface.co/comfyanonymous/flux_text_encoders/blob/main/t5xxl_fp16.safetensors) o [t5xxl_fp8_e4m3fn_scaled.safetensors](https://huggingface.co/comfyanonymous/flux_text_encoders/blob/main/t5xxl_fp8_e4m3fn_scaled.safetensors)
-Ubicación de guardado de los archivos
+Ubicación donde guardar los modelos
```
📂 ComfyUI/
@@ -75,20 +77,20 @@ Ubicación de guardado de los archivos
│ └── t5xxl_fp16.safetensors or t5xxl_fp8_e4m3fn_scaled.safetensors
```
-## Flujo de trabajo de FLUX.1 Kontext Dev
+## Flujo de trabajo FLUX.1 Kontext Dev
### Edición de imágenes con FLUX Kontext Dev {#flux_kontext_dev_basic}
-Edición inteligente de imágenes que mantiene la consistencia de los personajes, edita partes específicas sin afectar a las demás y conserva los estilos originales.
+Edición inteligente de imágenes que mantiene la consistencia de los personajes, edita partes concretas sin afectar al resto y conserva los estilos originales.
-
+
Abrir en Comfy Cloud
- Descarga el JSON o busca "FLUX Kontext Dev" en la Biblioteca de plantillas
+ Descarga el JSON o busca "FLUX Kontext Dev" en la biblioteca de plantillas
@@ -106,16 +108,16 @@ Sube este archivo al nodo `LoadImage` correspondiente:
-**Salida de ejemplo**
+**Ejemplo de salida**
-
+
-Este flujo de trabajo usa el nodo `Load Image(from output)` para cargar la imagen que se va a editar, lo que hace más cómodo acceder a la imagen editada para varias rondas de edición.
+Este flujo de trabajo usa el nodo `Load Image(from output)` para cargar la imagen que se va a editar, lo que te facilita el acceso a la imagen editada para hacer varias rondas de edición.
-### 1. Descargar el flujo de trabajo y la imagen de entrada
+### 1. Descarga del flujo de trabajo y de la imagen de entrada
### 2. Completar el flujo de trabajo paso a paso
@@ -123,10 +125,10 @@ Este flujo de trabajo usa el nodo `Load Image(from output)` para cargar la image
Puedes guiarte por los números de la imagen para completar la ejecución del flujo de trabajo:
1. En el nodo `Load Diffusion Model`, carga el modelo `flux1-dev-kontext_fp8_scaled.safetensors`
-2. En el nodo `DualCLIP Load`, asegúrate de que estén cargados `clip_l.safetensors` y `t5xxl_fp16.safetensors` o `t5xxl_fp8_e4m3fn_scaled.safetensors`
+2. En el nodo `DualCLIP Load`, asegúrate de que `clip_l.safetensors` y `t5xxl_fp16.safetensors` o `t5xxl_fp8_e4m3fn_scaled.safetensors` estén cargados
3. En el nodo `Load VAE`, asegúrate de que el modelo `ae.safetensors` esté cargado
4. En el nodo `Load Image(from output)`, carga la imagen de entrada proporcionada
-5. En el nodo `CLIP Text Encode`, modifica los prompts; solo se admite inglés
+5. En el nodo `CLIP Text Encode`, modifica los prompts; solo admite inglés
6. Haz clic en el botón `Queue` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar el flujo de trabajo
diff --git a/es/tutorials/flux/flux-1-uso.mdx b/es/tutorials/flux/flux-1-uso.mdx
index 576d0cb3a3..5596d8079f 100644
--- a/es/tutorials/flux/flux-1-uso.mdx
+++ b/es/tutorials/flux/flux-1-uso.mdx
@@ -2,7 +2,7 @@
title: "ByteDance USO en ComfyUI: flujos de referencia de estilo y sujeto"
description: "Ejecuta ByteDance USO sobre FLUX.1-dev en ComfyUI para mantener la identidad de un sujeto, transferir un estilo de referencia o combinar ambos."
sidebarTitle: "ByteDance USO"
-translationSourceHash: 5b3c5241
+translationSourceHash: 970fff4a
translationFrom: tutorials/flux/flux-1-uso.mdx
---
diff --git a/es/tutorials/flux/flux-2-dev.mdx b/es/tutorials/flux/flux-2-dev.mdx
index 0357786e12..641e0e3144 100644
--- a/es/tutorials/flux/flux-2-dev.mdx
+++ b/es/tutorials/flux/flux-2-dev.mdx
@@ -2,7 +2,7 @@
title: "FLUX.2 Dev en ComfyUI: texto a imagen y mockups de producto"
description: "Ejecuta FLUX.2 Dev en ComfyUI para imágenes fotorrealistas de hasta 4MP con consistencia multi-referencia, texto legible y mockups de producto."
sidebarTitle: "FLUX.2 Dev"
-translationSourceHash: 8f6f929f
+translationSourceHash: 01c36006
translationFrom: tutorials/flux/flux-2-dev.mdx
translationBlockHashes:
"_intro": 8984dcfe
@@ -10,24 +10,26 @@ translationBlockHashes:
"FLUX.2 Dev {#image_flux2}": 5f8125f4
"FLUX.2 Dev Text to Image {#image_flux2_text_to_image}": 66689484
"Product Mockup {#image_flux2_fp8}": d778674f
+ "Model links": 32c8e0cb
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
## Acerca de FLUX.2
-[FLUX.2](https://bfl.ai/blog/flux-2) es un modelo de imágenes de nueva generación de [Black Forest Labs](https://blackforestlabs.ai/), que ofrece resultados fotorrealistas de hasta 4MP con una mejora considerable en iluminación, piel, telas y detalle de las manos. Añade una consistencia fiable con múltiples referencias (hasta 10 imágenes), una precisión de edición mejorada, una mejor comprensión visual y un renderizado de texto de nivel profesional.
+[FLUX.2](https://bfl.ai/blog/flux-2) es un modelo de imágenes de nueva generación de [Black Forest Labs](https://blackforestlabs.ai/) que ofrece resultados fotorrealistas de hasta 4MP con una mejora considerable en iluminación, piel, telas y detalle de las manos. Añade una consistencia fiable con múltiples referencias (hasta 10 imágenes), mayor precisión de edición, una mejor comprensión visual y un renderizado de texto de nivel profesional.
**Características principales:**
- **Consistencia con múltiples referencias:** Mantiene de forma fiable la identidad, la geometría del producto, las texturas, los materiales, el vestuario y la intención de composición en múltiples salidas
-- **Fotorrealismo de alta resolución:** Genera imágenes de hasta 4MP con un comportamiento realista de la iluminación, razonamiento espacial y detalles que tienen en cuenta la física
+- **Fotorrealismo de alta resolución:** Genera imágenes de hasta 4MP con un comportamiento de iluminación realista, razonamiento espacial y detalles que tienen en cuenta la física
- **Control de nivel profesional:** Control exacto de la pose, colores de marca precisos según el código hex, cualquier relación de aspecto y prompts estructurados para flujos de trabajo programáticos
- **Renderizado de texto utilizable:** Produce texto limpio y legible en pantallas de interfaz, infografías y contenido en varios idiomas
**Modelos disponibles:**
-- **FLUX.2 Dev:** Modelo de código abierto (utilizado en este tutorial)
-- **FLUX.2 Pro:** Versión API de Black Forest Labs
+- **FLUX.2 Dev:** Modelo de código abierto (el que se usa en este tutorial)
+- **FLUX.2 Pro:** Versión de API de Black Forest Labs
En este flujo de trabajo usamos pesos cuantizados. El repositorio original de FLUX.2 está disponible [aquí](https://huggingface.co/black-forest-labs/FLUX.2-dev/).
@@ -147,3 +149,4 @@ Sube estos archivos a los nodos `LoadImage` correspondientes:
│ └── 📂 vae/
│ └── flux2-vae.safetensors
```
+
diff --git a/es/tutorials/flux/flux-2-klein.mdx b/es/tutorials/flux/flux-2-klein.mdx
index 09c3acb227..ab6efae55e 100644
--- a/es/tutorials/flux/flux-2-klein.mdx
+++ b/es/tutorials/flux/flux-2-klein.mdx
@@ -2,26 +2,29 @@
title: "Guía de ComfyUI FLUX.2 Klein 4B"
description: "Introducción rápida a FLUX.2 [klein] 4B y cómo ejecutar flujos de trabajo de texto a imagen y edición de imágenes en ComfyUI."
sidebarTitle: "FLUX.2 Klein"
-translationSourceHash: c108dbe5
+translationSourceHash: 98542515
translationFrom: tutorials/flux/flux-2-klein.mdx
translationBlockHashes:
"_intro": 980a68e5
"About FLUX.2 [klein]": 556eac08
"FLUX.2 Klein 4B Workflows": 8095f2bc
+ "FLUX.2 Klein 4B Model Downloads": f8158c6b
"FLUX.2 Klein 9B Workflows": 99d18075
+ "FLUX.2 Klein 9B Model Downloads": 0407c874
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
## Acerca de FLUX.2 [klein]
-FLUX.2 [Klein] es el modelo más rápido de la familia FLUX: unifica texto a imagen y edición de imágenes en una sola arquitectura compacta. Está diseñado para flujos de trabajo interactivos, vistas previas inmediatas y aplicaciones donde la latencia es crítica, con variantes destiladas que ofrecen una inferencia de extremo a extremo en torno a un segundo y mantienen una gran calidad en la edición con una o varias referencias.
+FLUX.2 [Klein] es el modelo más rápido de la familia FLUX y unifica texto a imagen y edición de imágenes en una sola arquitectura compacta. Está pensado para flujos de trabajo interactivos, vistas previas inmediatas y aplicaciones donde la latencia es crítica, con variantes destiladas que ofrecen una inferencia de extremo a extremo en torno a un segundo y mantienen una gran calidad en la edición con una o varias referencias.
**Aspectos destacados del modelo:**
- Dos tipos de 4B: Base (sin destilar) para máxima flexibilidad y ajuste fino; Distilled (4 pasos) para despliegues que priorizan la velocidad
- Rendimiento: destilado ~1.2s (5090) · 8.4GB VRAM; base ~17s (5090) · 9.2GB VRAM
-- Soporte de edición: transformaciones de estilo, ediciones semánticas, reemplazo y eliminación de objetos, composición con varias referencias, ediciones iterativas
+- Soporte de edición: transformaciones de estilo, ediciones semánticas, reemplazo y eliminación de objetos, composición con varias referencias y ediciones iterativas
@@ -35,7 +38,7 @@ FLUX.2 [Klein] es el modelo más rápido de la familia FLUX: unifica texto a ima
Ejecuta este flujo de trabajo en Comfy Cloud
-
+
Descarga el flujo de trabajo de texto a imagen para FLUX.2 Klein 4B.
@@ -79,16 +82,16 @@ Sube estos archivos a los nodos `LoadImage` correspondientes:
-### FLUX.2 [Klein] 4B destilado: Edición de imagen {#image_flux2_klein_image_edit_4b_distilled}
+### FLUX.2 [Klein] 4B Distilled: Edición de imagen {#image_flux2_klein_image_edit_4b_distilled}
-
+
Ejecuta este flujo de trabajo en Comfy Cloud
-
- Descarga el flujo de trabajo rápido de edición de imagen 4B destilado.
+
+ Descarga el flujo de trabajo rápido y destilado de edición de imagen 4B.
@@ -112,9 +115,9 @@ Sube estos archivos a los nodos `LoadImage` correspondientes:
**Salida de ejemplo**
-
+
-## Descargas de modelos de FLUX.2 Klein 4B
+## Descargas del modelo FLUX.2 Klein 4B
@@ -131,7 +134,7 @@ Sube estos archivos a los nodos `LoadImage` correspondientes:
-**Ubicación de almacenamiento de los modelos 4B**
+**Ubicación de almacenamiento del modelo 4B**
```
📂 ComfyUI/
@@ -149,14 +152,14 @@ Sube estos archivos a los nodos `LoadImage` correspondientes:
### FLUX.2 [Klein] 9B: Texto a imagen {#image_flux2_text_to_image_9b}
-
+
Ejecuta este flujo de trabajo en Comfy Cloud
-
- Descarga el flujo de trabajo texto a imagen de FLUX.2 Klein 9B.
+
+ Descarga el flujo de trabajo de texto a imagen para FLUX.2 Klein 9B.
@@ -172,7 +175,7 @@ Sube estos archivos a los nodos `LoadImage` correspondientes:
Ejecuta este flujo de trabajo en Comfy Cloud
-
+
Descarga el flujo de trabajo de edición de imagen con el modelo base 9B.
@@ -197,7 +200,7 @@ Sube estos archivos a los nodos `LoadImage` correspondientes:
**Salida de ejemplo**
-
+
### FLUX.2 [Klein] 9B destilado: Edición de imagen {#image_flux2_klein_image_edit_9b_distilled}
@@ -207,8 +210,8 @@ Sube estos archivos a los nodos `LoadImage` correspondientes:
Ejecuta este flujo de trabajo en Comfy Cloud
-
- Descarga el flujo de trabajo rápido destilado de edición de imagen 9B.
+
+ Descarga el flujo de trabajo rápido y destilado de edición de imagen 9B.
@@ -232,9 +235,9 @@ Sube estos archivos a los nodos `LoadImage` correspondientes:
**Salida de ejemplo**
-
+
-## Descargas de modelos de FLUX.2 Klein 9B
+## Descargas del modelo FLUX.2 Klein 9B
Para los modelos de difusión, visita el repositorio de BFL, acepta el acuerdo y luego descarga los modelos.
@@ -248,10 +251,10 @@ Para los modelos de difusión, visita el repositorio de BFL, acepta el acuerdo y
Modelo de difusión (9B destilado).
- Codificador de texto para modelos 9B.
+ Codificador de texto para los modelos 9B.
- VAE para modelos 9B.
+ VAE para los modelos 9B.
@@ -268,3 +271,4 @@ Para los modelos de difusión, visita el repositorio de BFL, acepta el acuerdo y
│ └── 📂 vae/
│ └── flux2-vae.safetensors
```
+
diff --git a/es/tutorials/llm/gemma4/gemma4.mdx b/es/tutorials/llm/gemma4/gemma4.mdx
index 5ad1c758e2..94f2d62fd1 100644
--- a/es/tutorials/llm/gemma4/gemma4.mdx
+++ b/es/tutorials/llm/gemma4/gemma4.mdx
@@ -2,17 +2,19 @@
title: "Gemma 4 en ComfyUI: LLM multimodal con TextGenerate"
description: "Ejecuta Gemma 4 de Google en ComfyUI a través del nodo TextGenerate para generación de texto, comprensión de imágenes y transcripción de audio."
sidebarTitle: "Gemma 4"
-translationSourceHash: e876070d
+translationSourceHash: e17f6d7d
translationFrom: tutorials/llm/gemma4/gemma4.mdx
translationBlockHashes:
"_intro": e283d42e
"Available workflow": a5a260f2
+ "Model Download": 8eb8dbb8
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
-**Gemma 4** es la última generación de LLM abiertos y ligeros de Google DeepMind, diseñada para la generación de texto, la comprensión de imágenes, el análisis de video, la transcripción de audio y el uso estructurado de herramientas. Es compatible de forma nativa con ComfyUI como el modelo **Text Generation** predeterminado.
+**Gemma 4** es la última generación de LLM abiertos y ligeros de Google DeepMind, creada para la generación de texto, la comprensión de imágenes, el análisis de video, la transcripción de audio y el uso estructurado de herramientas. ComfyUI lo admite de forma nativa como modelo **Text Generation** predeterminado.
**Aspectos destacados del modelo**:
@@ -21,11 +23,11 @@ import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
- **E2B (2B)**: rápido y ligero, ideal para GPU de consumo
- **E4B (4B)**: rendimiento equilibrado, opción predeterminada recomendada
- **12B**: mejor calidad, requiere más VRAM
-- **Modo de razonamiento**: razonamiento paso a paso integrado antes de generar respuestas
+- **Modo de pensamiento**: razonamiento paso a paso integrado antes de generar las respuestas
- **Contexto largo**: hasta 128K tokens (E2B/E4B) y 256K tokens (12B)
-- **Multilingüe**: más de 35 idiomas listos para usar, preentrenado con más de 140
+- **Multilingüe**: más de 35 idiomas listos para usar, con preentrenamiento en más de 140 idiomas
- **Llamada a funciones**: soporte nativo para el uso estructurado de herramientas y flujos de trabajo agénticos
-- **Nativo en ComfyUI**: se carga y ejecuta mediante los nodos integrados `TextGenerate` y `CLIPLoader`
+- **Nativo en ComfyUI**: ComfyUI lo carga y lo ejecuta a través de los nodos integrados `TextGenerate` y `CLIPLoader`
**Enlaces relacionados**:
- [Hugging Face (Comfy-Org/gemma-4)](https://huggingface.co/Comfy-Org/gemma-4)
@@ -36,7 +38,7 @@ import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
### Gemma4: Text Generation {#llm_gemma4_text_gen}
-Introduce tu prompt de texto y, de forma opcional, una imagen, audio o video. Genera una salida de texto con razonamiento, programación y soporte multilingüe configurables.
+Ingresa tu prompt de texto y, de forma opcional, una imagen, audio o video. Genera una salida de texto con soporte configurable para razonamiento, programación y varios idiomas.
@@ -71,36 +73,36 @@ Este flujo de trabajo demuestra las capacidades principales de **generación de
- **Prompt de texto**: tu pregunta o instrucción
- **Imagen** (opcional): para tareas de comprensión visual (OCR, detección de objetos, lectura de gráficos, etc.)
- **Audio** (opcional): para reconocimiento de voz o transcripción
-- **Video** (opcional): la plantilla carga el video y lo divide con **Get Video Components**, pero esos fotogramas no están conectados al generador de texto, así que el video no afecta a la salida
+- **Video** (opcional): la plantilla carga el video y lo divide con **Obtener componentes de video**, pero esos fotogramas no están conectados al generador de texto, así que el video no afecta la salida
**Controles principales**:
- **Longitud máxima**: número máximo de tokens a generar (256 por defecto)
- **Modo de muestreo**: activa o desactiva el muestreo y ajusta temperatura, top-k, top-p, penalización por repetición y semilla
-- **Modo de razonamiento**: activa el razonamiento paso a paso antes de la respuesta final
+- **Modo de pensamiento**: activa el razonamiento paso a paso antes de la respuesta final
- **Usar plantilla predeterminada**: aplica el prompt de sistema integrado del modelo
**Salida**:
- **Texto generado**: la respuesta del modelo como una cadena de texto sin formato
- Este flujo de trabajo usa nodos Subgraph para un procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y ampliar el flujo de trabajo.
+ Este flujo de trabajo usa nodos Subgraph para un procesamiento modular. Consulta la documentación de Subgraph para saber cómo personalizar y ampliar el flujo de trabajo.
## Descarga del modelo
-Los modelos Gemma 4 se cargan como codificadores de texto en ComfyUI. Descarga el archivo de modelo correspondiente y colócalo en el directorio correcto:
+Los modelos Gemma 4 se cargan como codificadores de texto en ComfyUI. Descarga el archivo del modelo correspondiente y colócalo en el directorio correcto:
- Rápido y ligero. Recomendado para GPU de consumo.
+ Rápido y ligero. Recomendado para GPUs de consumo.
- Rendimiento equilibrado. El modelo predeterminado del flujo de trabajo.
+ Rendimiento equilibrado. El modelo predeterminado en el flujo de trabajo.
- Explora todos los pesos de los modelos Gemma 4.
+ Explora todos los pesos del modelo Gemma 4.
@@ -112,3 +114,4 @@ Coloca el archivo `.safetensors` descargado en:
│ └── 📂 text_encoders/
│ └── gemma4_e4b_it_fp8_scaled.safetensors
```
+
diff --git a/es/tutorials/llm/qwen/qwen3.mdx b/es/tutorials/llm/qwen/qwen3.mdx
index b4073fd05c..48e39bf8a9 100644
--- a/es/tutorials/llm/qwen/qwen3.mdx
+++ b/es/tutorials/llm/qwen/qwen3.mdx
@@ -2,34 +2,36 @@
title: "Qwen 3.0 en ComfyUI: generación de texto LLM con TextGenerate"
description: "Ejecuta Qwen3 4B Thinking en ComfyUI con TextGenerate para reescritura de prompts, razonamiento con cadena de pensamiento y análisis de texto estructurado."
sidebarTitle: "Qwen 3.0"
-translationSourceHash: c9e91599
+translationSourceHash: 062180fe
translationFrom: tutorials/llm/qwen/qwen3.mdx
translationBlockHashes:
"_intro": 75e813fe
"Use Cases": 72228b63
"Available workflow": 93a0c3e5
+ "Model Download": 6a95f95c
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
-**Qwen 3.0** (también conocido como Qwen3) es un potente LLM de código abierto de Alibaba Cloud diseñado para la generación de texto, el razonamiento y el análisis estructurado. Es compatible de forma nativa con ComfyUI mediante el nodo integrado `TextGenerate`.
+**Qwen 3.0** (también conocido como Qwen3) es un potente LLM de código abierto de Alibaba Cloud creado para la generación de texto, el razonamiento y el análisis estructurado. ComfyUI lo admite de forma nativa mediante el nodo integrado `TextGenerate`.
**Aspectos destacados del modelo**:
- **Razonamiento sólido**: Qwen3-4B-Thinking admite razonamiento paso a paso con cadena de pensamiento
- **Enfocado en la generación de texto**: optimizado para la salida de texto estructurado, el análisis y las tareas de programación
-- **Nativo en ComfyUI**: funciona con el nodo integrado `TextGenerate`, sin necesidad de Nodos personalizados
-- **Ligero**: comparte el mismo formato de codificador de texto que Qwen3.5, disponible en variantes de 2B, 4B y 9B para ajustarse a diferentes configuraciones de hardware
+- **Nativo en ComfyUI**: funciona con el nodo integrado `TextGenerate`, sin necesidad de nodos personalizados
+- **Ligero**: comparte el mismo formato de codificador de texto que Qwen3.5 y está disponible en variantes de 2B, 4B y 9B para ajustarse a distintas configuraciones de hardware
## Casos de uso
-Qwen 3.0 es adecuado para tareas que requieren generación de texto estructurado y razonamiento inteligente dentro de un flujo de trabajo de ComfyUI:
+Qwen 3.0 es ideal para tareas que requieren generación de texto estructurado y razonamiento inteligente dentro de un flujo de trabajo de ComfyUI:
- **Optimización de prompts**: pasa prompts existentes a Qwen 3.0 y pídele que los reescriba, los expanda o los refine para obtener mejores resultados de generación de imágenes. Por ejemplo, convierte un prompt corto de palabras clave en descripciones detalladas y estructuradas con detalles de estilo, iluminación y composición.
- **Razonamiento sobre la lógica del flujo de trabajo**: usa el modelo para analizar los parámetros del flujo de trabajo, sugerir pasos de procesamiento o generar instrucciones estructuradas que alimenten otros nodos.
- **Análisis basado en texto**: extrae información, clasifica contenido o genera informes estructurados a partir de entradas de texto.
-- **Razonamiento de cadena de pensamiento**: activa el modo de pensamiento para tareas complejas de varios pasos que se benefician de un razonamiento intermedio antes de producir la salida final.
+- **Razonamiento en cadena de pensamiento**: activa el modo de pensamiento para tareas complejas de varios pasos que se benefician de un razonamiento intermedio antes de producir la salida final.
## Flujo de trabajo disponible
@@ -56,19 +58,19 @@ Este flujo de trabajo demuestra las capacidades fundamentales de **generación d
**Controles principales**:
- **Longitud máxima**: número máximo de tokens a generar (predeterminado 256)
- **Modo de muestreo**: activa o desactiva el muestreo y ajusta la temperatura, top-k, top-p, la penalización por repetición y la semilla
-- **Modo de razonamiento**: habilita el razonamiento paso a paso antes de la respuesta final
+- **Modo de pensamiento**: habilita el razonamiento paso a paso antes de la respuesta final
- **Usar plantilla predeterminada**: aplica el prompt de sistema integrado del modelo
**Salida**:
- **Texto generado**: la respuesta del modelo como una cadena de texto simple
-
+
Este flujo de trabajo usa nodos Subgraph para el procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y extender el flujo de trabajo.
## Descarga del modelo
-Los modelos Qwen 3.0 se cargan como codificadores de texto en ComfyUI. Los archivos de modelo se comparten con Qwen3.5. Descarga la variante que mejor se adapte a tu hardware:
+Los modelos Qwen 3.0 se cargan como text encoders en ComfyUI. Los archivos del modelo son compartidos con Qwen3.5. Descarga la variante que mejor se adapte a tu hardware:
@@ -76,11 +78,11 @@ Los modelos Qwen 3.0 se cargan como codificadores de texto en ComfyUI. Los archi
- Equilibrio entre tamaño y calidad. Recomendado para la mayoría de GPU de consumo.
+ Tamaño y calidad equilibrados. RECOMENDADO para la mayoría de las GPU de consumo.
- La variante más grande, ~19 GB. Salida de mayor calidad, requiere más VRAM.
+ La variante más grande, ~19 GB. Mayor calidad de salida, requiere más VRAM.
@@ -92,3 +94,4 @@ Coloca el archivo `.safetensors` descargado en:
│ └── 📂 text_encoders/
│ └── qwen3.5_4b_bf16.safetensors # or 2b / 9b variant
```
+
diff --git a/es/tutorials/llm/qwen/qwen3_5.mdx b/es/tutorials/llm/qwen/qwen3_5.mdx
index 4818144e0a..2800da3920 100644
--- a/es/tutorials/llm/qwen/qwen3_5.mdx
+++ b/es/tutorials/llm/qwen/qwen3_5.mdx
@@ -2,44 +2,46 @@
title: "Qwen3.5 en ComfyUI: LLM multimodal para descripción de imágenes"
description: "Ejecuta Qwen3.5, el LLM multimodal de Alibaba Cloud, en ComfyUI con el nodo TextGenerate para descripción de imágenes, prompts inversos y preguntas visuales."
sidebarTitle: "Qwen3.5"
-translationSourceHash: f25a584f
+translationSourceHash: 37805a0b
translationFrom: tutorials/llm/qwen/qwen3_5.mdx
translationBlockHashes:
"_intro": cc4cef60
"Use Cases": 01910a1e
"Available workflow": 767cf795
+ "Model Download": 835bbbd0
---
+
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-**Qwen3.5** es un LLM multimodal de código abierto de Alibaba Cloud, que se basa en la serie Qwen 3.0 y añade capacidades de comprensión de imágenes. Admite tanto la generación de texto como tareas basadas en imágenes, como el etiquetado de imágenes y la ingeniería inversa de prompts.
+**Qwen3.5** es un LLM multimodal de código abierto de Alibaba Cloud, que se basa en la serie Qwen 3.0 y añade capacidades de comprensión de imágenes. Admite tanto la generación de texto como tareas basadas en imágenes, como la descripción de imágenes y la ingeniería inversa de prompts.
**Aspectos destacados del modelo**:
- **Multimodal**: acepta entradas de texto e imagen para tareas de comprensión visual
-- **Etiquetado de imágenes**: puede describir imágenes y generar leyendas detalladas
+- **Descripción de imágenes**: puede describir imágenes y generar descripciones detalladas
- **Ingeniería inversa de prompts**: extrae prompts y parámetros de generación a partir de imágenes de referencia
-- **Nativo en ComfyUI**: funciona con el nodo integrado `TextGenerate`, sin necesidad de Nodos personalizados
-- **Ligero**: modelo de 4B parámetros, apto para GPUs de consumo
+- **Nativo en ComfyUI**: funciona con el nodo integrado `TextGenerate`, sin necesidad de nodos personalizados
+- **Ligero**: modelo de 4B de parámetros, adecuado para GPUs de consumo
## Casos de uso
Qwen3.5 destaca en escenarios donde combinar la comprensión visual con la generación de texto aporta valor a un flujo de trabajo de ComfyUI:
- **Ingeniería inversa de prompts a partir de una imagen**: dale una imagen de referencia a Qwen3.5 y pídele que genere un prompt de texto detallado que pueda reproducir esa imagen. Resulta especialmente útil cuando encuentras una gran imagen pero no sabes con qué prompt se generó.
-- **Optimización de prompts**: carga un prompt existente y un concepto de imagen, y luego pide a Qwen3.5 que genere, refine o expanda prompts con más detalle para obtener mejores resultados de generación.
+- **Optimización de prompts**: carga un prompt existente y un concepto de imagen, y luego pide a Qwen3.5 que genere, refine o expanda prompts con mayor detalle para obtener mejores resultados de generación.
- **Generación de descripciones de imágenes**: genera automáticamente leyendas, descripciones o etiquetas de metadatos para las imágenes generadas, lo que resulta útil para catalogar o preparar datos de entrenamiento.
- **Respuesta a preguntas sobre imágenes**: haz preguntas acerca del contenido de la imagen ("¿Qué objetos hay en esta escena?", "¿De qué color es el fondo?") y obtén respuestas de texto estructuradas.
-- **Lectura de texto**: con un prompt adecuado, el modelo puede intentar leer el texto visible o las etiquetas de las imágenes, aunque la fiabilidad depende de la calidad y la claridad del texto representado.
+- **Lectura de texto**: con un prompt adecuado, el modelo puede intentar leer el texto visible o las etiquetas de las imágenes, aunque la fiabilidad depende de la calidad y la claridad del texto renderizado.
## Flujo de trabajo disponible
### Qwen3.5: Text Generation {#llm_qwen3_5_text_gen}
-Usa el modelo Qwen3.5 para analizar una imagen de entrada y generar prompts descriptivos de texto. Este flujo de trabajo realiza captioning de imágenes e ingeniería inversa de prompts.
+Usa el modelo Qwen3.5 para analizar una imagen de entrada y generar prompts descriptivos de texto. Este flujo de trabajo realiza descripción de imágenes e ingeniería inversa de prompts.
-
+
@@ -61,30 +63,30 @@ Sube este archivo al nodo `LoadImage` correspondiente:
-
+
Este flujo de trabajo demuestra las capacidades de **generación de texto y comprensión de imágenes** de Qwen3.5. Acepta un prompt de texto y una imagen opcional, y genera texto descriptivo o análisis estructurado a partir de la entrada.
**Entradas**:
- **Prompt de texto**: tu pregunta, instrucción o descripción de la tarea
-- **Imagen** (opcional): para tareas de comprensión visual (captioning de imágenes, ingeniería inversa de prompts, optimización de prompts, etc.)
+- **Imagen** (opcional): para tareas de comprensión visual (descripción de imágenes, ingeniería inversa de prompts, optimización de prompts, etc.)
**Controles clave**:
- **Max length**: número máximo de tokens a generar (256 por defecto)
-- **Sampling mode**: activa o desactiva el muestreo y ajusta temperature, top-k, top-p, repetition penalty y seed
-- **Use default template**: aplica el system prompt integrado del modelo
+- **Sampling mode**: activa o desactiva el muestreo y ajusta temperature, top-k, top-p, repetition penalty y semilla
+- **Use default template**: aplica el prompt de sistema integrado del modelo
**Salida**:
- **Texto generado**: la respuesta del modelo como una cadena de texto plano
-
- Este flujo de trabajo usa nodos Subgraph para un procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y ampliar el flujo de trabajo.
+
+ Este flujo de trabajo usa nodos Subgraph para un procesamiento modular. Consulta la documentación de Subgraph para saber cómo personalizar y ampliar el flujo de trabajo.
## Descarga del modelo
-Los modelos Qwen3.5 se cargan como codificadores de texto en ComfyUI. Elige la variante que mejor se adapte a tu hardware:
+Los modelos Qwen3.5 se cargan como text encoders en ComfyUI. Elige la variante que mejor se adapte a tu hardware:
@@ -92,11 +94,11 @@ Los modelos Qwen3.5 se cargan como codificadores de texto en ComfyUI. Elige la v
- Equilibrio entre tamaño y calidad. Recomendado para la mayoría de GPU de consumo.
+ Tamaño y calidad equilibrados. RECOMENDADO para la mayoría de las GPU de consumo.
- La variante más grande, ~19 GB. Salida de mayor calidad, requiere más VRAM.
+ La variante más grande, ~19 GB. Mayor calidad de salida, requiere más VRAM.
@@ -108,3 +110,4 @@ Coloca el archivo `.safetensors` descargado en:
│ └── 📂 text_encoders/
│ └── qwen3.5_4b_bf16.safetensors # or 2b / 9b variant
```
+
diff --git a/es/tutorials/partner-nodes/fishaudio/drama-3.mdx b/es/tutorials/partner-nodes/fishaudio/drama-3.mdx
index 2ba7ea514b..dd560fdbfd 100644
--- a/es/tutorials/partner-nodes/fishaudio/drama-3.mdx
+++ b/es/tutorials/partner-nodes/fishaudio/drama-3.mdx
@@ -90,7 +90,7 @@ She looked at the menu and said Je voudrais une table pour deux, s'il vo
### Combinarlas
-Las indicaciones, las etiquetas de palabra y las [etiquetas de fonemas](/es/tutorials/partner-nodes/fishaudio/prompt-guide#phoneme-control) funcionan en el mismo guion, incluso dentro de un turno con varios hablantes:
+Las indicaciones, las etiquetas de palabra y las [etiquetas de fonemas](/es/tutorials/partner-nodes/fishaudio/prompt-guide#control-de-fonemas) funcionan en el mismo guion, incluso dentro de un turno con varios hablantes:
```text
@Voice1 [calm and inviting] Welcome back to the studio.
diff --git a/es/tutorials/partner-nodes/fishaudio/fish-audio.mdx b/es/tutorials/partner-nodes/fishaudio/fish-audio.mdx
index 7572d8a262..032a93e55f 100644
--- a/es/tutorials/partner-nodes/fishaudio/fish-audio.mdx
+++ b/es/tutorials/partner-nodes/fishaudio/fish-audio.mdx
@@ -38,7 +38,7 @@ La documentación del modelo más reciente, `drama-3`, está en su propia págin
### Conectar voces
-La salida `voice` del Voice Selector o del Instant Voice Clone se conecta al nodo Text to Speech. El nombre de la entrada depende del modelo: `s2.1-pro` (recomendado) expone la entrada `voices`, que puede crecer (hasta 5 espacios de voz), mientras que `s1` tiene una única entrada `voice` opcional. Con una voz conectada, el nodo la pasa internamente como `reference_id`. Con dos o más, el texto debe marcar a los hablantes con `@Voice1`, `@Voice2`, etc., y cada voz conectada debe aparecer al menos una vez en el texto; de lo contrario, el nodo genera un error. Consulta [Diálogo con varios hablantes](/es/tutorials/partner-nodes/fishaudio/prompt-guide#multi-speaker-dialogue) en la guía de prompts.
+La salida `voice` del Voice Selector o del Instant Voice Clone se conecta al nodo Text to Speech. El nombre de la entrada depende del modelo: `s2.1-pro` (recomendado) expone la entrada `voices`, que puede crecer (hasta 5 espacios de voz), mientras que `s1` tiene una única entrada `voice` opcional. Con una voz conectada, el nodo la pasa internamente como `reference_id`. Con dos o más, el texto debe marcar a los hablantes con `@Voice1`, `@Voice2`, etc., y cada voz conectada debe aparecer al menos una vez en el texto; de lo contrario, el nodo genera un error. Consulta [Diálogo con varios hablantes](/es/tutorials/partner-nodes/fishaudio/prompt-guide#diálogo-con-varios-hablantes) en la guía de prompts.
### Límites de la clonación de voz
diff --git a/es/tutorials/partner-nodes/fishaudio/prompt-guide.mdx b/es/tutorials/partner-nodes/fishaudio/prompt-guide.mdx
index 5941d78bc3..1997ea5cab 100644
--- a/es/tutorials/partner-nodes/fishaudio/prompt-guide.mdx
+++ b/es/tutorials/partner-nodes/fishaudio/prompt-guide.mdx
@@ -2,7 +2,7 @@
title: "Guía de prompts de Fish Audio: cómo escribir prompts para Fish Audio TTS en ComfyUI"
description: "Escribe prompts para los Nodos asociados de Fish Audio en ComfyUI: etiquetas de emoción, tono, efectos de audio, pausas y diálogos."
sidebarTitle: "Guía de prompts"
-translationSourceHash: 15c1b378
+translationSourceHash: f37ebbfa
translationFrom: tutorials/partner-nodes/fishaudio/prompt-guide.mdx
translationBlockHashes:
"_intro": 92787dbd
@@ -11,12 +11,16 @@ translationBlockHashes:
"Tone markers": aca7ba72
"Audio effects": aadc74bb
"Pauses and special effects": 7d87b14e
+ "Combining tags": 0c4cf8d1
"Best practices": f4c22fed
+ "Multi-speaker dialogue": a86dc954
+ "Phoneme control": 72653bf7
"Parameter tuning": c53e91bf
"Voice cloning quality": 7e721eb5
"References": c8122f0c
---
-Fish Audio TTS te da control directo sobre cómo suena el habla mediante etiquetas en línea escritas en el propio texto. Esta guía cubre todas las categorías de etiquetas que entiende el modelo, dónde colocarlas y cómo combinarlas. Las etiquetas siguientes se aplican a `s2.1-pro` y `s1`. Drama 3 usa instrucciones en lenguaje natural y etiquetas de palabras emparejadas en su lugar, descritas en la página [Fish Audio Drama 3](/es/tutorials/partner-nodes/fishaudio/drama-3).
+
+Fish Audio TTS te da control directo sobre cómo suena el habla mediante etiquetas en línea escritas en el propio texto. Esta guía cubre todas las categorías de etiquetas que entiende el modelo, dónde colocarlas y cómo combinarlas. Las etiquetas siguientes se aplican a `s2.1-pro` y `s1`. En cambio, Drama 3 usa instrucciones en lenguaje natural y etiquetas de palabras emparejadas, descritas en la página [Fish Audio Drama 3](/es/tutorials/partner-nodes/fishaudio/drama-3).
Los ejemplos siguientes funcionan en el nodo Fish Audio Text to Speech. Escríbelos directamente en el campo `text`, reemplazando el guion de ejemplo por el tuyo. Para configurar el nodo, las plantillas de flujo de trabajo y los precios, consulta [Fish Audio: Texto a voz, clonación de voz y voz a texto](/es/tutorials/partner-nodes/fishaudio/fish-audio).
@@ -32,11 +36,11 @@ Los modelos Fish Audio S2 interpretan indicaciones en lenguaje natural escritas
Tres propiedades hacen que este sistema sea flexible:
-- **La posición determina el significado.** Una etiqueta actúa desde donde aparece hasta la siguiente etiqueta o el final de la oración. `[whispering] I didn't want to go inside` susurra toda la línea. `I didn't want to go [whispering] inside` empieza a susurrar en «inside».
-- **Las descripciones de forma libre funcionan.** No estás limitado a un conjunto fijo de etiquetas. Si puedes describírselo a un actor de voz, escríbelo entre corchetes: `[tired, end of a long shift]`, `[voice rough from crying, trying to sound normal]`, `[professional broadcast tone]`.
+- **La posición determina el significado.** Una etiqueta se aplica desde donde aparece hasta la siguiente etiqueta o el final de la oración. `[whispering] I didn't want to go inside` susurra toda la línea. `I didn't want to go [whispering] inside` empieza a susurrar en «inside».
+- **Las descripciones libres funcionan.** No estás limitado a un conjunto fijo de etiquetas. Si puedes describírselo a un actor de voz, escríbelo entre corchetes: `[tired, end of a long shift]`, `[voice rough from crying, trying to sound normal]`, `[professional broadcast tone]`.
- **Las etiquetas funcionan en tu idioma.** Escribe las indicaciones en el mismo idioma que tu guion: `[低声说] 不要让他们听见`, `[ため息をついて] もう一度やり直そう`.
-El modelo clásico `s1` usa los mismos nombres de emociones, pero los encierra entre paréntesis con un conjunto fijo de etiquetas: `(happy) What a beautiful day!` El modelo actual `s2.1-pro` acepta indicaciones entre corchetes y descripciones de forma libre.
+El modelo clásico `s1` usa los mismos nombres de emociones, pero los encierra entre paréntesis con un conjunto fijo de etiquetas: `(happy) What a beautiful day!` El modelo actual `s2.1-pro` acepta indicaciones entre corchetes y descripciones libres.
## Etiquetas de emoción
@@ -49,7 +53,7 @@ El modelo clásico `s1` usa los mismos nombres de emociones, pero los encierra e
| `[angry]` | Frustrado, agresivo | Quejas, advertencias |
| `[excited]` | Energético, entusiasta | Anuncios, celebraciones |
| `[calm]` | Tranquilo, relajado | Instrucciones, meditación |
-| `[nervous]` | Ansioso, inseguro | Aclaraciones, disculpas |
+| `[nervous]` | Ansioso, inseguro | Descargos de responsabilidad, disculpas |
| `[confident]` | Firme, seguro de sí mismo | Presentaciones, ventas |
| `[surprised]` | Sorprendido, asombrado | Reacciones, descubrimientos |
| `[satisfied]` | Satisfecho, contento | Confirmaciones, reseñas |
@@ -63,7 +67,7 @@ El modelo clásico `s1` usa los mismos nombres de emociones, pero los encierra e
| `[embarrassed]` | Avergonzado, incómodo | Disculpas, errores |
| `[disgusted]` | Repugnado, asqueado | Reseñas negativas |
| `[moved]` | Conmovido emocionalmente | Momentos emotivos |
-| `[proud]` | Realizado, satisfecho | Logros, elogios |
+| `[proud]` | Con sentido de logro, satisfecho | Logros, elogios |
| `[relaxed]` | Relajado, informal | Conversación informal |
| `[grateful]` | Agradecido, reconocido | Agradecimientos, aprecio |
| `[curious]` | Inquisitivo, interesado | Preguntas, exploración |
@@ -94,14 +98,14 @@ El modelo clásico `s1` usa los mismos nombres de emociones, pero los encierra e
| `[lonely]` | Aislado, solo | Contenido emocional |
| `[bored]` | Desinteresado, cansado | Desinterés |
| `[contemptuous]` | Muestra desprecio | Crítica fuerte |
-| `[sympathetic]` | Muestra compasión | Condolencias |
-| `[compassionate]` | Muestra cariño profundo | Soporte, ayuda |
+| `[sympathetic]` | Muestra simpatía | Condolencias |
+| `[compassionate]` | Muestra compasión profunda | Soporte, ayuda |
| `[determined]` | Resuelto, decidido | Objetivos, compromisos |
| `[resigned]` | Acepta la derrota | Rendición, aceptación |
## Marcadores de tono
-Los marcadores de tono controlan el volumen, la intensidad y el énfasis. Coloca `[emphasis]` justo antes de la palabra o frase que quieras enfatizar:
+Los marcadores de tono controlan el volumen, la intensidad y el énfasis. Coloca `[emphasis]` justo antes de la palabra o frase que quieras destacar:
```text
This is [emphasis] really important.
@@ -109,29 +113,29 @@ This is [emphasis] really important.
| Etiqueta | Interpretación | Cuándo usarla |
|-----|----------|-------------|
-| `[in a hurry tone]` | Apresurado, urgente | Información urgente |
-| `[shouting]` | Fuerte, para llamar la atención | Captar la atención |
+| `[in a hurry tone]` | Apresurado, urgente | Información con límite de tiempo |
+| `[shouting]` | Fuerte, alzando la voz | Captar la atención |
| `[screaming]` | Muy fuerte, con pánico | Emergencias, miedo |
-| `[whispering]` | Muy suave, sigiloso | Secretos, escenas tranquilas |
+| `[whispering]` | Muy suave, sigiloso | Secretos, escenas silenciosas |
| `[soft tone]` | Suave, tranquilo | Consuelo, canciones de cuna |
| `[emphasis]` | Enfatizar una palabra o frase | Resaltar palabras clave |
## Efectos de audio
-Las etiquetas de efectos de audio añaden sonidos humanos naturales. A continuación de la etiqueta, incluye el texto correspondiente cuando se sugiera:
+Las etiquetas de efectos de audio agregan sonidos humanos naturales. Después de la etiqueta, incluye el texto correspondiente cuando se sugiera:
| Etiqueta | Descripción | Texto sugerido después de la etiqueta |
|-----|-------------|------------------------------|
-| `[laughing]` | Carcajada | Ha, ha, ha |
-| `[chuckling]` | Risa leve | Heh, heh |
-| `[sobbing]` | Sollozos | Texto opcional |
+| `[laughing]` | Risa a carcajadas | Ha, ha, ha |
+| `[chuckling]` | Risa suave | Heh, heh |
+| `[sobbing]` | Llanto intenso | Texto opcional |
| `[crying loudly]` | Llanto en voz alta | Texto opcional |
| `[sighing]` | Exhalación de alivio o frustración | sigh |
| `[groaning]` | Sonido de frustración | ugh |
| `[panting]` | Sin aliento | huff, puff |
| `[gasping]` | Inhalación brusca | gasp |
| `[yawning]` | Sonido de cansancio | yawn |
-| `[snoring]` | Sonido de sueño | zzz |
+| `[snoring]` | Sonido al dormir | zzz |
| `[clear throat]` | Sonido de carraspeo | ahem |
## Pausas y efectos especiales
@@ -140,7 +144,7 @@ Las etiquetas de efectos de audio añaden sonidos humanos naturales. A continuac
|-----|-------------|
| `[break]` | Pausa breve en el habla |
| `[long-break]` | Pausa prolongada en el habla |
-| `[short pause]` | Breve pausa entre líneas |
+| `[short pause]` | Pausa breve entre líneas |
| `[long pause]` | Silencio prolongado |
| `[audience laughing]` | Sonido de público riendo |
| `[background laughter]` | Risa de fondo |
@@ -158,7 +162,7 @@ Las palabras de pausa normales también marcan el ritmo sin necesidad de etiquet
[shouting] [angry] I told you this would happen!
```
-**Combina emociones en capas para expresiones complejas.** Limita las combinaciones a tres etiquetas o menos por oración:
+**Combina varias emociones para expresiones complejas.** Limita las combinaciones a tres etiquetas o menos por oración:
```text
[sad][whispering] I miss you so much.
@@ -166,7 +170,7 @@ Las palabras de pausa normales también marcan el ritmo sin necesidad de etiquet
[excited][laughing] We won! Ha ha!
```
-**Escribe transiciones de emoción** como una progresión natural entre oraciones:
+**Escribe las transiciones de emoción** como una progresión natural entre oraciones:
```text
[happy] I got the promotion!
@@ -176,7 +180,7 @@ Las palabras de pausa normales también marcan el ritmo sin necesidad de etiquet
[determined] I'm going to make it work!
```
-**Añade efectos de fondo** para dar atmósfera:
+**Agrega efectos de fondo** para crear ambiente:
```text
The comedy show was amazing [audience laughing]
@@ -190,29 +194,29 @@ The comedy show was amazing [audience laughing]
[extremely angry] This is unacceptable!
```
-## Mejores prácticas
+## Buenas prácticas
-**Qué hacer:**
+**Sí:**
- Usa una emoción principal por oración
- Ajusta las emociones al contexto de forma lógica
-- Agrega texto después de los efectos de sonido, por ejemplo "Ha ha" después de `[laughing]`
-- Espacia los cambios emocionales para que suenen realistas
+- Añade texto después de los efectos de sonido, por ejemplo "Ha ha" después de `[laughing]`
+- Espacia los cambios emocionales para lograr realismo
- Prueba distintas combinaciones con la misma voz
-**Qué evitar:**
+**No:**
-- No abuses de las etiquetas en textos cortos
-- No mezcles emociones en conflicto en una misma oración
-- No escribas descripciones entre corchetes tan largas que interrumpan el flujo
-- No dejes una etiqueta descriptiva sin texto después de ella
-- No coloques las indicaciones de emoción de una oración lejos de la oración que controlan
+- Abuses de las etiquetas en textos cortos
+- Mezcles emociones en conflicto dentro de una misma oración
+- Escribas descripciones entre corchetes tan largas que interrumpan el flujo
+- Dejes una etiqueta descriptiva sin texto después de ella
+- Alejes de la oración que controlan las indicaciones de emoción de nivel de oración
-Si el resultado suena poco natural, espacia los cambios emocionales, baja la intensidad o prueba con otra voz: la misma etiqueta funciona distinto en cada voz.
+Si la salida suena poco natural, espacia los cambios emocionales, baja la intensidad o prueba con otra voz: la misma etiqueta suena distinto en voces diferentes.
-## Diálogo con varios hablantes {#multi-speaker-dialogue}
+## Diálogo con varios hablantes
-Conecta dos o más voces al nodo Fish Audio Text to Speech y luego marca los cambios de hablante en el texto con `@Voice1`, `@Voice2` y así sucesivamente. Cada voz conectada debe aparecer al menos una vez en el texto, o el nodo genera un error. Las conexiones de voz se explican en [Fish Audio: texto a voz, clonación de voz y voz a texto](/es/tutorials/partner-nodes/fishaudio/fish-audio#conectar-voces).
+Conecta dos o más voces al nodo Fish Audio Texto a voz, luego marca los cambios de hablante en el texto con `@Voice1`, `@Voice2`, etc. Cada voz conectada debe aparecer en el texto al menos una vez; de lo contrario, el nodo genera un error. Las conexiones de voz se explican en [Fish Audio: Texto a voz, clonación de voz y voz a texto](/es/tutorials/partner-nodes/fishaudio/fish-audio#conectar-voces).
```text
@Voice1 [nervous] You're sure no one followed you?
@@ -221,9 +225,9 @@ Conecta dos o más voces al nodo Fish Audio Text to Speech y luego marca los cam
@Voice2 [curious] You don't even know what it is?
```
-## Control de fonemas {#phoneme-control}
+## Control de fonemas
-Las etiquetas de fonemas especifican pronunciaciones exactas para nombres, homógrafos, siglas y términos técnicos. Envuelve la pronunciación de reemplazo entre las etiquetas `<|phoneme_start|>` y `<|phoneme_end|>`. Las etiquetas de fonemas se conservan durante la normalización del texto, así que mantén `normalize` activado.
+Las etiquetas de fonemas especifican pronunciaciones exactas para nombres, homógrafos, siglas y términos técnicos. Encierra la pronunciación de reemplazo entre las etiquetas `<|phoneme_start|>` y `<|phoneme_end|>`. La normalización de texto conserva las etiquetas de fonemas, así que mantén `normalize` activado.
**Inglés** (CMU Arpabet, reemplaza una palabra):
@@ -231,13 +235,13 @@ Las etiquetas de fonemas especifican pronunciaciones exactas para nombres, homó
I am an <|phoneme_start|>EH1 N JH AH0 N IH1 R<|phoneme_end|>.
```
-**Chino** (pinyin con número de tono, reemplaza un carácter o una sílaba; útil para caracteres polifónicos y nombres):
+**Chino** (pinyin con número de tono, reemplaza un carácter o una sílaba, útil para caracteres polifónicos y nombres):
```text
我是一个<|phoneme_start|>gong1<|phoneme_end|><|phoneme_start|>cheng2<|phoneme_end|><|phoneme_start|>shi1<|phoneme_end|>。
```
-**Japonés** (romaji estilo OpenJTalk con dígitos de acento tonal):
+**Japonés** (romaji al estilo OpenJTalk con dígitos de acento tonal):
```text
<|phoneme_start|>ha0shi1ga0<|phoneme_end|>見えます。
@@ -251,34 +255,34 @@ I am, um, an [break] <|phoneme_start|>EH1 N JH AH0 N IH1 R<|phoneme_end|>.
## Ajuste de parámetros
-Los valores predeterminados están bien calibrados. Ajusta solo cuando lo necesites:
+Los valores predeterminados están bien ajustados. Ajusta solo cuando lo necesites:
| Parámetro | Valor predeterminado | Efecto |
|-----------|---------|--------|
| `temperature` | 0.7 | Expresividad. Un valor más alto es más variado, uno más bajo es más consistente |
-| `top_p` | 0.7 | Diversidad mediante muestreo de núcleo |
+| `top_p` | 0.7 | Diversidad mediante muestreo de núcleo (nucleus sampling) |
| `speed` | 1.0 | Velocidad del habla, de 0.5 a 2.0 |
| `volume` | 0.0 | Ajuste de volumen en decibelios, de -10 a 10 |
-| `normalize` | true | Expande números y fechas para una lectura natural. Mantenlo activado a menos que la normalización reescriba texto que quieres leer literalmente |
+| `normalize` | true | Expande números y fechas para una lectura natural. Mantenlo activado a menos que la normalización reescriba texto que quieres leer de forma literal |
-La `seed` controla si el nodo se vuelve a ejecutar; los resultados no son deterministas independientemente del valor de la semilla.
+El parámetro `seed` controla si el nodo se vuelve a ejecutar; los resultados no son deterministas, independientemente del valor de la semilla.
## Calidad de la clonación de voz
-Para el nodo Fish Audio Instant Voice Clone, la calidad de la grabación de referencia determina el resultado. Consulta los límites de grabación en [Fish Audio: texto a voz, clonación de voz y voz a texto](/es/tutorials/partner-nodes/fishaudio/fish-audio#límites-de-la-clonación-de-voz):
+Para el nodo Clonación instantánea de voz de Fish Audio, la calidad de la grabación de referencia decide el resultado. Los límites de grabación se explican en [Fish Audio: Text to Speech, clonación de voz y Speech to Text](/es/tutorials/partner-nodes/fishaudio/fish-audio#límites-de-la-clonación-de-voz):
- Graba de 2 a 3 clips de 15 a 20 segundos cada uno, con menos de 270 segundos en total
-- Un solo hablante, volumen constante, tono y emoción consistentes
-- Pausas pequeñas entre frases, de aproximadamente medio segundo
-- Habitación silenciosa, micrófono a una mano de distancia de la boca
-- Una grabadora de teléfono o un micrófono de auriculares son suficientes; evita la música de fondo, la televisión y el eco
+- Un solo hablante, volumen estable, tono y emoción uniformes
+- Pausas breves entre frases, de aproximadamente medio segundo
+- Una habitación silenciosa, con el micrófono a una mano de distancia de la boca
+- Sirve una grabadora de teléfono o el micrófono de unos auriculares; evita la música de fondo, la TV y el eco
-Si la voz clonada suena robótica, graba más material, de 30 a 60 segundos en total, y habla con naturalidad, con pausas.
+Si la voz clonada suena robótica, graba más material, de 30 a 60 segundos en total, y habla con naturalidad, haciendo pausas.
-Clona solo las voces que tengas permiso de usar: tu propia voz o la de alguien que te haya dado permiso explícito.
+Clona solo voces que tengas permiso de usar: la tuya propia, o la de alguien que te haya dado permiso explícito.
## Referencias
-- [Documentación sobre el control de emociones de Fish Audio](https://docs.fish.audio/developer-guide/core-features/emotions)
-- [Documentación sobre el control detallado de Fish Audio](https://docs.fish.audio/developer-guide/core-features/fine-grained-control)
+- [Documentación de control de emociones de Fish Audio](https://docs.fish.audio/developer-guide/core-features/emotions)
+- [Documentación de control detallado de Fish Audio](https://docs.fish.audio/developer-guide/core-features/fine-grained-control)
- [Prácticas recomendadas para la clonación de voces de Fish Audio](https://docs.fish.audio/developer-guide/best-practices/voice-cloning)
diff --git a/es/tutorials/partner-nodes/topaz/image-enhance-bloom-2.mdx b/es/tutorials/partner-nodes/topaz/image-enhance-bloom-2.mdx
index 9b022ecdfc..64adc9b912 100644
--- a/es/tutorials/partner-nodes/topaz/image-enhance-bloom-2.mdx
+++ b/es/tutorials/partner-nodes/topaz/image-enhance-bloom-2.mdx
@@ -2,48 +2,50 @@
title: "Topaz Image Enhance Bloom 2: ampliación creativa de imágenes con IA"
description: "Amplía y mejora imágenes con Topaz Image Enhance Bloom 2 en ComfyUI: ampliación creativa que añade detalle, textura y elementos visuales"
sidebarTitle: "Image Enhance Bloom 2"
-translationSourceHash: ea0e893b
+translationSourceHash: 243c9f97
translationFrom: tutorials/partner-nodes/topaz/image-enhance-bloom-2.mdx
translationBlockHashes:
"_intro": 1b619937
"What Topaz Image Enhance Bloom 2 is good at": bc0b5457
"Example outputs": 4eb243ba
+ "Topaz Image Enhance Bloom 2": 8e33b921
"Get started": 9c5c9043
---
+
import ReqHint from "/snippets/es/tutorials/partner-nodes/req-hint.mdx";
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
Topaz Image Enhance Bloom 2 es un modelo de ampliación creativa disponible en ComfyUI a través de los nodos asociados de Topaz. Añade nuevo detalle, textura y elementos visuales a tus imágenes, con un control de creatividad de 1 a 9 para un refinamiento sutil o una reinterpretación audaz. Conserva la relación de aspecto de la entrada y admite factores de ampliación de 1x a 6x.
-## Para qué es bueno Topaz Image Enhance Bloom 2
+## Para qué sirve Topaz Image Enhance Bloom 2
- **Ampliación creativa**: Agrega nuevos detalles, texturas y elementos visuales a tus imágenes
-- **Creatividad ajustable**: Un control de 1 para una mejora contenida hasta 9 para una reinterpretación pronunciada
+- **Creatividad ajustable**: Un control que va de 1 para una mejora contenida a 9 para una reinterpretación pronunciada
- **Prompt automático**: Si el prompt está vacío, el modelo crea uno automáticamente
- **Salida flexible**: Conserva la relación de aspecto de la entrada y admite factores de ampliación de 1x a 6x
## Salidas de ejemplo
-Ampliación creativa de una imagen generada por IA, con nuevos detalles y texturas añadidos:
+Ampliación creativa de una imagen generada por IA, con nuevo detalle y textura añadidos:
-## Topaz Image Enhance Bloom 2
+## Mejorar imagen con Topaz Bloom 2
-Mejora imágenes generadas por IA con el modelo de ampliación creativa de Bloom 2, que añade nuevo detalle, textura y elementos visuales. El control de Creatividad va de 1, para una mejora contenida, a 9, para una reinterpretación marcada. Si el prompt está vacío, el modelo crea uno automáticamente.
+Mejora las imágenes generadas por IA con el modelo de ampliación creativa de Bloom 2, que añade nuevo detalle, textura y elementos visuales. El control Creatividad va de 1, para una mejora contenida, a 9, para una reinterpretación marcada. Si el prompt está vacío, el modelo crea uno automáticamente.
-
+
Abrir en Comfy Cloud
- Descarga el JSON o busca "Topaz Image Enhance Bloom 2" en la Biblioteca de plantillas
+ Descarga el JSON o busca "Topaz Image Enhance Bloom 2" en la Biblioteca de plantillas
@@ -59,14 +61,14 @@ Descarga esta imagen de entrada de ejemplo para probar el flujo de trabajo:
-
+
### Resumen del flujo de trabajo
Este flujo de trabajo usa cuatro nodos:
- **LoadImage**: proporciona la imagen de origen
-- **TopazImageEnhanceV2**: el nodo principal, configurado con el modelo de ampliación `Bloom 2`
+- **TopazImageEnhanceV2**: el nodo principal, configurado con el modelo de mejora `Bloom 2`
- **SaveImageAdvanced**: guarda la salida mejorada como PNG
- **ImageCompare**: muestra el resultado mejorado junto al original para compararlos
@@ -74,11 +76,11 @@ Este flujo de trabajo usa cuatro nodos:
1. **Carga una imagen**: sube o selecciona tu imagen de entrada en el nodo **LoadImage**
2. **Selecciona el modelo**: mantén `Bloom 2` en el nodo **TopazImageEnhanceV2**
-3. **Establece la creatividad**: de 1 para una mejora contenida a 9 para una reinterpretación marcada
+3. **Ajusta la creatividad**: de 1 para una mejora contenida a 9 para una reinterpretación marcada
4. **Prompt opcional**: déjalo vacío para que el modelo cree uno automáticamente
5. **Haz clic en Queue**: pulsa `Ctrl+Enter` para generar
## Empezar
1. Actualiza ComfyUI a la última versión
-2. Ve a la Biblioteca de plantillas y busca `Topaz Image Enhance Bloom 2`
\ No newline at end of file
+2. Ve a la Biblioteca de plantillas y busca `Topaz Image Enhance Bloom 2`
diff --git a/es/tutorials/partner-nodes/topaz/overview.mdx b/es/tutorials/partner-nodes/topaz/overview.mdx
index b54b5643d6..f298730078 100644
--- a/es/tutorials/partner-nodes/topaz/overview.mdx
+++ b/es/tutorials/partner-nodes/topaz/overview.mdx
@@ -2,7 +2,7 @@
title: "Topaz Labs en ComfyUI: mejora de imagen y video"
description: "Mejora y amplía imágenes y video en ComfyUI con Topaz Labs: ampliación guiada por prompt con Reimagine, mejora de rostros, Starlight y Apollo."
sidebarTitle: "Topaz Labs"
-translationSourceHash: 8e0ad9e8
+translationSourceHash: f1695036
translationFrom: tutorials/partner-nodes/topaz/overview.mdx
---
@@ -18,7 +18,7 @@ Topaz Labs lleva a ComfyUI la mejora de imágenes y video con IA de nivel empres
- **Soporte de salida en 8K**: amplía imágenes y cuadros de video hasta la resolución ultra alta de 8K manteniendo la nitidez y la coherencia visual.
- **Ampliador de difusión Starlight**: ampliación basada en difusión optimizada para fotografía de paisajes, que genera detalle realista como follaje, texturas de roca y nubes.
- **Interpolación de cuadros Apollo**: genera cuadros intermedios suaves entre los cuadros de video existentes para efectos de cámara lenta o conversión de frecuencia de cuadros.
-- **Ampliación optimizada para ilustraciones**: modelo especializado en ilustraciones digitales, line art y obras de colores planos que preserva los bordes definidos y los degradados limpios.
+- **Ampliación optimizada para ilustraciones**: modelo especializado en obras de colores planos, line art e ilustraciones digitales que preserva los bordes definidos y los degradados limpios.
- **Flujo de trabajo de mejora de video**: procesamiento de video completo que incluye reducción de ruido, desentrelazado, estabilización y ampliación inteligente cuadro por cuadro.
diff --git a/es/tutorials/partner-nodes/topaz/video-enhance-starlight-precise-2-5.mdx b/es/tutorials/partner-nodes/topaz/video-enhance-starlight-precise-2-5.mdx
index 124e78ab9f..51c0b69ecc 100644
--- a/es/tutorials/partner-nodes/topaz/video-enhance-starlight-precise-2-5.mdx
+++ b/es/tutorials/partner-nodes/topaz/video-enhance-starlight-precise-2-5.mdx
@@ -2,7 +2,7 @@
title: "Topaz Starlight Precise 2.5 - Ampliación de video con IA"
description: "Amplía videos con Topaz Starlight Precise 2.5 en ComfyUI: salida 4K más nítida y con menos artefactos para material de acción real."
sidebarTitle: "Starlight Precise 2.5"
-translationSourceHash: 512ec885
+translationSourceHash: 43c2d2a4
translationFrom: tutorials/partner-nodes/topaz/video-enhance-starlight-precise-2-5.mdx
---
import ReqHint from "/snippets/es/tutorials/partner-nodes/req-hint.mdx";
@@ -14,8 +14,8 @@ Topaz Starlight Precise 2.5 es un modelo de ampliación de video disponible en C
## Para qué sirve Topaz Starlight Precise 2.5
- **Ampliación a 4K**: amplía videos MP4 hasta resolución 4K
-- **Mayor nitidez**: una salida más nítida con menos artefactos
-- **Metraje de acción real**: los pocos artefactos lo hacen ideal para video de acción real
+- **Resultados más nítidos**: una salida más nítida con menos artefactos
+- **Metraje de acción real**: los artefactos reducidos lo hacen adecuado para video de acción real
- **Opciones de resolución**: salida en FullHD (1080p) o 4K (2160p)
## Salidas de ejemplo
@@ -65,7 +65,7 @@ Este flujo de trabajo usa tres nodos:
### Pasos para ejecutar
1. **Carga un video**: conecta tu video MP4 al nodo **LoadVideo**
-2. **Selecciona el ampliador**: mantén `Starlight Precise 2.5` en el nodo **TopazVideoEnhanceV2**
+2. **Selecciona el modelo de ampliación**: mantén `Starlight Precise 2.5` en el nodo **TopazVideoEnhanceV2**
3. **Define la resolución**: `FullHD (1080p)` o `4K (2160p)`
4. **Haz clic en Queue**: presiona `Ctrl+Enter` para generar
diff --git a/es/tutorials/partner-nodes/wavespeed/overview.mdx b/es/tutorials/partner-nodes/wavespeed/overview.mdx
index 987ad27644..41555d15f2 100644
--- a/es/tutorials/partner-nodes/wavespeed/overview.mdx
+++ b/es/tutorials/partner-nodes/wavespeed/overview.mdx
@@ -2,7 +2,7 @@
title: "WaveSpeed en ComfyUI: ampliación de imagen y video"
description: "Amplía video y restaura imágenes en ComfyUI con WaveSpeed: ampliación temporal de video FLSH-VSR, restauración de fotos SeedVR2 y ampliación general."
sidebarTitle: "WaveSpeed"
-translationSourceHash: f7e72a84
+translationSourceHash: 39f7198f
translationFrom: tutorials/partner-nodes/wavespeed/overview.mdx
---
@@ -29,7 +29,7 @@ WaveSpeed ofrece dos grupos de modelos en ComfyUI. El grupo **Upscale** cubre la
- Ampliación general de imágenes y restauración de imágenes con SeedVR2 AI.
+ Ampliación general de imágenes y restauración con SeedVR2 AI.
Ampliación de video con IA y coherencia temporal.
diff --git a/es/tutorials/video/bytedance/bernini-r.mdx b/es/tutorials/video/bytedance/bernini-r.mdx
index 6a796a6bce..10d3f7b823 100644
--- a/es/tutorials/video/bytedance/bernini-r.mdx
+++ b/es/tutorials/video/bytedance/bernini-r.mdx
@@ -2,26 +2,28 @@
title: "Bernini-R en ComfyUI: edición de imágenes y video en contexto"
description: "Edita imágenes y video en ComfyUI con ByteDance Bernini-R, un modelo Wan 2.2 solo de renderizado que usa imágenes o video de referencia sin entrenamiento LoRA."
sidebarTitle: "Bernini-R"
-translationSourceHash: 28ac25ab
+translationSourceHash: d89830ba
translationFrom: tutorials/video/bytedance/bernini-r.mdx
translationBlockHashes:
"_intro": b791048b
+ "Model Installation": 286fbd69
"Example Workflows": cf2f84c1
"1. Image Editing": a9437ae9
"2. Video Editing": d17ea37c
"Community Resources": 9b4a0aaf
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
# Introducción a ComfyUI Bernini-R
-[Bernini-R](https://github.com/bytedance/Bernini) es el modelo Wan 2.2 **solo de renderizado** de ByteDance para el conditioning de imágenes y video en contexto. Utiliza un conjunto de flujos de conditioning (video fuente, imágenes de referencia, video de referencia) para guiar la generación. No requiere entrenamiento de LoRA ni ajuste fino.
+[Bernini-R](https://github.com/bytedance/Bernini) es el modelo Wan 2.2 de ByteDance **solo para renderizado**, pensado para el acondicionamiento de imágenes y video en contexto. Usa un conjunto de flujos de acondicionamiento (video fuente, imágenes de referencia, video de referencia) para guiar la generación. No requiere entrenamiento de LoRA ni ajuste fino.
Capacidades principales:
- **Varios tipos de tarea en un solo modelo**: generación de imagen y video, edición, cambio de iluminación, cambio de estilo, inserción de sujetos
-- **Acondicionamiento en contexto**: las imágenes y videos de referencia actúan como prompts visuales, inyectados como tokens
-- **Ligero**: modelo solo de renderizado. Sin backbone de difusión de texto a video.
+- **Acondicionamiento en contexto**: las imágenes y los videos de referencia actúan como prompts visuales y se inyectan como tokens
+- **Ligero**: modelo solo para renderizado. No usa un backbone de difusión de texto a video.
- **Soporte flexible de entradas**: referencias de una o varias imágenes, video a video, edición guiada por referencia
Bernini-R admite estos tipos de tarea:
@@ -31,7 +33,7 @@ Bernini-R admite estos tipos de tarea:
| **t2v** | Prompt de texto | Generación de texto a video |
| **v2v** | Video fuente | Cambio de estilo de video a video |
| **rv2v** | Video fuente + imagen(es) de referencia | Edición de video guiada por referencia (cambio de iluminación, inserción de sujetos) |
-| **r2v** | Solo imagen(es) de referencia | Generación de referencia a video |
+| **r2v** | Solo imagen(es) de referencia | Generación de video a partir de referencias |
| **img** | Imagen fuente + prompt de texto | Edición de imagen (cambio de iluminación, cambio de estilo, inserción de sujetos) |
| **ads2v** | Video fuente + video de referencia | Insertar contenido de imagen o video en el video fuente |
@@ -43,7 +45,7 @@ ComfyUI ahora admite de forma nativa los nodos de Bernini-R. Asegúrate de haber
## Instalación de modelos
-Descarga los pesos de modelo necesarios y guárdalos en las carpetas correspondientes de ComfyUI:
+Descarga los pesos de modelo requeridos y guárdalos en las carpetas correspondientes de ComfyUI:
**text_encoders:**
- [umt5_xxl_fp8_e4m3fn_scaled.safetensors](https://huggingface.co/Comfy-Org/Wan_2.1_ComfyUI_repackaged/blob/main/split_files/text_encoders/umt5_xxl_fp8_e4m3fn_scaled.safetensors?download=true)
@@ -76,16 +78,16 @@ ComfyUI/
## 1. Edición de imagen
-**Qué hace:** genera una imagen editada con iluminación coincidente y consulta una comparación en paralelo de antes y después. Es ideal para cambiar la iluminación de retratos y productos, mantener una iluminación coherente en conjuntos de fotos y para fotografía de catálogo de comercio electrónico.
+**Qué hace:** Genera una imagen editada con iluminación coincidente y consulta una comparación en paralelo de antes y después. Ideal para volver a iluminar retratos y productos, mantener una iluminación coherente en series de fotos y fotografía de catálogo para comercio electrónico.
-
+
Abrir en Comfy Cloud
- Descarga el JSON o busca "Bernini-R" en la biblioteca de plantillas
+ Descarga el JSON o busca "Bernini-R" en la Biblioteca de plantillas
@@ -104,14 +106,14 @@ ComfyUI/
1. **Selecciona el tipo de tarea**: elige tu tarea (Image Editing, Subject to Image, etc.)
2. **Conecta las entradas**: carga la imagen de origen y las imágenes de referencia opcionales
-3. **Escribe el prompt**: describe la edición que deseas
-4. **Ejecuta**: haz clic en Queue o usa `Cmd+Enter`
+3. **Escribe el prompt**: describe la edición deseada
+4. **Run**: haz clic en Queue o usa `Cmd+Enter`
-**Entrada de imagen de referencia:** úsala para **Subject to Image** cuando necesites una o más imágenes de referencia (sujeto, vestuario, escena, accesorios). En el prompt, usa `image0`, `image1`, … para hacer referencia a cada imagen. No es necesaria para **Image Editing**: esa tarea usa `source_image` en su lugar.
+**Entrada de imagen de referencia:** Úsala para **Subject to Image** cuando necesites una o más imágenes de referencia (sujeto, vestuario, escena, accesorios). En el prompt, usa `image0`, `image1`, … para hacer referencia a cada imagen. No es necesaria para **Image Editing**: esa tarea usa `source_image` en su lugar.
- Este flujo de trabajo usa nodos Subgraph para el procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y extender el flujo de trabajo.
+ Este flujo de trabajo usa nodos Subgraph para el procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y ampliar el flujo de trabajo.
@@ -119,16 +121,16 @@ ComfyUI/
## 2. Edición de video
-**Qué hace:** Genera un video editado con una nueva iluminación consistente usando Bernini-R. Conecta un video de origen, una o varias imágenes de referencia opcionales o un video de referencia, elige el tipo de tarea, escribe un prompt y ejecuta.
+**Qué hace:** Genera un video editado con una iluminación coherente usando Bernini-R. Conecta un video de origen, imágenes de referencia o un video de referencia opcionales, elige el tipo de tarea, escribe un prompt y ejecuta.
-
+
Abrir en Comfy Cloud
- Descarga el JSON o busca "Bernini-R" en Biblioteca de plantillas
+ Descarga el JSON o busca "Bernini-R" en la Biblioteca de plantillas
@@ -146,16 +148,16 @@ ComfyUI/
### Pasos para ejecutar
1. **Carga el video de origen**: conecta tu video de entrada
-2. **(Opcional) Carga las referencias**: una o varias imágenes de referencia o un video de referencia
+2. **(Opcional) Carga las referencias**: imágenes de referencia o video de referencia
3. **Selecciona el tipo de tarea**: v2v, rv2v, r2v o ads2v
-4. **Escribe el prompt**: describe la edición que quieres
-5. **Ejecuta**: haz clic en Queue o usa `Cmd+Enter`
+4. **Escribe el prompt**: describe la edición deseada
+5. **Run**: haz clic en Queue o usa `Cmd+Enter`
-**Entrada de imagen de referencia:** úsala cuando una tarea necesite una o más imágenes de referencia (rv2v, r2v, conjuntos de varias prendas). Cada imagen del lote se convierte en su propio token en contexto. Menciona `image0`, `image1`, … en el prompt si las referencias cumplen funciones distintas.
+**Entrada de imagen de referencia:** Úsala cuando una tarea necesite una o más imágenes de referencia (rv2v, r2v, atuendos con varias piezas). Cada imagen del lote se convierte en su propio token en contexto. Menciona `image0`, `image1`, … en el prompt si las referencias cumplen funciones distintas.
- Este flujo de trabajo usa nodos Subgraph para un procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y ampliar el flujo de trabajo.
+ Este flujo de trabajo usa nodos Subgraph para el procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y ampliar el flujo de trabajo.
@@ -163,6 +165,6 @@ ComfyUI/
## Recursos de la comunidad
-- [Bernini GitHub (bytedance/Bernini)](https://github.com/bytedance/Bernini): Documentación del artículo de investigación y de las tareas
-- [Comfy-Org/Bernini-R](https://huggingface.co/Comfy-Org/Bernini-R): Pesos oficiales del modelo para ComfyUI
+- [Bernini GitHub (bytedance/Bernini)](https://github.com/bytedance/Bernini): Artículo de investigación y documentación de tareas
+- [Comfy-Org/Bernini-R](https://huggingface.co/Comfy-Org/Bernini-R): Pesos oficiales del modelo de ComfyUI
- [Bernini: Latent Semantic Planning for Video Diffusion](https://arxiv.org/abs/2605.22344): Artículo de investigación
diff --git a/es/tutorials/video/hunyuan/hunyuan-video-1-5.mdx b/es/tutorials/video/hunyuan/hunyuan-video-1-5.mdx
index d536767e6e..9258b9026c 100644
--- a/es/tutorials/video/hunyuan/hunyuan-video-1-5.mdx
+++ b/es/tutorials/video/hunyuan/hunyuan-video-1-5.mdx
@@ -2,14 +2,17 @@
title: "HunyuanVideo 1.5 en ComfyUI: T2V e I2V en GPUs de consumo"
description: "Ejecuta HunyuanVideo 1.5 en ComfyUI con una GPU de 24 GB: texto a video e imagen a video de 8.3B en 720p, más un upscaler de superresolución para 1080p."
sidebarTitle: "HunyuanVideo 1.5"
-translationSourceHash: 3d889bf3
+translationSourceHash: 0c287152
translationFrom: tutorials/video/hunyuan/hunyuan-video-1-5.mdx
translationBlockHashes:
"_intro": 74d9d0ad
"Model highlights": a18b0a64
+ "Common models for all workflows": eb36d964
"Hunyuan Video 1.5 Text-to-Video Workflow": a6511c93
"Hunyuan Video 1.5 Image-to-Video Workflow": 9e20cd3b
+ "Super-resolution upscaler": 59623be1
---
+
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
[HunyuanVideo 1.5](https://github.com/Tencent/HunyuanVideo) es un modelo ligero de 8.3B parámetros desarrollado por el equipo Hunyuan de Tencent. Ofrece generación de video con calidad de primer nivel en GPUs de consumo (24 GB de VRAM), lo que reduce enormemente la barrera de entrada sin sacrificar la calidad.
@@ -20,7 +23,7 @@ import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
- **Potencia compacta**: Ofrece un rendimiento SOTA comparable al de modelos más grandes mientras se ejecuta en hardware de consumo.
- **Generación versátil**: Admite generación de texto a video e imagen a video (5-10s) de alta calidad con una consistencia excepcional.
-- **Control preciso**: Sigue instrucciones con solidez para movimientos de cámara, física y expresiones emocionales.
+- **Control preciso**: Sólido seguimiento de instrucciones para movimientos de cámara, física y expresiones emocionales.
- **Calidad cinematográfica**: Salida nativa en 720p (ampliable a 1080p) con una estética profesional.
- **Funciones completas**: Admite diversos estilos (realista, anime, 3D) y renderizado de texto en el video (chino/inglés).
@@ -30,13 +33,13 @@ Los siguientes modelos se usan tanto en los flujos de trabajo de texto a video c
- qwen_2.5_vl_7b_fp8_scaled.safetensors — guárdalo en ComfyUI/models/text_encoders/
+ qwen_2.5_vl_7b_fp8_scaled.safetensors: guárdalo en ComfyUI/models/text_encoders/
- byt5_small_glyphxl_fp16.safetensors — guárdalo en ComfyUI/models/text_encoders/
+ byt5_small_glyphxl_fp16.safetensors: guárdalo en ComfyUI/models/text_encoders/
-
- hunyuanvideo15_vae_fp16.safetensors — guárdalo en ComfyUI/models/vae/
+
+ hunyuanvideo15_vae_fp16.safetensors: guárdalo en ComfyUI/models/vae/
@@ -52,9 +55,9 @@ ComfyUI/
│ └── hunyuanvideo15_vae_fp16.safetensors
```
-## Flujo de trabajo de texto a video de Hunyuan Video 1.5
+## Flujo de trabajo de texto a video con Hunyuan Video 1.5
-HunyuanVideo 1.5 Text-to-Video genera videos de 5 a 10 segundos a partir de descripciones en lenguaje natural, con mejor calidad y menores requisitos de VRAM.
+HunyuanVideo 1.5 Text-to-Video genera videos de 5 a 10 segundos a partir de descripciones en lenguaje natural, con mayor calidad y menores requisitos de VRAM.
@@ -71,11 +74,11 @@ HunyuanVideo 1.5 Text-to-Video genera videos de 5 a 10 segundos a partir de desc
- hunyuanvideo1.5_720p_t2v_fp16.safetensors: guárdalo en ComfyUI/models/diffusion_models/
+ hunyuanvideo1.5_720p_t2v_fp16.safetensors — guarda el archivo en ComfyUI/models/diffusion_models/
-#### Almacenamiento de modelos
+#### Almacenamiento de los modelos
```
ComfyUI/
@@ -99,12 +102,12 @@ ComfyUI/
4. Haz clic en el botón `Queue` o usa el atajo `Ctrl(Cmd) + Enter` para ejecutar el flujo de trabajo
-El flujo de trabajo incluye un nodo de superresolución. Cuando está habilitado, usa `hunyuanvideo1.5_1080p_sr_distilled_fp16.safetensors` para aumentar la resolución de la salida a 1080p.
+El flujo de trabajo incluye un nodo de upscale con superresolución. Cuando está habilitado, usa `hunyuanvideo1.5_1080p_sr_distilled_fp16.safetensors` para escalar la salida a 1080p.
-## Flujo de trabajo de imagen a video con Hunyuan Video 1.5
+## Flujo de trabajo de imagen a video de Hunyuan Video 1.5
-HunyuanVideo 1.5 imagen a video transforma imágenes estáticas en videos suaves y de alta calidad, con mejor consistencia y dinámica de movimiento.
+HunyuanVideo 1.5 Imagen a video transforma imágenes estáticas en videos suaves y de alta calidad, con mejor consistencia y dinámica de movimiento.
@@ -129,10 +132,10 @@ HunyuanVideo 1.5 imagen a video transforma imágenes estáticas en videos suaves
- sigclip_vision_patch14_384.safetensors: guardar en ComfyUI/models/clip_vision/
+ sigclip_vision_patch14_384.safetensors: guárdalo en ComfyUI/models/clip_vision/
- hunyuanvideo1.5_720p_i2v_fp16.safetensors: guardar en ComfyUI/models/diffusion_models/
+ hunyuanvideo1.5_720p_i2v_fp16.safetensors: guárdalo en ComfyUI/models/diffusion_models/
@@ -162,14 +165,14 @@ ComfyUI/
4. Asegúrate de que el nodo `Load VAE` haya cargado `hunyuanvideo15_vae_fp16.safetensors`
5. Haz clic en el botón `Queue` o usa el atajo `Ctrl(Cmd) + Enter` para ejecutar el flujo de trabajo
-## Ampliador de superresolución
+## Upscaler de superresolución
-Ambos flujos de trabajo incluyen un nodo de superresolución que puede hacer upscale del video de salida de 720p a 1080p. Este ampliador opcional usa un modelo destilado para obtener una salida de alta resolución de forma eficiente.
+Ambos flujos de trabajo incluyen un nodo de superresolución que puede hacer upscale del video de salida de 720p a 1080p. Este upscaler opcional usa un modelo destilado para una salida de alta resolución eficiente.
-
- hunyuanvideo1.5_1080p_sr_distilled_fp16.safetensors — guárdalo en ComfyUI/models/diffusion_models/
+
+ hunyuanvideo1.5_1080p_sr_distilled_fp16.safetensors: guárdalo en ComfyUI/models/diffusion_models/
-Todos los modelos compartidos y específicos de cada flujo de trabajo, en conjunto:
+Todos los modelos compartidos y específicos del flujo de trabajo combinados:
```
ComfyUI/
@@ -186,3 +189,4 @@ ComfyUI/
│ ├── hunyuanvideo1.5_720p_i2v_fp16.safetensors // I2V model
│ └── hunyuanvideo1.5_1080p_sr_distilled_fp16.safetensors // Upscaler
```
+
diff --git a/es/tutorials/video/kandinsky/kandinsky-5.mdx b/es/tutorials/video/kandinsky/kandinsky-5.mdx
index 0c36c06627..ebadca8656 100644
--- a/es/tutorials/video/kandinsky/kandinsky-5.mdx
+++ b/es/tutorials/video/kandinsky/kandinsky-5.mdx
@@ -2,33 +2,36 @@
title: "Kandinsky 5.0 en ComfyUI: texto a video e imagen a video"
description: "Usa Kandinsky 5.0 Video Lite en ComfyUI: texto a video de hasta 10 segundos e imagen a video de 5 segundos, con variantes SFT de 2B, no-CFG y destilada."
sidebarTitle: "Kandinsky 5.0"
-translationSourceHash: 0766e01c
+translationSourceHash: e0a46d75
translationFrom: tutorials/video/kandinsky/kandinsky-5.mdx
translationBlockHashes:
"_intro": cd71d0f9
"Overview": dead89b1
"Model variants": 3bdbc0cb
+ "Text-to-Video workflow": 8641d2fb
+ "Image-to-Video workflow": b945bc9a
"Resources": fa8f3352
---
+
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
-[Kandinsky 5.0](https://huggingface.co/kandinskylab/Kandinsky-5.0-I2V-Lite-5s) es una familia de modelos de difusión para la generación de video e imágenes desarrollada por [Kandinsky Lab](https://huggingface.co/kandinskylab). Kandinsky 5.0 T2V Lite es un modelo ligero de 2B parámetros que se ubica entre los mejores modelos de generación de video de código abierto, capaz de generar videos de hasta 10 segundos de duración.
+[Kandinsky 5.0](https://huggingface.co/kandinskylab/Kandinsky-5.0-I2V-Lite-5s) es una familia de modelos de difusión para la generación de video e imágenes, desarrollada por [Kandinsky Lab](https://huggingface.co/kandinskylab). Kandinsky 5.0 T2V Lite es un modelo ligero de 2B de parámetros que figura entre los mejores modelos de generación de video de código abierto y es capaz de generar videos de hasta 10 segundos de duración.
## Descripción general
-Kandinsky 5.0 usa un pipeline de difusión latent con Flow Matching e incluye:
+Kandinsky 5.0 usa un pipeline de difusión latente con Flow Matching e incluye:
- **Diffusion Transformer (DiT):** Arquitectura generativa principal con atención cruzada a los embeddings de texto
-- **Qwen2.5-VL y CLIP:** Proporciona embeddings de texto de alta calidad
-- **HunyuanVideo 3D VAE:** Codifica y decodifica el video en un espacio latent
+- **Qwen2.5-VL y CLIP:** Proporcionan embeddings de texto de alta calidad
+- **HunyuanVideo 3D VAE:** Codifica y decodifica el video en un espacio latente
-La familia de modelos incluye varias variantes optimizadas para diferentes casos de uso:
+La familia de modelos incluye varias variantes optimizadas para distintos casos de uso:
- **Modelo SFT:** Máxima calidad de generación
- **CFG-distilled:** Inferencia 2× más rápida
- **Diffusion-distilled:** 6× más rápida con una pérdida mínima de calidad (16 pasos)
-- **Modelo preentrenado:** Diseñado para fine-tuning
+- **Modelo preentrenado:** Diseñado para ajuste fino
Todos los modelos están disponibles en versiones de generación de video de 5 y 10 segundos.
@@ -47,7 +50,7 @@ Todos los modelos están disponibles en versiones de generación de video de 5 y
Un modelo ligero de 2B que genera videos a partir de prompts en inglés y ruso con alta calidad visual.
-
+
@@ -63,18 +66,18 @@ Un modelo ligero de 2B que genera videos a partir de prompts en inglés y ruso c
**Codificadores de texto**
-
+
Codificador de texto Qwen2.5-VL 7B (FP8). Colócalo en ComfyUI/models/text_encoders/
-
+
Codificador de texto CLIP-L. Colócalo en ComfyUI/models/text_encoders/
**Modelo de difusión**
-
- Modelo de difusión Kandinsky 5.0 T2V Lite SFT (5 s). Colócalo en ComfyUI/models/diffusion_models/
+
+ Modelo de difusión Kandinsky 5.0 T2V Lite SFT (5s). Colócalo en ComfyUI/models/diffusion_models/
**VAE**
@@ -99,7 +102,7 @@ ComfyUI/
Un modelo ligero de 2B que genera videos a partir de prompts en inglés y ruso con alta calidad visual.
-
+
@@ -140,7 +143,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
**Modelo de difusión**
- Modelo de difusión Kandinsky 5.0 I2V Lite (5 s). Colócalo en ComfyUI/models/diffusion_models/
+ Modelo de difusión Kandinsky 5.0 I2V Lite (5s). Colócalo en ComfyUI/models/diffusion_models/
**VAE**
@@ -161,7 +164,7 @@ ComfyUI/
## Recursos
-- [Colección de modelos de Hugging Face](https://huggingface.co/collections/kandinskylab/kandinsky-50-video-lite)
+- [Colección de modelos de HuggingFace](https://huggingface.co/collections/kandinskylab/kandinsky-50-video-lite)
- [Repositorio de GitHub](https://github.com/ai-forever/Kandinsky-5)
- [Integración con ComfyUI](https://github.com/ai-forever/Kandinsky-5/blob/main/comfyui/README.md)
- [Página del proyecto](https://kandinskylab.github.io/kandinsky-5/)
diff --git a/es/tutorials/video/ltx/ltx-2-3.mdx b/es/tutorials/video/ltx/ltx-2-3.mdx
index 4d7e6dcbea..5a3974488c 100644
--- a/es/tutorials/video/ltx/ltx-2-3.mdx
+++ b/es/tutorials/video/ltx/ltx-2-3.mdx
@@ -2,18 +2,20 @@
title: "LTX-2.3 en ComfyUI: flujos de video y audio"
description: "Usa LTX-2.3 en ComfyUI con flujos nativos para texto a video, imagen a video, FLF2V, video controlado por audio, control IC-LoRA y personalización ID-LoRA."
sidebarTitle: "LTX-2.3"
-translationSourceHash: 0519dac5
+translationSourceHash: 2e21405a
translationFrom: tutorials/video/ltx/ltx-2-3.mdx
translationBlockHashes:
"_intro": 2afce33d
"Key features": 3ddea9bd
"Getting started": 8bd36b77
+ "ComfyUI Native Workflows": fb09a224
"Prompting tips": f92227b7
"Resources": 3f045765
---
+
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
-[LTX-2.3](https://huggingface.co/Lightricks/LTX-2.3) es la última evolución del modelo de generación de audio y video de código abierto de Lightricks, ahora compatible de forma nativa con ComfyUI. Sobre la base de LTX-2, esta versión ofrece mejoras importantes de calidad en detalles finos, video de retratos, calidad de audio, consistencia de imagen a video, comprensión de prompts y renderizado de texto.
+[LTX-2.3](https://huggingface.co/Lightricks/LTX-2.3) es la última evolución del modelo de generación de audio y video de código abierto de Lightricks, ahora compatible de forma nativa con ComfyUI. Tomando como base LTX-2, esta versión ofrece mejoras importantes de calidad en los detalles finos, el video de retrato, la calidad de audio, la consistencia de imagen a video, la comprensión de prompts y el renderizado de texto.
ComfyUI incluye seis flujos de trabajo nativos para LTX-2.3, cada uno diseñado para un modo de generación específico:
@@ -29,11 +31,11 @@ ComfyUI incluye seis flujos de trabajo nativos para LTX-2.3, cada uno diseñado
## Características clave
- **Detalles más finos**: nuevo espacio latente y VAE actualizado para texturas más nítidas, bordes más limpios y visuales más precisos
-- **Soporte para formato vertical 9:16**: calidad muy mejorada en videos verticales
-- **Mejor audio**: sonido más limpio con menos ruido y diálogos mejorados
+- **Soporte para 9:16 vertical**: calidad muy mejorada en videos en formato retrato
+- **Mejor audio**: sonido más limpio, con menos ruido y diálogos mejorados
- **Imagen a video mejorado**: movimiento más consistente y menos fallos
- **Comprensión de prompts más inteligente**: codificador de texto mejorado para una interpretación más precisa
-- **Soporte nativo en ComfyUI**: todos los flujos de trabajo son integrados, no se requieren Nodos personalizados
+- **Soporte nativo en ComfyUI**: todos los flujos de trabajo están integrados y no necesitas nodos personalizados
## Primeros pasos
@@ -41,21 +43,21 @@ LTX-2.3 es compatible de forma nativa con ComfyUI. Para empezar:
1. Actualiza ComfyUI a la última versión
2. Ve a **Biblioteca de plantillas** > **Video** > elige cualquier flujo de trabajo de LTX-2.3
-3. Sigue la ventana emergente para descargar los modelos y ejecutar el flujo de trabajo
+3. Sigue las indicaciones de la ventana emergente para descargar los modelos y ejecutar el flujo de trabajo
## Flujos de trabajo nativos de ComfyUI
-### LTX-2.3 Texto a video (T2V)
+### LTX-2.3 Text to Video (T2V)
-Genera videos a partir de prompts de texto con mejor comprensión de prompts y mejor renderizado de texto.
+Genera videos a partir de prompts de texto con una mejor comprensión de los prompts y renderizado de texto.
### LTX-2.3 Texto a video {#video_ltx2_3_t2v}
-Genera videos a partir de prompts de texto con mejor comprensión de prompts y mejor renderizado de texto.
+Genera videos a partir de prompts de texto con mejor comprensión de prompts y renderizado de texto.
-
+
@@ -66,7 +68,7 @@ Genera videos a partir de prompts de texto con mejor comprensión de prompts y m
-#### Descarga de modelos
+#### Descargas de modelos
@@ -78,7 +80,7 @@ Genera videos a partir de prompts de texto con mejor comprensión de prompts y m
Colócalo en ComfyUI/models/loras/
-
+
Colócalo en ComfyUI/models/text_encoders/
@@ -106,7 +108,7 @@ ComfyUI/
1. **Acciones principales**: Describe los eventos y las acciones tal como ocurren a lo largo del tiempo
2. **Detalles visuales**: Describe todos los detalles visuales que quieres que aparezcan en el video
-3. **Audio**: Describe los sonidos y el diálogo que necesita la escena
+3. **Audio**: Describe los sonidos y el diálogo necesarios para la escena
---
@@ -120,7 +122,7 @@ Genera videos a partir de una imagen de entrada con un movimiento más consisten
Genera videos a partir de una imagen de entrada con una consistencia de movimiento mejorada.
-
+
@@ -137,9 +139,9 @@ Genera videos a partir de una imagen de entrada con una consistencia de movimien
-#### Descarga de modelos
+#### Descargas de modelos
-El flujo de trabajo I2V usa el mismo conjunto de modelos que el de texto a video.
+El flujo de trabajo I2V usa el mismo conjunto de modelos que texto a video.
@@ -151,7 +153,7 @@ El flujo de trabajo I2V usa el mismo conjunto de modelos que el de texto a video
Colócalo en ComfyUI/models/loras/
-
+
Colócalo en ComfyUI/models/text_encoders/
@@ -179,22 +181,22 @@ ComfyUI/
### LTX-2.3 FLF2V
-Interpola entre una imagen inicial y una imagen final para generar una transición de video fluida.
+Interpola entre una imagen inicial y una imagen final para generar una transición de video suave.
-### LTX-2.3 Primer y último fotograma a video {#video_ltx2_3_flf2v}
+### LTX-2.3: convertir de primer y último fotograma a video {#video_ltx2_3_flf2v}
Interpola entre una imagen inicial y una final.
-
+
Abrir en Comfy Cloud
- Descarga el JSON o busca "LTX-2.3 FLF2V" en la Biblioteca de plantillas
+ Descarga el JSON o busca "LTX-2.3 FLF2V" en la biblioteca de plantillas
@@ -207,15 +209,15 @@ Interpola entre una imagen inicial y una final.
-#### Descarga de modelos
+#### Descargas de modelos
-El flujo de trabajo FLF2V usa el checkpoint distilled en lugar del checkpoint dev.
+El flujo de trabajo FLF2V usa el checkpoint destilado en lugar del checkpoint dev.
Colócalo en ComfyUI/models/checkpoints/
-
+
Colócalo en ComfyUI/models/text_encoders/
@@ -231,26 +233,24 @@ ComfyUI/
│ └── gemma_3_12B_it_fp4_mixed.safetensors
```
----
-
-### LTX-2.3 Imagen y audio a video (IA2V)
+### LTX-2.3 Image Audio to Video (IA2V)
-Sube una imagen y un archivo de audio para generar un video de alta calidad con movimientos labiales sincronizados.
+Sube una imagen y un archivo de audio para generar un video de alta calidad con movimientos de labios sincronizados.
### LTX-2.3 Imagen y audio a video {#video_ltx2_3_ia2v}
-Genera videos con sincronización labial a partir de una imagen y audio.
+Genera videos con sincronización de labios a partir de una imagen y un audio.
-
+
- Abrir en Comfy Cloud
+ Abre en Comfy Cloud
- Descarga el JSON o busca "LTX-2.3 IA2V" en la Biblioteca de plantillas
+ Descarga el JSON o busca "LTX-2.3 IA2V" en Template Library
@@ -259,29 +259,29 @@ Genera videos con sincronización labial a partir de una imagen y audio.
Imagen de referencia para el personaje que habla.
- Pista de audio para la sincronización labial.
+ Pista de audio para la sincronización de labios.
-#### Descarga de modelos
+#### Descargas de modelos
El flujo de trabajo IA2V usa el mismo conjunto de modelos que el de texto a video.
- Colócalo en ComfyUI/models/checkpoints/
+ Coloca en ComfyUI/models/checkpoints/
-
- Colócalo en ComfyUI/models/loras/
+
+ Coloca en ComfyUI/models/loras/
- Colócalo en ComfyUI/models/loras/
+ Coloca en ComfyUI/models/loras/
-
- Colócalo en ComfyUI/models/text_encoders/
+
+ Coloca en ComfyUI/models/text_encoders/
- Colócalo en ComfyUI/models/latent_upscale_models/
+ Coloca en ComfyUI/models/latent_upscale_models/
@@ -303,9 +303,9 @@ ComfyUI/
---
-### LTX-2.3 IC-LoRA Union Control
+### Control Union con IC-LoRA de LTX-2.3
-Genera videos con LTX-2.3 e IC-LoRA usando entradas de control alineadas como profundidad, pose o bordes. IC-LoRA es un LoRA in-context entrenado sobre LTX-2.3 que aplica la guía estructural de un video de referencia. Acepta señales de control de varios preprocesadores, incluidos mapas de profundidad, bordes de Canny y esqueletos de pose. Este flujo de trabajo usa un Subgraph para el procesamiento modular.
+Genera videos de LTX-2.3 con IC-LoRA usando entradas de control alineadas como profundidad, pose o bordes. IC-LoRA es un LoRA en contexto entrenado sobre LTX-2.3 que aplica orientación estructural a partir de un video de referencia. Acepta señales de control de varios preprocesadores, incluidos mapas de profundidad, bordes Canny y esqueletos de pose. Este flujo de trabajo usa un subgrafo para el procesamiento modular.
@@ -318,7 +318,7 @@ Genera videos con LTX-2.3 e IC-LoRA usando entradas de control alineadas como pr
-
+
Este flujo de trabajo usa un nodo Subgraph para el procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y ampliar el flujo de trabajo.
@@ -326,14 +326,14 @@ Genera videos con LTX-2.3 e IC-LoRA usando entradas de control alineadas como pr
- Video guía del que se extrae la señal de control.
+ Video guía para extraer la señal de control.
Imagen de referencia para el estilo y el contenido.
-#### Descarga de modelos
+#### Descargas de modelos
@@ -345,10 +345,10 @@ Genera videos con LTX-2.3 e IC-LoRA usando entradas de control alineadas como pr
Colócalo en ComfyUI/models/loras/
-
+
Colócalo en ComfyUI/models/text_encoders/
-
+
Colócalo en ComfyUI/models/geometry_estimation/
@@ -373,13 +373,13 @@ ComfyUI/
### Edición de video con IC-LoRA
-Los pesos IC-LoRA no se limitan al control de la generación. La Biblioteca de plantillas incluye flujos de trabajo IC-LoRA de LTX-2.3 ya preparados para editar material existente, y cada uno se ejecuta en Comfy Cloud o de forma local en ComfyUI. Los checkpoints IC-LoRA de la comunidad entrenados sobre LTX-2.3 (por ejemplo, la familia [LTX2.3-ICEdit-Insight](https://huggingface.co/joyfox/LTX2.3-ICEdit-Insight)) también son compatibles con el modelo nativo LTX-2.3.
+Los pesos IC-LoRA no se limitan al control de la generación. La Biblioteca de plantillas incluye flujos de trabajo LTX-2.3 IC-LoRA listos para editar material existente, y cada uno se ejecuta en Comfy Cloud o de forma local en ComfyUI. Los checkpoints IC-LoRA de la comunidad entrenados sobre LTX-2.3 (por ejemplo, la familia [LTX2.3-ICEdit-Insight](https://huggingface.co/joyfox/LTX2.3-ICEdit-Insight)) también son compatibles con el modelo nativo LTX-2.3.
#### Eliminar subtítulos de un video
Elimina subtítulos, rótulos, marcas de agua u otras superposiciones de texto de un video:
-
+
@@ -393,20 +393,20 @@ Elimina subtítulos, rótulos, marcas de agua u otras superposiciones de texto d
Materiales de entrada
-Descarga este video de entrada de ejemplo para probar el flujo de trabajo:
+Descarga este video de entrada de muestra para probar el flujo de trabajo:
-
- Descarga el video de entrada de ejemplo
+
+ Descargar video de entrada de muestra
#### Eliminar un objeto de un video
-Elimina un objeto concreto del primer plano de un video describiéndolo en el prompt:
+Elimina un objeto específico del primer plano de un video describiéndolo en el prompt:
-
+
@@ -420,11 +420,11 @@ Elimina un objeto concreto del primer plano de un video describiéndolo en el pr
Materiales de entrada
-Descarga este video de entrada de ejemplo para probar el flujo de trabajo:
+Descarga este video de entrada de muestra para probar el flujo de trabajo:
-
- Descarga el video de entrada de ejemplo
+
+ Descargar video de entrada de muestra
@@ -433,7 +433,7 @@ Descarga este video de entrada de ejemplo para probar el flujo de trabajo:
Restaura material de archivo antiguo o degradado:
-
+
@@ -447,20 +447,20 @@ Restaura material de archivo antiguo o degradado:
Materiales de entrada
-Descarga este video de entrada de ejemplo para probar el flujo de trabajo:
+Descarga este video de entrada de muestra para probar el flujo de trabajo:
-
- Descarga el video de entrada de ejemplo
+
+ Descargar video de entrada de muestra
#### Outpainting de video
-Amplía un video en cualquier dirección con el IC-LoRA Video Outpainting de LTX-2.3:
+Expande un video en cualquier dirección con el IC-LoRA Video Outpainting de LTX-2.3:
-
+
@@ -474,27 +474,27 @@ Amplía un video en cualquier dirección con el IC-LoRA Video Outpainting de LTX
Materiales de entrada
-Descarga este video de entrada de ejemplo para probar el flujo de trabajo:
+Descarga este video de entrada de muestra para probar el flujo de trabajo:
-
- Descarga el video de entrada de ejemplo
+
+ Descargar video de entrada de muestra
-#### Googly Eyes
+#### Ojos saltones
-Aplica el LoRA Googlyeyes de LTX-2.3 a un video de entrada para poner ojos saltones a todas las personas del fotograma:
+Aplica el LoRA Googlyeyes de LTX-2.3 a un video de entrada para darle ojos saltones a todos los que aparecen en el encuadre:
-
+
Abrir en Comfy Cloud
- Descarga el JSON o busca "Googly Eyes" en la Biblioteca de plantillas
+ Descargar JSON o buscar "Googly Eyes" en la biblioteca de plantillas
@@ -505,12 +505,12 @@ Descarga este video de entrada de ejemplo para probar el flujo de trabajo:
- Descarga el video de entrada de ejemplo
+ Descargar video de entrada de ejemplo
-Para los IC-LoRA de la comunidad, coloca el LoRA de edición en `ComfyUI/models/loras/` y cárgalo con un cargador de LoRA junto al checkpoint de LTX-2.3; después ejecuta el flujo de trabajo con tu video como entrada y un prompt como:
+Para los IC-LoRA de la comunidad, coloca el LoRA de edición en `ComfyUI/models/loras/` y cárgalo con un LoRA loader junto al checkpoint LTX-2.3; luego ejecuta el flujo de trabajo con tu video como entrada y un prompt como este:
```text
Remove subtitles, captions, and related text occlusions from the video, restoring a clean and natural underlying image.
@@ -528,7 +528,7 @@ Genera videos personalizados con audio sincronizado a partir de un prompt de tex
Genera videos personalizados con audio sincronizado a partir de una imagen de referencia y un clip de audio.
-
+
@@ -548,7 +548,7 @@ Genera videos personalizados con audio sincronizado a partir de una imagen de re
-#### Descarga de modelos
+#### Descargas de modelos
@@ -560,7 +560,7 @@ Genera videos personalizados con audio sincronizado a partir de una imagen de re
Colócalo en ComfyUI/models/loras/
-
+
Colócalo en ComfyUI/models/text_encoders/
@@ -584,12 +584,12 @@ ComfyUI/
│ └── ltx-2.3-spatial-upscaler-x2-1.1.safetensors
```
-## Consejos para escribir prompts
+## Consejos para los prompts
-Cuando escribas prompts para LTX-2.3, céntrate en descripciones detalladas y cronológicas de acciones y escenas:
+Cuando escribas prompts para LTX-2.3, enfócate en descripciones detalladas y cronológicas de las acciones y las escenas:
1. **Acciones principales**: Describe los eventos y las acciones tal como ocurren a lo largo del tiempo
-2. **Detalles visuales**: Describe todos los detalles visuales que quieres que aparezcan en el video
+2. **Detalles visuales**: Describe todos los detalles visuales que quieras que aparezcan en el video
3. **Audio**: Describe los sonidos y el diálogo que necesita la escena
## Recursos
diff --git a/es/tutorials/video/ltx/ltx-2-5-dfr.mdx b/es/tutorials/video/ltx/ltx-2-5-dfr.mdx
index 14cd89b24d..58c8025ffd 100644
--- a/es/tutorials/video/ltx/ltx-2-5-dfr.mdx
+++ b/es/tutorials/video/ltx/ltx-2-5-dfr.mdx
@@ -2,15 +2,17 @@
title: "LTX-2.5 DFR en ComfyUI: imagen a video con audio"
description: "Ejecuta el flujo de trabajo LTX-2.5 DFR en ComfyUI: tres etapas Diffusion Fidelity Rendering que generan video con audio sincronizado desde una imagen."
sidebarTitle: "LTX-2.5 DFR"
-translationSourceHash: 525f6be2
+translationSourceHash: 6958a6c7
translationFrom: tutorials/video/ltx/ltx-2-5-dfr.mdx
translationBlockHashes:
"_intro": 950d68f0
"The three stages": 1ccaf9c8
"Model downloads": c2c37fb4
+ "Model storage": d7c0900c
"Workflow controls": 2cf64b86
"Prompting tips": c40b888a
---
+
Genera un video con audio sincronizado a partir de una sola imagen mediante la ruta Diffusion Fidelity Rendering de LTX-2.5. DFR es la receta con calidad de producción: un transformer destilado combinado con un IC-LoRA de detallado, con keyframes generados dentro del clip y reutilizados como guías por las pasadas posteriores. Activa `Switch to T2V` para ejecutar el mismo pipeline solo desde texto.
Para los demás flujos de trabajo de LTX-2.5, consulta la [descripción general de LTX-2.5](/es/tutorials/video/ltx/ltx-2-5).
@@ -36,17 +38,17 @@ Para los demás flujos de trabajo de LTX-2.5, consulta la [descripción general
| Etapa | Se ejecuta a | Pasos | Qué hace |
| :---- | :------ | :---- | :----------- |
-| 1. Generar | La mitad del tamaño de salida | 8 | Aplica denoising al video, con un fotograma clave de detalle por segundo, y al audio juntos en una sola pasada |
-| 2. Espacial x2 | El tamaño de salida | 3 | Aplica upscale al latent de la etapa 1 y lo vuelve a muestrear con el IC-LoRA de detalle espacial de píxeles, usando el latent de media resolución como referencia |
-| 3. Temporal x2 | 241 fotogramas a 48 fps | 4 | Duplica la frecuencia de fotogramas en la misma duración, con los fotogramas clave de la etapa 2 fijados como guías |
+| 1. Generar | La mitad del tamaño de salida | 8 | Aplica denoise al video, con un fotograma clave de detalle por segundo, y al audio juntos en una sola pasada |
+| 2. Espacial x2 | El tamaño de salida | 3 | Hace upscale del latente de la etapa 1 y lo vuelve a muestrear con el IC-LoRA de detalle espacial de píxeles, usando el latente de media resolución como referencia |
+| 3. Temporal x2 | 241 fotogramas a 48 fps | 4 | Duplica la frecuencia de cuadros durante la misma duración, con los fotogramas clave de la etapa 2 fijados como guías |
Todas las etapas muestrean con el sampler `euler`, `cfg` 1.0 y una programación fija de `ManualSigmas`. El checkpoint está destilado, así que el número de pasos y las programaciones son parte de la receta: cambiarlos cambia el aspecto del resultado.
-La tercera etapa es opcional. Desactiva `Run 3rd stage - Temporal Upscale` para saltarla y obtener en su lugar un clip con la frecuencia de fotogramas de la etapa 2. El audio se arrastra desde la etapa 1 por todo el pipeline, así que el sonido no cambia cuando se ejecuta la pasada temporal.
+La tercera etapa es opcional. Desactiva `Run 3rd stage - Temporal Upscale` para saltarla y obtener en su lugar un clip con la frecuencia de cuadros de la etapa 2. El audio se conserva desde la etapa 1 en todo el pipeline, así que el sonido no cambia cuando se ejecuta la pasada temporal.
## Descargas de modelos
-El flujo de trabajo DFR carga el codificador de texto de precisión completa y añade el IC-LoRA de detallado más el escalador temporal, por lo que su conjunto de modelos difiere del de los demás flujos de trabajo de LTX-2.5.
+El flujo de trabajo DFR carga el codificador de texto de precisión completa y añade el IC-LoRA de detallado más el upscaler temporal, por lo que su conjunto de modelos difiere del de los demás flujos de trabajo de LTX-2.5.
@@ -97,15 +99,15 @@ ComfyUI/
## Controles del flujo de trabajo
-- `Start image (I2V)`: el primer fotograma. Se ignora mientras `Switch to T2V` esté activado
-- `Output size (aspect / megapixels)`: la relación de aspecto y el presupuesto de píxeles objetivo, redondeados a múltiplos de 32. La etapa 1 se ejecuta a la mitad de este tamaño
-- `Switch to T2V`: ejecuta el pipeline solo a partir de texto, sin una imagen inicial
-- `Float (fps)` y `Float (Duration)`: 24 fps durante 5 segundos por defecto, lo que da 121 fotogramas
-- `Enable Prompt Enhancer`: reescribe y amplía el prompt con el pequeño codificador Gemma 4 antes del muestreo
-- `Enable Tiled Decode`: decodifica el VAE en mosaicos para reducir el uso de VRAM, con un pequeño costo en el detalle fino
+- `Start image (I2V)`: el primer fotograma. Se ignora mientras `Switch to T2V` está activado.
+- `Output size (aspect / megapixels)`: la relación de aspecto y el presupuesto de píxeles objetivo, redondeados a múltiplos de 32. La etapa 1 se ejecuta a la mitad de este tamaño.
+- `Switch to T2V`: ejecuta el pipeline solo a partir de texto, sin una imagen inicial.
+- `Float (fps)` y `Float (Duration)`: 24 fps durante 5 segundos de forma predeterminada, lo que equivale a 121 fotogramas.
+- `Enable Prompt Enhancer`: reescribe y amplía el prompt con el pequeño codificador Gemma 4 antes del muestreo.
+- `Enable Tiled Decode`: decodifica el VAE por mosaicos para reducir el uso de VRAM, a costa de un pequeño sacrificio en el detalle fino.
## Consejos para escribir prompts
-1. **Escribe para un solo plano continuo**: DFR construye el clip a partir de fotogramas clave generados, así que describe una escena que se desarrolla en una sola toma en lugar de una secuencia de cortes
+1. **Escribe para una sola toma continua**: DFR construye el clip a partir de keyframes generados, así que describe una escena que se desarrolla en una sola toma en lugar de una secuencia de cortes
2. **Audio en la misma pasada**: pon las líneas habladas entre comillas y describe el ambiente y los efectos; el modelo genera el audio junto con el video
-3. **Mantén los movimientos de cámara suaves**: los movimientos rápidos sobre texturas con ruido y degradados suaves son donde el pipeline tiene más probabilidades de mostrar ebullición o banding
+3. **Mantén los movimientos de cámara suaves**: los movimientos rápidos sobre texturas con ruido y degradados suaves son donde el pipeline es más propenso a mostrar ebullición o banding
diff --git a/es/tutorials/video/ltxv.mdx b/es/tutorials/video/ltxv.mdx
index 21999ebd3e..79d540fb4f 100644
--- a/es/tutorials/video/ltxv.mdx
+++ b/es/tutorials/video/ltxv.mdx
@@ -2,13 +2,14 @@
title: "LTX-Video 0.9.5 en ComfyUI: T2V, I2V, control de múltiples fotogramas"
sidebarTitle: "LTX-0.9.5"
description: "Ejecuta LTX-Video 0.9.5 en ComfyUI para texto a video, imagen a video y control multifotograma desde imágenes inicial y final, con descarga y configuración."
-translationSourceHash: b2aad3a7
+translationSourceHash: b4e3cee7
translationFrom: tutorials/video/ltxv.mdx
translationBlockHashes:
"_intro": 354083fd
"Multi Frame Control": 0fe2f937
"Image to Video": 1072ef32
"Text to Video": 664fc166
+ "Requirements": 4d0884e2
---
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
@@ -85,14 +86,14 @@ Arrastra el video directamente a ComfyUI para ejecutar el flujo de trabajo.
## Requisitos
-Descarga los siguientes modelos y colócalos en las ubicaciones que se indican a continuación:
+Descarga los siguientes modelos y colócalos en las ubicaciones indicadas a continuación:
- Descarga y guárdalo en ComfyUI/models/checkpoints/
+ Descarga y coloca en ComfyUI/models/checkpoints/
- Descarga y guárdalo en ComfyUI/models/text_encoders/
+ Descarga y coloca en ComfyUI/models/text_encoders/
```
@@ -101,3 +102,4 @@ Descarga los siguientes modelos y colócalos en las ubicaciones que se indican a
└── text_encoders/
└── t5xxl_fp16.safetensors
```
+
diff --git a/es/tutorials/video/minimax/minimax-h3-fastvideo.mdx b/es/tutorials/video/minimax/minimax-h3-fastvideo.mdx
index 0dadd530c0..99eb4726c1 100644
--- a/es/tutorials/video/minimax/minimax-h3-fastvideo.mdx
+++ b/es/tutorials/video/minimax/minimax-h3-fastvideo.mdx
@@ -2,25 +2,27 @@
title: "FastVideo FastH3: ejemplos de flujos de trabajo de ComfyUI"
description: "FastVideo FastH3 genera video MiniMax H3 con audio sincronizado en 8 pasos de muestreo en ComfyUI, para flujos de texto a video y de primer/último fotograma."
sidebarTitle: "FastVideo FastH3"
-translationSourceHash: c9534724
+translationSourceHash: cb542dfa
translationFrom: tutorials/video/minimax/minimax-h3-fastvideo.mdx
translationBlockHashes:
"_intro": 096c332e
"Requirements": bcdeb37e
- "FastH3 Text to Video": e9a7420a
+ "FastH3 Text to Video": 1c4cb909
"FastH3 Image to Video": ec7d82bf
- "Workflow structure notes": 77b7c476
+ "Model downloads": b88037db
+ "Workflow structure notes": 8f5d2153
---
-[FastVideo FastH3](https://huggingface.co/FastVideo/FastVideo-FastH3-8-Step-V2) es un checkpoint de MiniMax H3 destilado con DMD2 por el equipo de FastVideo que genera video con audio nativo sincronizado en **8 pasos de muestreo** en lugar de la programación completa del modelo base. Reutiliza el codificador de texto de H3, el VAE de video y el VAE de audio, así que el resultado coincide con la configuración del modelo base mientras el muestreo termina en una fracción de los pasos.
-El trabajo de la versión de vista previa de FastH3 se desarrolló en colaboración con Nuva Lab y el equipo de NVIDIA FastGen; consulta el [anuncio de FastH3](https://haoailab.com/blogs/fasth3-preview/) para conocer los detalles de la destilación. ComfyUI incluye el checkpoint V2 de 8 pasos, reempaquetado por Comfy-Org en el [repositorio FastVideo-FastH3-Comfy](https://huggingface.co/FastVideo/FastVideo-FastH3-Comfy).
+[FastVideo FastH3](https://huggingface.co/FastVideo/FastVideo-FastH3-8-Step-V2) es un checkpoint de MiniMax H3 destilado con DMD2 por el equipo de FastVideo que genera video con audio nativo sincronizado en **8 pasos de muestreo** en lugar del programa de muestreo completo del modelo base. Reutiliza el codificador de texto de H3, el VAE de video y el VAE de audio, así que el resultado coincide con la configuración del modelo base mientras el muestreo termina en una fracción de los pasos.
+
+El trabajo de vista previa de FastH3 se desarrolló en colaboración con Nuva Lab y el equipo de NVIDIA FastGen; consulta el [anuncio de FastH3](https://haoailab.com/blogs/fasth3-preview/) para conocer los detalles de la destilación. ComfyUI incluye el checkpoint V2 de 8 pasos, reempaquetado por Comfy-Org en el [repositorio FastVideo-FastH3-Comfy](https://huggingface.co/FastVideo/FastVideo-FastH3-Comfy).
FastH3 sacrifica algo de fidelidad de movimiento y audio a cambio de velocidad. Úsalo para borradores, iteración y entregas rápidas; usa los flujos de trabajo base de MiniMax H3 cuando la máxima calidad sea lo importante.
-El checkpoint destilado solo admite texto a video e imagen a video con primer y último fotograma. Ref2VA (conditioning con múltiples referencias) no se destiló; usa los [flujos de trabajo base de MiniMax H3](/es/tutorials/video/minimax/minimax-h3-native) para la generación basada en referencias.
+El checkpoint destilado solo admite texto a video e imagen a video con primer y último fotograma. Ref2VA (acondicionamiento con múltiples referencias) no se destiló; usa los [flujos de trabajo base de MiniMax H3](/es/tutorials/video/minimax/minimax-h3-native) para la generación basada en referencias.
## Requisitos
@@ -49,17 +51,17 @@ Genera video y audio sincronizados a partir de un prompt de texto en 8 pasos.
### Consejos para escribir prompts
-1. **Describe toda la escena**: Indica primero la escena general (lugar, personaje, qué ocurre) y luego divídela en tomas con duración
+1. **Describe toda la escena**: Indica primero la escena general (lugar, personaje, qué ocurre) y luego divídela en tomas con tiempos definidos
2. **Tomas, cámara y audio**: Describe las tomas, los movimientos de cámara y el audio que las acompaña (diálogo, SFX, música) en un solo bloque de prompt
-3. **Resolución**: El lienzo nativo de H3 tiene un borde corto de 768px y un área de 768×1344, y las resoluciones se redondean a un múltiplo de 32. El nodo acepta tamaños mayores, pero se renderizan más lento sin añadir detalle
+3. **Resolución**: El lienzo nativo de H3 tiene un borde corto de 768px y un área de 768×1344, y las resoluciones se redondean a un múltiplo de 32. El nodo acepta tamaños mayores, pero tardan más en renderizarse sin añadir detalle
4. **Duración**: La entrada de duración se ajusta a la cuadrícula del modelo de 17 fotogramas por bloque (17k+5) a 24fps
-5. **Los pasos son fijos en 8**: El checkpoint destilado está entrenado para exactamente 8 pasos; cambiar la cantidad de pasos en el scheduler degrada la calidad
+5. **Los pasos son fijos en 8**: El checkpoint destilado está entrenado para exactamente 8 pasos; cambiar el número de pasos en el scheduler degrada la calidad
-Para obtener recursos sobre cómo escribir prompts, consulta la [guía de prompts](/es/tutorials/video/minimax/minimax-h3-prompt-guide).
+Para ver recursos sobre cómo escribir prompts, consulta la [guía de prompts](/es/tutorials/video/minimax/minimax-h3-prompt-guide).
## FastH3: imagen a video
-Anima una imagen fija con audio sincronizado y con control opcional de primer y último fotograma.
+Anima una imagen fija con audio sincronizado y con control opcional del primer y último fotograma.
@@ -88,7 +90,7 @@ Sube este archivo al nodo `LoadImage` correspondiente, o usa tu propia imagen:
### Modo de primer y último fotograma
-Conecta imágenes a `first_frame` y/o `last_frame` en el nodo `MiniMaxH3ImageToVideo` para generar el movimiento entre dos fotogramas clave. Deja ambos desconectados para texto a video.
+Conecta imágenes a `first_frame` y/o `last_frame` en el nodo `MiniMaxH3ImageToVideo` para generar el movimiento entre dos fotogramas clave. Deja ambos desconectados para el modo texto a video.
### Consejos para el prompt
@@ -96,15 +98,15 @@ Conecta imágenes a `first_frame` y/o `last_frame` en el nodo `MiniMaxH3ImageToV
2. **Duración**: La entrada de duración se ajusta a la cuadrícula del modelo de 17 fotogramas por bloque (17k+5) a 24fps
3. **Los pasos están fijos en 8**: Mantén el scheduler en 8 pasos; el checkpoint está destilado para esa programación
-## Descarga de modelos
+## Descargas de modelos
-El modelo de difusión viene del repositorio de FastVideo; el codificador de texto y los VAE se comparten con el modelo base MiniMax H3.
+El modelo de diffusion proviene del repositorio FastVideo; el text encoder y los VAE se comparten con el modelo base MiniMax H3.
-
+
Colócalo en ComfyUI/models/diffusion_models/
-
+
Colócalo en ComfyUI/models/text_encoders/
@@ -131,11 +133,11 @@ ComfyUI/
## Notas sobre la estructura del flujo de trabajo
-Ambos flujos de trabajo FastH3 comparten estos nodos con la configuración base de H3, con configuraciones específicas de destilación:
+Ambos flujos de trabajo de FastH3 comparten estos nodos con la configuración base de H3, con configuraciones específicas de destilación:
-- **BlockSparseAttention**: ejecuta Video Sparse Attention (VSA) con `keep_percent` 10, iniciando al 20% de la programación, lo que reduce el costo de atención mientras preserva la calidad
-- **MiniMaxH3SigmaShift**: aplica el desplazamiento sigma de H3 (10 para video, 3 para audio) que coincide con la programación destilada
-- **ComfyMathExpression**: convierte la entrada de duración en una `length` de fotogramas válida en la cuadrícula de 17k+5 a 24fps
-- **Sampler**: sampler `res_multistep` con el scheduler `simple` a 8 pasos
+- **BlockSparseAttention**: Ejecuta Video Sparse Attention (VSA) con `keep_percent` 10, a partir del 20% del programa, lo que reduce el costo de atención mientras preserva la calidad
+- **MiniMaxH3SigmaShift**: Aplica el desplazamiento sigma de H3 (10 para video, 3 para audio) que coincide con el programa destilado
+- **ComfyMathExpression**: Convierte la entrada de duración en una `length` de fotogramas válida en la cuadrícula 17k+5 a 24fps
+- **Sampler**: sampler `res_multistep` con el scheduler `simple` en 8 pasos
-Los pesos de FastH3 incluyen capas de compuerta `to_gate_compress`, que VSA lee para su rama gruesa. Los checkpoints base de H3 no las tienen. Para comparar métodos, establece `method` en `sol-attn` en el nodo **Model Sparse Attention** y mantén la misma seed. `sol-attn` no necesita pesos coincidentes y se ejecuta en cualquier checkpoint H3 con el `tau` que establezcas.
+Los pesos de FastH3 incluyen capas de compuerta `to_gate_compress`, que VSA lee para su rama gruesa. Los checkpoints base de H3 no las tienen. Para comparar métodos, establece `method` en `sol-attn` en el nodo **Model Sparse Attention** y mantén la misma semilla. `sol-attn` no necesita pesos coincidentes y funciona con cualquier checkpoint de H3 con el `tau` que establezcas.
diff --git a/es/tutorials/video/minimax/minimax-h3-fun-controlnet.mdx b/es/tutorials/video/minimax/minimax-h3-fun-controlnet.mdx
index 273cef655d..918bc97d5e 100644
--- a/es/tutorials/video/minimax/minimax-h3-fun-controlnet.mdx
+++ b/es/tutorials/video/minimax/minimax-h3-fun-controlnet.mdx
@@ -2,14 +2,16 @@
title: "ComfyUI MiniMax H3 Fun ControlNet Union: video con control de pose, profundidad y Canny"
description: "Guía el movimiento de video de MiniMax H3 en ComfyUI con videos de control Canny, Depth, HED, MLSD o Pose, además de relleno inteligente con máscaras usando el parche Fun ControlNet Union."
sidebarTitle: "Fun ControlNet Union"
-translationSourceHash: d4c42cef
+translationSourceHash: e9538916
translationFrom: tutorials/video/minimax/minimax-h3-fun-controlnet.mdx
translationBlockHashes:
"_intro": a84faa25
"Model downloads": 5310815d
+ "Model storage": b507229f
"Prompting tips": 39f67d41
---
-Controla el movimiento de un video de MiniMax H3 con un video de control en lugar de solo texto. El parche Fun ControlNet Union ([alibaba-pai/MiniMax-H3-Fun-Controlnet-Union](https://huggingface.co/alibaba-pai/MiniMax-H3-Fun-Controlnet-Union), empaquetado en [Comfy-Org/MiniMax-H3](https://huggingface.co/Comfy-Org/MiniMax-H3)) es un único checkpoint que condiciona H3 con videos de control Canny, Profundidad, HED, MLSD o Pose, y también ejecuta relleno inteligente de video con una máscara. Funciona con ambos archivos transformer `fl2va` y `ref2va`.
+
+Controla el movimiento de un video de MiniMax H3 con un video de control en lugar de usar solo texto. El parche Fun ControlNet Union ([alibaba-pai/MiniMax-H3-Fun-Controlnet-Union](https://huggingface.co/alibaba-pai/MiniMax-H3-Fun-Controlnet-Union), empaquetado en [Comfy-Org/MiniMax-H3](https://huggingface.co/Comfy-Org/MiniMax-H3)) es un único checkpoint que condiciona H3 con videos de control Canny, Profundidad, HED, MLSD o Pose, y también ejecuta relleno inteligente de video con una máscara. Funciona con los archivos transformer `fl2va` y `ref2va`.
@@ -32,7 +34,7 @@ Sube este archivo al nodo `Load Video` correspondiente:
-Esta plantilla requiere ComfyUI 0.35.0 o una versión posterior. El ejemplo usa un video de control de pose: un subgrafo SDPose integrado extrae el esqueleto de la pose del video de entrada, por lo que la salida reproduce el movimiento del bailarín. También puedes conectar cualquier video de control preprocesado directamente a la entrada `control_video` del nodo `Apply MiniMax H3 Fun ControlNet`.
+Esta plantilla requiere ComfyUI 0.35.0 o una versión posterior. El ejemplo usa un video de control de pose: un subgrafo SDPose integrado extrae el esqueleto de la pose del video de entrada, así que la salida reproduce el movimiento del bailarín. También puedes conectar cualquier video de control preprocesado directamente a la entrada `control_video` del nodo `Apply MiniMax H3 Fun ControlNet`.
## Descargas de modelos
@@ -53,7 +55,7 @@ Esta plantilla requiere ComfyUI 0.35.0 o una versión posterior. El ejemplo usa
Coloca en ComfyUI/models/vae/
- Habilita el modo turbo opcional con el Lightning LoRA. Coloca en ComfyUI/models/loras/
+ Habilita el modo turbo opcional del Lightning LoRA. Coloca en ComfyUI/models/loras/
Extractor de pose que usa el subgrafo SDPose integrado. Coloca en ComfyUI/models/checkpoints/
@@ -84,10 +86,10 @@ ComfyUI/
│ └── sdpose_wholebody_fp16.safetensors
```
-## Consejos para los prompts
+## Consejos para escribir prompts
-1. **Duración del video**: El video objetivo dura de 5 a 15 segundos en la cuadrícula de fotogramas 17n+5 a 24fps (124 fotogramas = 5 segundos). Un video de control más largo que el objetivo se recorta a sus primeros fotogramas; uno más corto mantiene su último fotograma. Para igualar exactamente la duración del video de control, conecta la salida `batch_size` calculada del ejemplo con la entrada de longitud del nodo `MiniMax H3 Reference to Video`
-2. **Orientación y strength**: Mantén `guidance_scale` en 1.0. Aumenta el `strength` del patch por encima de 1 solo si el resultado se aleja del control
-3. **Relleno inteligente de video**: Conecta una máscara a la entrada `mask`: las regiones marcadas con `1` se regeneran bajo el control de la entrada opcional `source_video`, mientras el resto del fotograma permanece fijo
+1. **Duración del video**: El video objetivo dura entre 5 y 15 segundos en la cuadrícula de fotogramas 17n+5 a 24fps (124 fotogramas = 5 segundos). Si el video de control es más largo que el objetivo, se recorta a sus primeros fotogramas; si es más corto, mantiene su último fotograma. Para igualar exactamente la duración del video de control, conecta la salida `batch_size` calculada del ejemplo a la entrada de duración del nodo `MiniMax H3 Referencia a Video`
+2. **Orientación y fuerza**: Mantén `guidance_scale` en 1.0. Aumenta la `strength` del patch por encima de 1 solo si la salida se aleja del control
+3. **Relleno inteligente de video**: Conecta una máscara a la entrada `mask`: las regiones marcadas con `1` se regeneran bajo el control de la entrada opcional `source_video`, mientras que el resto del fotograma permanece fijo
4. **Modo turbo (opcional)**: Activa la casilla **Lightning LoRA** para usar el LoRA turbo de 4 pasos y generar mucho más rápido, con una calidad de audio y movimiento ligeramente inferior
-5. **Preparar los videos de control**: ComfyUI incluye nodos de preprocesamiento integrados para cada tipo de control. Consulta el [nodo Detect Edges (Canny)](https://docs.comfy.org/built-in-nodes/Canny) para bordes y el [tutorial Depth Anything 3](https://docs.comfy.org/tutorials/utility/depth-anything-3) para mapas de profundidad
+5. **Preparar videos de control**: ComfyUI incluye nodos de preprocesamiento integrados para cada tipo de control. Consulta el [nodo Detect Edges (Canny)](https://docs.comfy.org/built-in-nodes/Canny) para bordes y el [tutorial de Depth Anything 3](https://docs.comfy.org/tutorials/utility/depth-anything-3) para mapas de profundidad
diff --git a/es/tutorials/video/minimax/minimax-h3-multiframe.mdx b/es/tutorials/video/minimax/minimax-h3-multiframe.mdx
index 79e7241a9d..d9b87a3444 100644
--- a/es/tutorials/video/minimax/minimax-h3-multiframe.mdx
+++ b/es/tutorials/video/minimax/minimax-h3-multiframe.mdx
@@ -2,14 +2,16 @@
title: "Flujo de trabajo de referencia multifotograma de MiniMax H3 en ComfyUI"
description: "Crea continuaciones de video y escenas de varias tomas con MiniMax H3 en ComfyUI fijando fotogramas de referencia en la línea de tiempo con nodos Add Guide."
sidebarTitle: "Referencia multifotograma"
-translationSourceHash: 456918f4
+translationSourceHash: 92c8dde7
translationFrom: tutorials/video/minimax/minimax-h3-multiframe.mdx
translationBlockHashes:
"_intro": 3a03ecf1
"Model downloads": 263666fa
+ "Model storage": 17ed75e6
"Prompting tips": 12a34e31
"Prompt writing guide": 4f808c3a
---
+
Genera continuaciones de video y escenas de varios planos anclando fotogramas de referencia en puntos específicos a lo largo de la línea de tiempo de salida. El flujo de trabajo combina el nodo Reference to Video con nodos Add Guide encadenados: cada Add Guide fija una imagen estática (más audio opcional) a un índice de fotograma, de modo que el video pasa por esa composición exacta en ese momento.
@@ -54,7 +56,7 @@ Genera continuaciones de video y escenas de varios planos anclando fotogramas de
Colócalo en ComfyUI/models/vae/
- Habilita el modo turbo opcional con el Lightning LoRA. Colócalo en ComfyUI/models/loras/
+ Habilita el modo turbo opcional del Lightning LoRA. Colócalo en ComfyUI/models/loras/
@@ -76,12 +78,12 @@ ComfyUI/
## Consejos para el prompt
-1. **Haz referencia por etiqueta**: `` es la imagen conectada a la primera ranura de `ref_images`, `` a la segunda, y así sucesivamente. En este flujo de trabajo, `` es tanto el bloqueo de identidad como el primer fotograma del video
-2. **Anclajes de la línea de tiempo frente a referencias**: las imágenes conectadas solo a nodos Add Guide anclan composiciones en fotogramas específicos, pero no son visibles para el codificador de texto. Conéctalas también a ranuras `ref_images` adicionales si quieres que el prompt las vea como ``
-3. **Índice de fotograma**: cada Add Guide toma `frame_idx` en fotogramas a 24 fps; la plantilla lo calcula a partir de segundos con `round(seconds * 24)`. Los valores negativos cuentan desde el final del video. El índice más la longitud de la guía deben quedar dentro de la duración generada
-4. **Añade más fotogramas clave**: copia un bloque de guía (Load Image + Frame Index + Math Expression + Add Guide for MiniMax H3) y mantén las salidas `positive` encadenadas en serie hacia el Basic Guider
-5. **Modo turbo (opcional)**: activa la casilla **Lightning LoRA** para usar el LoRA turbo de 4 pasos y lograr una generación mucho más rápida, con una calidad de audio y movimiento ligeramente inferior
+1. **Referencia por etiqueta**: `` es la imagen conectada a la primera ranura `ref_images`, `` la segunda, y así sucesivamente. En este flujo de trabajo, `` es a la vez el bloqueo de identidad y el primer fotograma del video
+2. **Anclajes de línea de tiempo vs referencias**: Las imágenes conectadas solo a nodos Añadir guía para MiniMax H3 anclan composiciones en fotogramas específicos, pero no son visibles para el codificador de texto. Conéctalas también a ranuras `ref_images` adicionales si el prompt debe verlas como ``
+3. **Índice de fotogramas**: Cada Añadir guía para MiniMax H3 toma `frame_idx` en fotogramas a 24fps; la plantilla lo calcula a partir de segundos con `round(seconds * 24)`. Los valores negativos cuentan desde el final del video. El índice más la longitud de la guía deben mantenerse dentro de la duración generada
+4. **Añadir más fotogramas clave**: Copia un bloque de guía (Cargar imagen + Índice de fotogramas + Expresión matemática + Añadir guía para MiniMax H3) y mantén las salidas `positive` encadenadas en serie hasta la Guía básica
+5. **Modo turbo (opcional)**: Activa la casilla **Lightning LoRA** para usar el LoRA turbo de 4 pasos y obtener una generación mucho más rápida, con una calidad de audio y movimiento ligeramente inferior
## Guía para escribir prompts
-El prompt de la plantilla sigue la [guía de prompts del modo de referencia completa](https://huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/docs/VIDEO_PROMPT_WRITING_GUIDE_ref_en.md): define cada sujeto, asigna cada `` al primer fotograma o fotograma clave de un plano y corta entre planos en marcas de tiempo explícitas. Usa la misma estructura cuando escribas tus propios prompts de varios planos. La guía está resumida en la [guía de prompts](/es/tutorials/video/minimax/minimax-h3-prompt-guide).
+El prompt de la plantilla sigue la [guía de prompts del modo de referencia completa](https://huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/docs/VIDEO_PROMPT_WRITING_GUIDE_ref_en.md): define cada sujeto, asigna cada `` al primer fotograma o al fotograma clave de un plano, y corta entre planos en marcas de tiempo explícitas. Usa la misma estructura cuando escribas tus propios prompts de varios planos. La guía está resumida en la [guía de prompts](/es/tutorials/video/minimax/minimax-h3-prompt-guide).
diff --git a/es/tutorials/video/minimax/minimax-h3-prompt-guide.mdx b/es/tutorials/video/minimax/minimax-h3-prompt-guide.mdx
index 2a9accf37c..7d48c43bc4 100644
--- a/es/tutorials/video/minimax/minimax-h3-prompt-guide.mdx
+++ b/es/tutorials/video/minimax/minimax-h3-prompt-guide.mdx
@@ -2,16 +2,17 @@
title: "Guía de prompts de ComfyUI MiniMax H3: guías oficiales, consejos y embeddings de prompt"
description: "Escribe mejores prompts de MiniMax H3 en ComfyUI: guías oficiales, consejos generales, reglas de diálogo y hablantes, y embeddings de estilo."
sidebarTitle: "Guía de prompts"
-translationSourceHash: 0d858ae8
+translationSourceHash: 0f1ded35
translationFrom: tutorials/video/minimax/minimax-h3-prompt-guide.mdx
translationBlockHashes:
"_intro": da22cc9d
"Official guides": 3d762c67
- "General tips": 91822299
+ "General tips": fab4ad35
"Shots and cuts": 8184dae6
"Dialogue and speakers": 4985438e
"Prompt embeddings": 9c899169
---
+
H3 espera planos, cámara, diálogo y SFX en un solo prompt multimodal. Esta página reúne guías oficiales, consejos entre flujos de trabajo, reglas de planos y diálogo, y embeddings de estilo.
## Guías oficiales
@@ -21,7 +22,7 @@ H3 espera planos, cámara, diálogo y SFX en un solo prompt multimodal. Esta pá
El paquete instalable de [habilidades H3](https://github.com/MiniMax-AI/MiniMax-H3/tree/main/skills) reúne estos contenidos para los agentes.
-Aplicado por plantilla: [T2V/I2V](/es/tutorials/video/minimax/minimax-h3-native), [R2V](/es/tutorials/video/minimax/minimax-h3-native#minimax-h3-referencia-a-video-r2v), [Multiframe](/es/tutorials/video/minimax/minimax-h3-multiframe#guía-para-escribir-prompts), [Fun ControlNet](/es/tutorials/video/minimax/minimax-h3-fun-controlnet#consejos-para-los-prompts).
+Aplicado por plantilla: [T2V/I2V](/es/tutorials/video/minimax/minimax-h3-native), [R2V](/es/tutorials/video/minimax/minimax-h3-native#minimax-h3-referencia-a-video-r2v), [Multiframe](/es/tutorials/video/minimax/minimax-h3-multiframe#guía-para-escribir-prompts), [Fun ControlNet](/es/tutorials/video/minimax/minimax-h3-fun-controlnet#consejos-para-escribir-prompts).
## Consejos generales
@@ -41,7 +42,7 @@ Escribe los prompts en **inglés**. Los diálogos y las letras de canciones van
4. **Longitud**: `length` son fotogramas a 24fps (predeterminado **124** ≈ 5s), ajustado a **17k+5**
5. **Texto en pantalla**: comillas dobles en inglés para cada cadena, literal (p. ej., `A red neon sign reading "营业中"`). Las líneas habladas usan ``, no comillas
6. **Marcadores de audio de R2V**: en el análisis de retención, marca cada referencia de audio como `fully_copy`, `partially_copy`, `reference` o `weak_reference` según cómo se use el clip (consulta la tabla de la guía oficial de referencias)
-7. **Campos de audio**: `overall_soundscape` = sonido ambiente/SFX/no verbal (1–4 frases; `N/A` solo si hay silencio real). Los diálogos y la música diegética se mantienen en los planos. `non_diegetic_music` = solo banda sonora (1–3 frases; `N/A` si no hay). Si aparece habla no deseada, rellena ambos campos de forma explícita
+7. **Campos de audio**: `overall_soundscape` = sonido ambiente/SFX/no verbal (1–4 frases; `N/A` solo si hay silencio real). Los diálogos y la música diegética se mantienen en los planos. `non_diegetic_music` = solo banda sonora musical (1–3 frases; `N/A` si no hay). Si aparece habla no deseada, rellena ambos campos de forma explícita
8. **Sin negativos**: `BasicGuider` funciona con `cfg` 1 y sin rama negativa. Las listas de prohibiciones añaden conceptos no deseados. Indica lo que debería aparecer (o usa los campos de retención de R2V: `fully_preserved`, `partially_preserved`, etc.)
9. **Hojas de referencia (R2V)**: una imagen puede contener varios paneles. Asigna a la hoja su propio `` (no solo dentro de ``), describe los paneles y dirige los planos a un panel (p. ej., vista frontal completa de ``). Etiqueta los paneles con claridad
diff --git a/es/tutorials/video/wan/fun-camera.mdx b/es/tutorials/video/wan/fun-camera.mdx
index 44669c4aad..45a71045d2 100644
--- a/es/tutorials/video/wan/fun-camera.mdx
+++ b/es/tutorials/video/wan/fun-camera.mdx
@@ -2,16 +2,18 @@
title: "Ejemplos oficiales de ComfyUI Wan2.1 Fun Camera"
description: "Esta guía muestra cómo usar Wan2.1 Fun Camera en ComfyUI para generar video"
sidebarTitle: "Wan2.1 Fun Camera"
-translationSourceHash: 6173f2a1
+translationSourceHash: f2b906a8
translationFrom: tutorials/video/wan/fun-camera.mdx
translationBlockHashes:
"_intro": 59d5e57d
"About Wan2.1 Fun Camera": 98c0ae00
+ "Model Installation": 65ab0da5
"ComfyUI Wan2.1 Fun Camera 1.3B Workflow": 4ddf8882
"ComfyUI Wan2.1 Fun Camera 14B Workflow": ea99a5f1
"Performance Reference": 2dc2f8f0
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
Wan2.1 Fun Camera es un modelo de generación de video con movimiento de cámara del proyecto VideoX-Fun de Alibaba, con soporte nativo en ComfyUI. Genera videos cuyo movimiento de cámara sigue tus condiciones de control, así puedes dirigir cómo se mueve la cámara en el resultado en lugar de describir cada plano en el prompt.
@@ -19,27 +21,27 @@ El modelo forma parte de la familia Wan2.1-Fun y se distribuye en dos tamaños:
## Acerca de Wan2.1 Fun Camera
-**Wan2.1 Fun Camera** es un proyecto de generación de video lanzado por el equipo de Alibaba, centrado en controlar los efectos de generación de video mediante el movimiento de cámara.
+**Wan2.1 Fun Camera** es un proyecto de generación de video lanzado por el equipo de Alibaba, centrado en controlar los efectos de la generación de video mediante el movimiento de cámara.
-**Descargar los pesos del modelo**:
+**Descarga de los pesos del modelo**:
- [Versión 14B](https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-14B-Control-Camera)
- [Versión 1.3B](https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-1.3B-Control-Camera)
**Repositorio de código**: [VideoX-Fun](https://github.com/aigc-apps/VideoX-Fun)
-**ComfyUI ahora es compatible de forma nativa con el modelo Wan2.1 Fun Camera**.
+**ComfyUI ya es compatible de forma nativa con el modelo Wan2.1 Fun Camera**.
-## Instalación de modelos
+## Instalación del modelo
-Estos modelos solo hay que instalarlos una vez. Además, la información de descarga de los modelos está incluida en las imágenes de los flujos de trabajo correspondientes, así que puedes elegir la forma de descarga que prefieras.
+Estos modelos solo necesitan instalarse una vez. Además, la información de descarga de los modelos está incluida en las imágenes del flujo de trabajo correspondiente, así que puedes elegir la forma de descarga que prefieras.
-Todos los modelos siguientes están disponibles en [Wan_2.1_ComfyUI_repackaged](https://huggingface.co/Comfy-Org/Wan_2.1_ComfyUI_repackaged)
+Puedes encontrar todos los siguientes modelos en [Wan_2.1_ComfyUI_repackaged](https://huggingface.co/Comfy-Org/Wan_2.1_ComfyUI_repackaged)
### Modelos de difusión
-Elige entre 1.3B o 14B:
+Elige 1.3B o 14B:
@@ -50,7 +52,7 @@ Elige entre 1.3B o 14B:
-Si ya has usado modelos de Wan2.1, deberías tener ya los siguientes modelos. Si no es así, descárgalos:
+Si ya has usado modelos relacionados con Wan2.1 antes, ya deberías tener los siguientes modelos. Si no es así, descárgalos:
### Codificadores de texto
@@ -61,7 +63,7 @@ Elige uno de los siguientes:
Codificador de texto de precisión completa
- Codificador de texto cuantizado FP8 (recomendado para menos VRAM)
+ Codificador de texto cuantizado FP8 (RECOMENDADO para menos VRAM)
@@ -69,7 +71,7 @@ Elige uno de los siguientes:
- Modelo VAE de Wan2.1
+ Modelo VAE Wan2.1
@@ -77,7 +79,7 @@ Elige uno de los siguientes:
- Codificador CLIP Vision
+ Codificador de visión CLIP
@@ -110,7 +112,7 @@ Genera videos dinámicos con movimientos de cámara cinematográficos usando el
Abrir en Comfy Cloud
- Descarga el JSON o busca "Wan 2.1 Fun Camera 1.3B" en la biblioteca de plantillas
+ Descarga el JSON o busca "Wan 2.1 Fun Camera 1.3B" en la Biblioteca de plantillas
@@ -144,12 +146,12 @@ Sube este archivo al nodo `LoadImage` correspondiente:

-1. Verifica que se haya cargado la versión correcta del archivo del modelo:
+1. Asegúrate de que esté cargada la versión correcta del archivo del modelo:
- Versión 1.3B: `wan2.1_fun_camera_v1.1_1.3B_bf16.safetensors`
- Versión 14B: `wan2.1_fun_camera_v1.1_14B_bf16.safetensors`
-2. Verifica que el nodo `Load CLIP` tenga cargado `umt5_xxl_fp8_e4m3fn_scaled.safetensors`
-3. Verifica que el nodo `Load VAE` tenga cargado `wan_2.1_vae.safetensors`
-4. Verifica que el nodo `Load CLIP Vision` tenga cargado `clip_vision_h.safetensors`
+2. Asegúrate de que el nodo `Load CLIP` tenga cargado `umt5_xxl_fp8_e4m3fn_scaled.safetensors`
+3. Asegúrate de que el nodo `Load VAE` tenga cargado `wan_2.1_vae.safetensors`
+4. Asegúrate de que el nodo `Load CLIP Vision` tenga cargado `clip_vision_h.safetensors`
5. Sube el fotograma inicial al nodo `Load Image`
6. Modifica el prompt si vas a usar tu propia imagen de entrada
7. Configura el movimiento de cámara en el nodo `WanCameraEmbedding`
@@ -159,7 +161,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
### Wan 2.1 Fun Camera 14B {#video_wan2.1_fun_camera_v1.1_14B}
-Genera videos de alta calidad con control de cámara avanzado usando el modelo completo de 14B.
+Genera videos de alta calidad con control de cámara avanzado usando el modelo completo 14B.
@@ -184,7 +186,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
- nodo `LoadImage` 52 · `video_wan2.1_fun_camera_v1.1_14B_start_image.jpg`
+ Nodo `LoadImage` 52 · `video_wan2.1_fun_camera_v1.1_14B_start_image.jpg`
@@ -195,7 +197,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
## Referencia de rendimiento
**Versión 1.3B**:
-- A 512x512 de resolución, una RTX 4090 tarda unos 72 segundos en generar 81 frames
+- Con una resolución de 512x512 en una RTX 4090, generar 81 fotogramas tarda unos 72 segundos
**Versión 14B**:
-- Una RTX 4090 de 24 GB de VRAM puede quedarse sin memoria al generar a 512x512 de resolución, y también han aparecido problemas de memoria en una A100 al usar tamaños mayores
+- La RTX 4090 de 24 GB de VRAM puede quedarse sin memoria al generar a una resolución de 512x512, y también se han producido problemas de memoria en la A100 al usar tamaños mayores
diff --git a/es/tutorials/video/wan/fun-control.mdx b/es/tutorials/video/wan/fun-control.mdx
index fc40179236..199cf3a256 100644
--- a/es/tutorials/video/wan/fun-control.mdx
+++ b/es/tutorials/video/wan/fun-control.mdx
@@ -2,32 +2,34 @@
title: "Ejemplos de video con Wan2.1 Fun Control en ComfyUI"
description: "Esta guía muestra cómo usar Wan2.1 Fun Control en ComfyUI para generar videos con videos de control"
sidebarTitle: "Wan2.1 Fun Control"
-translationSourceHash: 2ce972d6
+translationSourceHash: 8b293934
translationFrom: tutorials/video/wan/fun-control.mdx
translationBlockHashes:
"_intro": b7cb8b6d
"About Wan2.1-Fun-Control": 2e562079
+ "Model Installation": 6ee9c5c6
"ComfyUI Native Workflow": 01fc65b5
"Workflow Using Custom Nodes": 8f081a21
"Usage Tips": 9e74c201
---
+
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
Wan2.1-Fun-Control es un modelo de generación de video de código abierto del proyecto VideoX-Fun de Alibaba que sigue condiciones de control predefinidas en lugar de depender únicamente del texto del prompt. Puedes guiar la salida con mapas de bordes Canny, mapas de profundidad, esqueletos OpenPose, bordes geométricos MLSD o trayectorias de puntos.
-El modelo está disponible en dos tamaños: la versión de 1.3B (unos 19 GB) para un despliegue local ligero con menores requisitos de VRAM, y la versión de 14B (unos 47 GB de almacenamiento total del modelo, con los pesos de difusión en unos 32.8 GB) para resultados de mayor calidad. Ambas admiten predicción de video multirresolución a 512, 768 y 1024 píxeles, generan hasta 81 fotogramas (unos 5 segundos) a 16 fotogramas por segundo y aceptan prompts multilingües. ComfyUI ofrece soporte nativo para Wan2.1-Fun-Control.
+El modelo se ofrece en dos tamaños: la versión de 1.3B (unos 19 GB) para un despliegue local ligero con menores requisitos de VRAM, y la versión de 14B (unos 47 GB de almacenamiento total del modelo, con los pesos de diffusion en unos 32.8 GB) para obtener resultados de mayor calidad. Ambas admiten predicción de video multirresolución a 512, 768 y 1024 píxeles, generan hasta 81 fotogramas (unos 5 segundos) a 16 fotogramas por segundo y aceptan prompts multilingües. ComfyUI ofrece soporte nativo para Wan2.1-Fun-Control.
## Acerca de Wan2.1-Fun-Control
**Wan2.1-Fun-Control** es un proyecto de generación y control de video de código abierto desarrollado por el equipo de Alibaba.
-Introduce mecanismos innovadores de códigos de control (Control Codes) combinados con aprendizaje profundo y entradas condicionales multimodales para generar videos de alta calidad que cumplen con condiciones de control predefinidas. El proyecto se centra en guiar con precisión el contenido del video generado mediante condiciones de control multimodales.
+Introduce mecanismos innovadores de Control Codes combinados con aprendizaje profundo y entradas condicionales multimodales para generar videos de alta calidad que se ajustan a condiciones de control predefinidas. El proyecto se centra en guiar con precisión el contenido del video generado mediante condiciones de control multimodales.
-Actualmente, el modelo Fun Control admite diversas condiciones de control, como **Canny (arte lineal), Depth, OpenPose (postura humana), MLSD (bordes geométricos) y control de trayectoria.**
-El modelo también admite predicción de video multirresolución con opciones de 512, 768 y 1024 de resolución a 16 fotogramas por segundo, generando videos de hasta 81 fotogramas (aproximadamente 5 segundos) de duración.
+Actualmente, el modelo Fun Control admite diversas condiciones de control, entre ellas **Canny (arte lineal), Profundidad, OpenPose (postura humana), MLSD (bordes geométricos) y control de trayectoria.**
+El modelo también admite predicción de video multirresolución con opciones de resolución de 512, 768 y 1024 a 16 fotogramas por segundo, generando videos de hasta 81 fotogramas (aproximadamente 5 segundos) de duración.
Versiones del modelo:
-- **1.3B** Ligero: ideal para el despliegue local y la inferencia rápida con **requisitos de VRAM más bajos**
-- **14B** Alto rendimiento: el tamaño del modelo alcanza los 32 GB o más, ofrece mejores resultados pero **requiere más VRAM**
+- **1.3B** Ligera: adecuada para el despliegue local y la inferencia rápida con **requisitos de VRAM más bajos**
+- **14B** De alto rendimiento: el tamaño del modelo alcanza 32GB+, ofrece mejores resultados pero **requiere más VRAM**
**Descarga de los pesos del modelo**:
@@ -36,52 +38,52 @@ Versiones del modelo:
Versión ligera, requisitos de VRAM más bajos
- Versión de alto rendimiento, tamaño del archivo de 32 GB o más, requisitos de VRAM más altos
+ Versión de alto rendimiento, tamaño del archivo de 32GB+, requisitos de VRAM más altos
**Repositorio de código**: [VideoX-Fun](https://github.com/aigc-apps/VideoX-Fun)
-ComfyUI ahora **es compatible de forma nativa** con el modelo Wan2.1 Fun Control. Antes de comenzar este tutorial, actualiza tu ComfyUI para asegurarte de usar una versión posterior a [este commit](https://github.com/Comfy-Org/ComfyUI/commit/3661c833bcc41b788a7c9f0e7bc48524f8ee5f82).
+ComfyUI ahora **es compatible de forma nativa** con el modelo Wan2.1 Fun Control. Antes de comenzar este tutorial, actualiza tu ComfyUI para asegurarte de que usas una versión posterior a [este commit](https://github.com/Comfy-Org/ComfyUI/commit/3661c833bcc41b788a7c9f0e7bc48524f8ee5f82).
En esta guía proporcionamos dos flujos de trabajo:
1. Un flujo de trabajo que usa solo nodos nativos de Comfy Core
-2. Un flujo de trabajo que usa nodos personalizados
+2. Un flujo de trabajo que usa Nodos Personalizados
-Debido a las limitaciones actuales de los nodos nativos para el soporte de video, el flujo de trabajo solo con nodos nativos permite completar el proceso sin instalar nodos personalizados.
+Debido a las limitaciones actuales de los nodos nativos para el soporte de video, el flujo de trabajo solo con nodos nativos garantiza que los usuarios puedan completar el proceso sin instalar nodos personalizados.
Sin embargo, hemos comprobado que ofrecer una buena experiencia de usuario para la generación de video es complicado sin nodos personalizados, así que en esta guía incluimos ambas versiones del flujo de trabajo.
-## Instalación de modelos
+## Instalar los modelos
-Solo tienes que instalar estos modelos una vez. Las imágenes de los flujos de trabajo también contienen la información de descarga de los modelos, así que puedes elegir el método de descarga que prefieras.
+Solo necesitas instalar estos modelos una vez. Las imágenes de los flujos de trabajo también contienen la información de descarga de los modelos, así que puedes elegir el método de descarga que prefieras.
-Los siguientes modelos están disponibles en [Wan_2.1_ComfyUI_repackaged](https://huggingface.co/Comfy-Org/Wan_2.1_ComfyUI_repackaged) y [Wan2.1-Fun](https://huggingface.co/collections/alibaba-pai/wan21-fun-67e4fb3b76ca01241eb7e334)
+Puedes encontrar los siguientes modelos en [Wan_2.1_ComfyUI_repackaged](https://huggingface.co/Comfy-Org/Wan_2.1_ComfyUI_repackaged) y [Wan2.1-Fun](https://huggingface.co/collections/alibaba-pai/wan21-fun-67e4fb3b76ca01241eb7e334)
-Haz clic en los enlaces correspondientes para descargar. Si ya has usado flujos de trabajo de Wan, solo necesitas descargar los **modelos de difusión**.
+Haz clic en los enlaces correspondientes para descargarlos. Si ya has usado flujos de trabajo relacionados con Wan, solo necesitas descargar los **modelos de difusión**.
-**Modelos de difusión** -- elige 1.3B o 14B. La versión 14B tiene un tamaño de archivo mayor (32 GB) y requiere más VRAM:
+**Modelos de difusión**: elige 1.3B o 14B. La versión 14B tiene un tamaño de archivo mayor (32GB) y requiere más VRAM:
- Modelo de difusión Wan2.1 Fun Control 1.3B -- ligero, requiere menos VRAM
+ Modelo de difusión Wan2.1 Fun Control 1.3B: ligero, con menores requisitos de VRAM
- Modelo de difusión Wan2.1 Fun Control 14B. Cámbiale el nombre a Wan2.1-Fun-14B-Control.safetensors después de descargarlo. Archivo de 32 GB o más, requiere más VRAM
+ Modelo de difusión Wan2.1 Fun Control 14B. Renómbralo a Wan2.1-Fun-14B-Control.safetensors después de descargarlo. Tamaño de archivo de 32GB o más, mayores requisitos de VRAM
-**Codificadores de texto** -- elige uno de los siguientes modelos (la precisión fp16 tiene un tamaño mayor y requiere más rendimiento):
+**Codificadores de texto**: elige uno de los siguientes modelos (la precisión fp16 tiene un tamaño mayor y mayores requisitos de rendimiento):
- Codificador de texto UMT5 XXL -- precisión fp16, tamaño mayor, mayor rendimiento
+ Codificador de texto UMT5 XXL: precisión fp16, mayor tamaño, mayor rendimiento
- Codificador de texto UMT5 XXL -- precisión fp8, tamaño menor, requiere menos rendimiento
+ Codificador de texto UMT5 XXL: precisión fp8, menor tamaño, menores requisitos de rendimiento
@@ -95,7 +97,7 @@ Haz clic en los enlaces correspondientes para descargar. Si ya has usado flujos
Modelo CLIP Vision para procesar imágenes de referencia
-Ubicación de almacenamiento de archivos:
+Ubicación de almacenamiento de los archivos:
```
📂 ComfyUI/
├── 📂 models/
@@ -112,12 +114,12 @@ Ubicación de almacenamiento de archivos:
## Flujo de trabajo nativo de ComfyUI
-En este flujo de trabajo usamos videos convertidos a **formato WebP**, ya que el nodo `Load Image` no admite actualmente el formato mp4. También usamos **Canny Edge** para preprocesar el video original.
-Como muchos usuarios se topan con fallos de instalación y problemas de entorno al instalar nodos personalizados, esta versión del flujo de trabajo usa solo nodos nativos para garantizar una experiencia más fluida.
+En este flujo de trabajo usamos videos convertidos a **formato WebP**, ya que el nodo `Load Image` todavía no admite el formato mp4. También usamos **Canny Edge** para preprocesar el video original.
+Como muchos usuarios se encuentran con fallos de instalación y problemas de entorno al instalar nodos personalizados, esta versión del flujo de trabajo usa solo nodos nativos para garantizar una experiencia más fluida.
-Gracias a nuestros potentes autores de ComfyUI, que ofrecen nodos con muchas funciones. Si quieres consultar directamente la versión relacionada, mira [Flujo de trabajo con nodos personalizados](#flujo-de-trabajo-con-nodos-personalizados).
+Gracias a nuestros grandes autores de ComfyUI, que ofrecen nodos con muchas funciones. Si quieres consultar directamente la versión relacionada, ve a [Flujo de trabajo con nodos personalizados](#flujo-de-trabajo-con-nodos-personalizados).
-### 1. Descarga del archivo del flujo de trabajo
+### 1. Descargar el archivo del flujo de trabajo
@@ -141,7 +143,7 @@ Gracias a nuestros potentes autores de ComfyUI, que ofrecen nodos con muchas fun
-### 2. Completa el flujo de trabajo paso a paso
+### 2. Completar el flujo de trabajo paso a paso

@@ -150,37 +152,37 @@ Gracias a nuestros potentes autores de ComfyUI, que ofrecen nodos con muchas fun
3. Asegúrate de que el nodo `Load VAE` haya cargado `wan_2.1_vae.safetensors`
4. Asegúrate de que el nodo `Load CLIP Vision` haya cargado `clip_vision_h.safetensors`
5. Sube el fotograma inicial al nodo `Load Image` (renombrado como `Start_image`)
-6. Sube el video de control al segundo nodo `Load Image`. Nota: este nodo actualmente no admite mp4, solo videos WebP
-7. (Opcional) Modifica el prompt (se admite inglés y chino)
+6. Sube el video de control al segundo nodo `Load Image`. Nota: este nodo no admite mp4 por ahora, solo videos WebP
+7. (Opcional) Modifica el prompt (se admiten inglés y chino)
8. (Opcional) Ajusta el tamaño del video en `WanFunControlToVideo`, evitando dimensiones demasiado grandes
-9. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video
+9. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación del video
### 3. Notas de uso
-- Como debemos introducir en el nodo `WanFunControlToVideo` el mismo número de fotogramas que tiene el video de control, si el número de fotogramas especificado supera los fotogramas reales del video de control, los fotogramas sobrantes pueden mostrar escenas que no se ajustan a las condiciones de control. Abordaremos este problema en [Flujo de trabajo con nodos personalizados](#flujo-de-trabajo-con-nodos-personalizados)
-- Evita establecer dimensiones demasiado grandes, ya que esto puede hacer que el muestreo sea muy lento. Prueba primero con imágenes más pequeñas y luego haz upscale
+- Como debemos introducir en el nodo `WanFunControlToVideo` el mismo número de fotogramas que tiene el video de control, si la cantidad de fotogramas especificada supera la del video de control real, los fotogramas sobrantes pueden mostrar escenas que no se ajustan a las condiciones de control. Abordaremos este problema en [Flujo de trabajo con nodos personalizados](#flujo-de-trabajo-con-nodos-personalizados)
+- Evita establecer dimensiones demasiado grandes, ya que esto puede hacer que el muestreo lleve mucho tiempo. Prueba a generar primero imágenes más pequeñas y luego escálalas
- Usa tu imaginación para ampliar este flujo de trabajo añadiendo flujos de texto a imagen u otros tipos, y lograr así generación directa de texto a video o transferencia de estilo
-- Usa herramientas como [ComfyUI-comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux) para obtener opciones de control más ricas
+- Usa herramientas como [ComfyUI-comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux) para tener opciones de control más variadas
-## Flujo de trabajo con nodos personalizados
+## Flujo de trabajo con Nodos Personalizados
-Necesitaremos instalar los siguientes dos nodos personalizados:
+Necesitas instalar los siguientes dos nodos personalizados:
-- [ComfyUI-VideoHelperSuite](https://github.com/Kosinkadink/ComfyUI-VideoHelperSuite)
+- [ComfyUI-VideoHelperSuite](https://github.com/Kosinkadink/ComfyUI-VideoHelperSuite)
- [ComfyUI-comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux)
-Puedes usar [ComfyUI Manager](https://github.com/Comfy-Org/ComfyUI-Manager) para instalar los nodos faltantes o seguir las instrucciones de instalación de cada paquete de nodos personalizados.
+Puedes usar [ComfyUI Manager](https://github.com/Comfy-Org/ComfyUI-Manager) para instalar nodos faltantes o seguir las instrucciones de instalación de cada paquete de nodos personalizados.
### 1. Descargar el archivo del flujo de trabajo
-
+
- Abrir en Comfy Cloud
+ Open in Comfy Cloud
- Descarga el JSON o busca "Wan 2.1 ControlNet" en la biblioteca de plantillas
+ Descarga el JSON o busca “Wan 2.1 ControlNet” en la Biblioteca de plantillas
@@ -188,7 +190,7 @@ Puedes usar [ComfyUI Manager](https://github.com/Comfy-Org/ComfyUI-Manager) para
- Fotograma inicial de entrada para el flujo de trabajo con nodos personalizados. Descarga y usa esta imagen, o reemplázala por una propia.
+ Fotograma inicial de entrada para el flujo de trabajo con nodos personalizados. Descarga y usa esta imagen, o reemplázala por la tuya.
Video de control de entrada en formato MP4 para el flujo de trabajo con nodos personalizados. El nodo personalizado Load Video admite el formato mp4.
@@ -197,18 +199,18 @@ Puedes usar [ComfyUI Manager](https://github.com/Comfy-Org/ComfyUI-Manager) para
### 2. Completar el flujo de trabajo paso a paso
-
+
-> La parte del modelo es esencialmente la misma. Si ya probaste el flujo de trabajo solo con nodos nativos, puedes subir directamente las imágenes correspondientes y ejecutarlo.
+> La parte de los modelos es prácticamente la misma. Si ya probaste el flujo de trabajo con nodos nativos, puedes subir directamente las imágenes correspondientes y ejecutarlo.
-1. Asegúrate de que el nodo `Load Diffusion Model` haya cargado `wan2.1_fun_control_1.3B_bf16.safetensors`
-2. Asegúrate de que el nodo `Load CLIP` haya cargado `umt5_xxl_fp8_e4m3fn_scaled.safetensors`
-3. Asegúrate de que el nodo `Load VAE` haya cargado `wan_2.1_vae.safetensors`
-4. Asegúrate de que el nodo `Load CLIP Vision` haya cargado `clip_vision_h.safetensors`
+1. Asegúrate de que el nodo `Load Diffusion Model` tenga cargado `wan2.1_fun_control_1.3B_bf16.safetensors`
+2. Asegúrate de que el nodo `Load CLIP` tenga cargado `umt5_xxl_fp8_e4m3fn_scaled.safetensors`
+3. Asegúrate de que el nodo `Load VAE` tenga cargado `wan_2.1_vae.safetensors`
+4. Asegúrate de que el nodo `Load CLIP Vision` tenga cargado `clip_vision_h.safetensors`
5. Sube el fotograma inicial al nodo `Load Image`
6. Sube un video en formato mp4 al nodo personalizado `Load Video(Upload)`. Ten en cuenta que el flujo de trabajo ha ajustado el `frame_load_cap` predeterminado
-7. Para la imagen actual, el `DWPose Estimator` solo usa la opción `detect_face`
-8. (Opcional) Modifica el prompt (se admiten tanto inglés como chino)
+7. Para la imagen actual, `DWPose Estimator` solo usa la opción `detect_face`
+8. (Opcional) Modifica el prompt (se admiten inglés y chino)
9. (Opcional) Ajusta el tamaño del video en `WanFunControlToVideo`, evitando dimensiones demasiado grandes
10. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video
@@ -216,7 +218,7 @@ Puedes usar [ComfyUI Manager](https://github.com/Comfy-Org/ComfyUI-Manager) para
Gracias a los autores de la comunidad de ComfyUI por sus paquetes de nodos personalizados:
- Este ejemplo usa `Load Video(Upload)` para admitir videos mp4
-- El `video_info` que se obtiene de `Load Video(Upload)` nos permite mantener los mismos `fps` en el video de salida
+- El `video_info` que se obtiene de `Load Video(Upload)` permite mantener el mismo `fps` en el video de salida
- Puedes reemplazar `DWPose Estimator` por otros preprocesadores del paquete de nodos `ComfyUI-comfyui_controlnet_aux`
- Los prompts admiten varios idiomas
@@ -224,10 +226,10 @@ Gracias a los autores de la comunidad de ComfyUI por sus paquetes de nodos perso

-- Un consejo útil es que puedes combinar varias técnicas de preprocesamiento de imágenes y luego usar el nodo `Image Blend` para lograr el objetivo de aplicar varios métodos de control al mismo tiempo.
-- Puedes usar el nodo `Video Combine` de `ComfyUI-VideoHelperSuite` para guardar videos en formato mp4
-- Usamos `SaveAnimatedWEBP` porque actualmente no admitimos incrustar el flujo de trabajo en **mp4** y algunos Nodos personalizados también pueden no admitir la incrustación del flujo de trabajo. Para conservar el flujo de trabajo en el video, elegimos el nodo `SaveAnimatedWEBP`.
-- En el nodo `WanFunControlToVideo`, `control_video` no es obligatorio, así que a veces puedes Saltar el uso de un video de control, primero Generar un video de tamaño muy pequeño como 320x320 y luego usarlo como Entrada de video de control para lograr resultados consistentes.
+- Un consejo útil: puedes combinar varias técnicas de preprocesamiento de imágenes y luego usar el nodo `Image Blend` para aplicar varios métodos de control al mismo tiempo.
+- Puedes usar el nodo `Video Combine` de `ComfyUI-VideoHelperSuite` para guardar videos en formato mp4.
+- Usamos `SaveAnimatedWEBP` porque actualmente no admitimos incrustar el flujo de trabajo en **mp4** y es posible que algunos nodos personalizados tampoco lo admitan. Para conservar el flujo de trabajo en el video, elegimos el nodo `SaveAnimatedWEBP`.
+- En el nodo `WanFunControlToVideo`, `control_video` no es obligatorio, así que a veces puedes omitir el video de control: primero genera un video de tamaño muy pequeño, como 320x320, y luego úsalo como entrada de video de control para obtener resultados consistentes.
- [ComfyUI-WanVideoWrapper](https://github.com/kijai/ComfyUI-WanVideoWrapper)
- [ComfyUI-KJNodes](https://github.com/kijai/ComfyUI-KJNodes)
diff --git a/es/tutorials/video/wan/wan-animate-2.mdx b/es/tutorials/video/wan/wan-animate-2.mdx
index 07a6b5786a..b8136aa32c 100644
--- a/es/tutorials/video/wan/wan-animate-2.mdx
+++ b/es/tutorials/video/wan/wan-animate-2.mdx
@@ -2,17 +2,19 @@
title: "Wan Animate 2: transferencia de movimiento"
description: "Anima un personaje estático con Wan Animate 2 en ComfyUI: transfiere el movimiento desde un video guía directamente, sin extracción de poses ni preprocesamiento de esqueleto."
sidebarTitle: "Wan Animate 2"
-translationSourceHash: ae4a191b
+translationSourceHash: 3eded645
translationFrom: tutorials/video/wan/wan-animate-2.mdx
translationBlockHashes:
"_intro": 358b6914
"Model Highlights": ab20a214
+ "Wan Animate 2 workflow": c684e48e
---
+
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx";
-Wan Animate 2 es un framework de animación de personajes de extremo a extremo del equipo de Wan que consume directamente videos guía en un Diffusion Transformer rediseñado. Logra una generación de movimiento de alta fidelidad y una fuerte preservación de la identidad al eliminar los extractores de movimiento intermedios: no se necesita extracción de pose ni preprocesamiento de esqueletos.
+Wan Animate 2 es un framework de animación de personajes de extremo a extremo del equipo de Wan que consume directamente videos de referencia en un Diffusion Transformer rediseñado. Logra una generación de movimiento de alta fidelidad y una fuerte preservación de la identidad al eliminar los extractores de movimiento intermedios: no se necesita extracción de pose ni preprocesamiento de esqueletos.
-El modelo también añade control de perspectiva impulsado por texto, lo que desacopla la perspectiva de la cámara de salida del video de conducción. Esto te permite animar a un personaje estático usando un video de conducción mientras controlas la cámara de forma independiente, e incluso generar un fondo nuevo a partir de tu prompt de texto.
+El modelo también añade control de punto de vista impulsado por texto, lo que desacopla la perspectiva de la cámara de salida del video de referencia. Esto te permite animar un personaje estático usando un video de referencia mientras controlas la cámara de forma independiente, e incluso generar un fondo nuevo a partir de tu prompt de texto.
@@ -20,13 +22,13 @@ El modelo también añade control de perspectiva impulsado por texto, lo que des
- **Transferencia directa de movimiento**: Anima a un personaje estático a partir de un video guía sin extracción de pose ni preprocesamiento de esqueleto
- **Preservación de la identidad**: Mantiene intactas la identidad, la apariencia y los detalles del personaje de referencia
-- **Control de cámara por texto**: Desacopla la perspectiva de la cámara de salida respecto del video guía
+- **Control de cámara mediante texto**: Desacopla la perspectiva de la cámara de salida del video guía
- **Fondos nuevos**: Genera un fondo nuevo a partir de tu prompt de texto en lugar de copiar el fondo del video guía
- **Movimiento de alta fidelidad**: Replica movimientos y expresiones complejas del video guía
## Flujo de trabajo de Wan Animate 2
-Anima un personaje estático con un video guía, transfiriendo el movimiento directamente desde los fotogramas del video. La salida conserva la identidad del personaje de referencia y, al mismo tiempo, genera un fondo nuevo y un movimiento de cámara a partir de tu prompt de texto.
+Anima un personaje estático usando un video guía, transfiriendo el movimiento directamente desde los fotogramas del video. El resultado conserva la identidad del personaje de referencia mientras genera un fondo y un movimiento de cámara nuevos a partir de tu prompt de texto.
@@ -35,7 +37,7 @@ Anima un personaje estático con un video guía, transfiriendo el movimiento dir
Abrir en Comfy Cloud
- Descarga el JSON o busca "Wan Animate 2" en la Biblioteca de plantillas
+ Descarga el JSON o busca "Wan Animate 2" en la biblioteca de plantillas
@@ -45,38 +47,38 @@ Sube estos archivos a los nodos correspondientes:
- Nodo `LoadImage`: pink_hair_mech_arms_ref.png (el personaje que se va a animar)
+ Nodo `LoadImage`: pink_hair_mech_arms_ref.png (el personaje a animar)
Nodo `LoadVideo`: street_dance_drive.mp4 (la fuente del movimiento)
-### Descarga de modelos
+### Descargas de modelos
-Este flujo de trabajo usa el modelo de difusión `wan_animate_2_int8_convrot.safetensors`. El repositorio también incluye variantes BF16 y destiladas; si prefieres usarlas, cambia la selección de modelo en el nodo `UNETLoader`. Todos los archivos están disponibles en el repositorio [Comfy-Org/Wan-Animate-2](https://huggingface.co/Comfy-Org/Wan-Animate-2):
+Este flujo de trabajo usa el modelo de difusión `wan_animate_2_int8_convrot.safetensors`. El repositorio también incluye variantes BF16 y destiladas; si quieres usar esas en su lugar, cambia la selección de modelo en el nodo `UNETLoader`. Todos los archivos están disponibles en el repositorio [Comfy-Org/Wan-Animate-2](https://huggingface.co/Comfy-Org/Wan-Animate-2):
-
- wan_animate_2_int8_convrot.safetensors: Modelo de difusión cuantizado INT8 convrot que usa este flujo de trabajo
+
+ wan_animate_2_int8_convrot.safetensors: modelo de difusión cuantizado INT8 convrot que usa este flujo de trabajo
- wan_animate_2_bf16.safetensors: Modelo base de precisión completa. Requiere cambiar la selección de modelo en UNETLoader.
+ wan_animate_2_bf16.safetensors: modelo base de precisión completa. Requiere cambiar la selección de modelo en UNETLoader.
-
- wan_animate_2_distill_int8_convrot.safetensors: Variante INT8 destilada. Requiere cambiar la selección de modelo en UNETLoader.
+
+ wan_animate_2_distill_int8_convrot.safetensors: variante INT8 destilada. Requiere cambiar la selección de modelo en UNETLoader.
-
- wan_animate_2_distill_bf16.safetensors: Variante BF16 destilada. Requiere cambiar la selección de modelo en UNETLoader.
+
+ wan_animate_2_distill_bf16.safetensors: variante BF16 destilada. Requiere cambiar la selección de modelo en UNETLoader.
lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors: LoRA de aceleración LightX2V
- umt5_xxl_fp8_e4m3fn_scaled.safetensors: Codificador de texto UMT5-XXL FP8
+ umt5_xxl_fp8_e4m3fn_scaled.safetensors: codificador de texto UMT5-XXL FP8
- clip_vision_h.safetensors: Codificador CLIP Vision
+ clip_vision_h.safetensors: codificador CLIP Vision
Wan2_1_VAE_bf16.safetensors: VAE de Wan2.1 para codificar y decodificar
@@ -105,20 +107,21 @@ Coloca los archivos en los siguientes directorios:
### Instrucciones del flujo de trabajo
-1. Asegúrate de que todos los modelos se cargan correctamente
+1. Asegúrate de que todos los modelos se carguen correctamente
2. Sube la imagen de referencia: el personaje de esta imagen es el personaje objetivo que se va a animar
-3. Sube el video guía: su movimiento se transfiere al personaje de referencia
+3. Sube el video de conducción: su movimiento se transfiere al personaje de referencia
4. Actualiza el prompt para describir la escena, el fondo y el movimiento de cámara que quieres
5. Haz clic en `Run` o usa el atajo `Ctrl(cmd) + Enter` para generar el video
### Extender a videos más largos
-Los videos más largos se gestionan dentro del flujo de trabajo: el Subgraph `Motion Transfer (Wan Animate 2)` itera (`StartLoop` / `EndLoop`) y sigue generando hasta cubrir todo el video guía, así que con un solo Subgraph es suficiente. No hay que duplicar ni recablear nada.
+Los videos más largos se manejan dentro del flujo de trabajo: el subgrafo `Motion Transfer (Wan Animate 2)` hace un bucle (`StartLoop` / `EndLoop`) y sigue generando hasta cubrir todo el video de origen, así que con un solo subgrafo basta. No hay que duplicar ni recablear nada.
+
+Cada iteración del bucle genera 81 fotogramas, unos 3.4 segundos a 24 fps. Ese es el valor de `Int (fragment_length)` dentro del subgrafo. Puedes aumentarlo, pero debe seguir siendo una longitud válida de Wan: 81, 85, 89, etcétera, es decir, `4n + 1`.
-Cada iteración del bucle genera 81 fotogramas, unos 3.4 segundos a 24 fps. Ese es el valor `Int (fragment_length)` dentro del Subgraph. Puedes aumentarlo, pero debe mantenerse en una longitud válida de Wan: 81, 85, 89, etcétera, es decir, `4n + 1`.
+El cálculo del bucle lee la cantidad de fotogramas del video de origen, determina cuántas continuaciones hacen falta y recorta el final para que la salida tenga exactamente la misma cantidad de fotogramas que el video de origen. Cada continuación repite el último fotograma del segmento anterior y ese duplicado se elimina, así que cada segmento adicional añade `fragment_length - 1` fotogramas nuevos.
-El cálculo del bucle lee el número de fotogramas del video guía, determina cuántas continuaciones hacen falta y recorta el final para que la salida tenga exactamente los mismos fotogramas que el video guía. Cada continuación repite el último fotograma del segmento anterior y ese duplicado se elimina, así que cada segmento adicional añade `fragment_length - 1` fotogramas nuevos.
+El bucle usa los nodos de bucle del núcleo, así que el flujo de trabajo necesita ComfyUI 0.36.0 o posterior.
-El bucle usa los nodos de bucle del núcleo, así que el flujo de trabajo necesita ComfyUI 0.36.0 o superior.
+El subgrafo `Video Stitch` es la vista previa comparativa: coloca el video generado junto al video de origen. No forma parte del proceso de extensión.
-El Subgraph `Video Stitch` es la vista previa comparativa: coloca el video generado junto al video guía. No forma parte de la ruta de extensión.
diff --git a/es/tutorials/video/wan/wan-causal-forcing.mdx b/es/tutorials/video/wan/wan-causal-forcing.mdx
index 342ce69dae..271280192a 100644
--- a/es/tutorials/video/wan/wan-causal-forcing.mdx
+++ b/es/tutorials/video/wan/wan-causal-forcing.mdx
@@ -2,17 +2,19 @@
title: "Causal Forcing en ComfyUI: imagen a video con Wan2.1 en 1 a 4 pasos"
description: "Genera video temporalmente consistente desde una sola imagen en ComfyUI con Causal Forcing o Causal Forcing++ sobre Wan2.1, usando tan solo 1 a 4 pasos."
sidebarTitle: "Causal Forcing I2V"
-translationSourceHash: 4cd31faf
+translationSourceHash: e94bf5dc
translationFrom: tutorials/video/wan/wan-causal-forcing.mdx
translationBlockHashes:
"_intro": 3da76367
"How it works": a3348b35
"Using the workflow": 5e6245a2
"Steps to run": 3202924b
+ "Model downloads": c6ce079e
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-**Causal Forcing** es una técnica de generación de video que aplica **conditioning recurrente** durante la inferencia, en la que cada fotograma generado se devuelve al modelo para predecir el siguiente fotograma. Así se obtienen videos suaves y coherentes en el tiempo a partir de una sola imagen inicial en tan solo **1 a 4 pasos de inferencia**.
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
+
+**Causal Forcing** es una técnica de generación de video que aplica **acondicionamiento recurrente** durante la inferencia, donde cada fotograma generado se devuelve al modelo para predecir el siguiente fotograma. Esto produce videos suaves y coherentes en el tiempo a partir de una sola imagen inicial en tan solo **1 a 4 pasos de inferencia**.
Este flujo de trabajo usa **Wan2.1** y admite tanto el modo **Causal Forcing** (estándar) como **Causal Forcing++** (mejorado).
@@ -33,7 +35,7 @@ Este flujo de trabajo usa **Wan2.1** y admite tanto el modo **Causal Forcing** (
- Imagen de entrada para el primer fotograma. Descárgala y úsala, o reemplázala por una tuya.
+ Imagen de entrada para el primer fotograma. Descarga y usa esta imagen, o reemplázala con una tuya.
@@ -48,15 +50,15 @@ A diferencia de la generación de video estándar, que procesa todos los fotogra
Este enfoque recurrente crea una **fuerte consistencia temporal**: cada fotograma surge de forma natural del anterior. Esto puede producir resultados de alta calidad con muy pocos pasos de inferencia (de 1 a 4).
-
+
Este flujo de trabajo usa un nodo Subgraph para el procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y extender el flujo de trabajo.
### Causal Forcing vs Causal Forcing++
| Modo | Descripción |
|---|---|
-| **Causal Forcing** | conditioning recurrente estándar. Buena calidad con 2–4 pasos. |
-| **Causal Forcing++** | Modo mejorado que aplica conditioning adicional para una mejor coherencia temporal. Funciona bien con solo 1–2 pasos. |
+| **Causal Forcing** | Acondicionamiento recurrente estándar. Buena calidad con 2–4 pasos. |
+| **Causal Forcing++** | Modo mejorado que aplica acondicionamiento adicional para una mejor coherencia temporal. Funciona bien con solo 1–2 pasos. |
## Usar el flujo de trabajo
@@ -67,12 +69,12 @@ El flujo de trabajo acepta una sola imagen de entrada (el primer fotograma) y un
| Ajuste | Descripción |
|---|---|
| **first_frame** (requerido) | La imagen inicial del video. Carga un PNG/JPG con el nodo **LoadImage**. |
-| **positive_prompt** (opcional) | Una descripción de texto del contenido de video deseado. Déjalo vacío para no aplicar conditioning. |
+| **positive_prompt** (opcional) | Una descripción de texto del contenido de video deseado. Déjalo vacío para no aplicar acondicionamiento. |
| **duration** (opcional) | El número de fotogramas a generar. Predeterminado: el número de fotogramas de la salida esperada del modelo. |
### Parámetros del subgrafo WAN I2V
-Se exponen como controles en el nodo del subgrafo del plano:
+El nodo del subgrafo del plano los expone como controles:
| Parámetro | Predeterminado | Descripción |
|---|---|---|
@@ -86,15 +88,15 @@ Se exponen como controles en el nodo del subgrafo del plano:
## Pasos para ejecutar
1. **Carga una imagen**: usa el nodo **LoadImage** para cargar tu fotograma inicial
-2. **Escribe un prompt** (opcional): describe el contenido de video que deseas
+2. **Escribe un prompt** (opcional): describe el contenido del video que deseas
3. **Establece la duración**: cuántos fotogramas generar
4. **Selecciona los modelos**: elige el checkpoint, CLIP y VAE de Wan2.1 I2V
5. **Elige el modo**: Causal Forcing o Causal Forcing++ (configúralo mediante la configuración interna del subgrafo o una entrada específica de Causal Forcing si está disponible)
6. **Ejecuta**: los fotogramas se generarán de forma secuencial y se guardarán en `ComfyUI/output/`
-## Descarga de modelos
+## Descargas de modelos
-Descarga el modelo Wan2.1 I2V y los archivos necesarios. Colócalos en los subdirectorios correspondientes de `models/`.
+Descarga el modelo Wan2.1 I2V y los archivos requeridos. Colócalos en las subcarpetas correspondientes de `models/`.
### Wan2.1 I2V
@@ -118,7 +120,7 @@ Descarga el modelo Wan2.1 I2V y los archivos necesarios. Colócalos en los subdi
-### Ubicación de almacenamiento de modelos
+### Ubicación de almacenamiento de los modelos
```
📂 ComfyUI/
@@ -130,3 +132,4 @@ Descarga el modelo Wan2.1 I2V y los archivos necesarios. Colócalos en los subdi
│ └── 📂 vae/
│ └── Wan2.1_VAE_bf16.safetensors
```
+
diff --git a/es/tutorials/video/wan/wan-move.mdx b/es/tutorials/video/wan/wan-move.mdx
index 205659fc86..9f5a576d9a 100644
--- a/es/tutorials/video/wan/wan-move.mdx
+++ b/es/tutorials/video/wan/wan-move.mdx
@@ -2,26 +2,28 @@
title: "Ejemplo de flujo de trabajo Wan-Move en ComfyUI"
description: "Genera video con movimiento controlable usando Wan-Move en ComfyUI: guía el movimiento de objetos con trayectorias de puntos para imagen a video."
sidebarTitle: "Wan-Move"
-translationSourceHash: 78cfc130
+translationSourceHash: 6e632abd
translationFrom: tutorials/video/wan/wan-move.mdx
translationBlockHashes:
"_intro": 67a26359
"Wan-Move image-to-video workflow": 78aef00b
+ "Model links": 8e0ef166
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-**Wan-Move** es un framework de generación de video con control de movimiento desarrollado por Tongyi Lab de Alibaba. Permite controlar el movimiento de los objetos en los videos generados especificando trayectorias de puntos sobre la imagen de entrada, lo que hace que la generación de imagen a video sea más precisa y controlable.
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
+
+**Wan-Move** es un framework de generación de video con control de movimiento desarrollado por Tongyi Lab de Alibaba. Te permite controlar el movimiento de los objetos en los videos generados especificando trayectorias de puntos sobre la imagen de entrada, lo que hace que la generación de imagen a video sea más precisa y controlable.
**Características principales**:
-- **Control de movimiento en 480p y 5 s de alta calidad**: genera videos de 5 segundos en 480p con una controlabilidad de movimiento de grano fino
-- **Orientación por trayectorias latent**: representa las condiciones de movimiento propagando las características del primer fotograma a lo largo de las trayectorias
-- **Control de grano fino a nivel puntual**: los movimientos de los objetos se representan con trayectorias de puntos densas, lo que permite un control preciso a nivel de región
+- **Control de movimiento de alta calidad en 5 s y 480p**: genera videos de 5 segundos en 480p con una controlabilidad de movimiento de grano fino
+- **Orientación por trayectorias latentes**: representa las condiciones de movimiento propagando las características del primer fotograma a lo largo de las trayectorias
+- **Control de grano fino a nivel puntual**: el movimiento de los objetos se representa con trayectorias de puntos densas, lo que permite un control preciso a nivel de región
- **Sin cambios en la arquitectura**: se integra sin problemas en Wan-I2V-14B sin módulos de movimiento adicionales
**Enlaces relacionados**:
- [GitHub](https://github.com/ali-vilab/Wan-Move)
- [Hugging Face](https://huggingface.co/Ruihang/Wan-Move-14B-480P)
-- [Paper](https://arxiv.org/abs/2512.08765)
+- [Artículo](https://arxiv.org/abs/2512.08765)
## Flujo de trabajo de imagen a video Wan-Move
@@ -58,23 +60,23 @@ Sube este archivo al nodo `LoadImage` correspondiente:
- Colócalo en ComfyUI/models/diffusion_models/
+ Coloca el archivo en ComfyUI/models/diffusion_models/
- Colócalo en ComfyUI/models/loras/
+ Coloca el archivo en ComfyUI/models/loras/
-
- Colócalo en ComfyUI/models/text_encoders/
+
+ Coloca el archivo en ComfyUI/models/text_encoders/
- Colócalo en ComfyUI/models/clip_vision/
+ Coloca el archivo en ComfyUI/models/clip_vision/
- Colócalo en ComfyUI/models/vae/
+ Coloca el archivo en ComfyUI/models/vae/
-**Ubicación de almacenamiento de modelos**
+**Ubicación de almacenamiento de los modelos**
```
📂 ComfyUI/
@@ -90,3 +92,4 @@ Sube este archivo al nodo `LoadImage` correspondiente:
│ └── 📂 vae/
│ └── wan_2.1_vae.safetensors
```
+
diff --git a/es/tutorials/video/wan/wan2-2-animate.mdx b/es/tutorials/video/wan/wan2-2-animate.mdx
index 655eded00d..874b81e393 100644
--- a/es/tutorials/video/wan/wan2-2-animate.mdx
+++ b/es/tutorials/video/wan/wan2-2-animate.mdx
@@ -2,20 +2,22 @@
title: "Flujo de trabajo nativo de ComfyUI para Wan2.2 Animate"
description: "Marco unificado de animación y reemplazo de personajes con replicación precisa de movimiento y expresión."
sidebarTitle: "Wan2.2 Animate"
-translationSourceHash: f66a9a5c
+translationSourceHash: 081a4697
translationFrom: tutorials/video/wan/wan2-2-animate.mdx
translationBlockHashes:
"_intro": 96eb0424
"Model Highlights": fc4e7349
"ComfyOrg Wan2.2 Animate stream replay": a43ba31b
+ "About Wan2.2 Animate workflow": 71233e1e
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-Wan-Animate es un marco unificado para animar y reemplazar personajes, desarrollado por el equipo de WAN.
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
+
+Wan-Animate es un marco unificado para la animación y el reemplazo de personajes, desarrollado por el equipo de WAN.
El modelo puede animar cualquier personaje a partir del video de un intérprete, replicando con precisión sus expresiones faciales y sus movimientos para generar videos de personajes muy realistas.
-También puede reemplazar los personajes de un video por personajes animados, conservando sus expresiones y movimientos y replicando la iluminación y el tono de color originales para lograr una integración perfecta con el entorno.
+También puede reemplazar los personajes de un video por personajes animados, conservando sus expresiones y movimientos y replicando la iluminación y el tono de color originales para una integración fluida con el entorno.
## Aspectos destacados del modelo
@@ -23,7 +25,7 @@ También puede reemplazar los personajes de un video por personajes animados, co
- Control avanzado del movimiento corporal: utiliza señales de esqueleto alineadas espacialmente para replicar con precisión el movimiento del cuerpo.
- Movimiento y expresión precisos: reproduce con exactitud los movimientos y las expresiones faciales del video de referencia.
- Integración natural con el entorno: combina a la perfección el personaje reemplazado con el entorno del video original.
-- Generación fluida de videos largos: la generación iterativa garantiza un movimiento y un flujo visual consistentes en videos extensos.
+- Generación fluida de videos largos: la generación iterativa garantiza un movimiento y un flujo visual constantes en videos extensos.
## Repetición del stream de ComfyOrg Wan2.2 Animate
@@ -38,15 +40,15 @@ También puede reemplazar los personajes de un video por personajes animados, co
-## Acerca del flujo de trabajo de Wan2.2 Animate
+## Acerca del flujo de trabajo Wan2.2 Animate
-Este flujo de trabajo admite dos modos: Mix (reemplaza un personaje de un video por el personaje de una imagen de referencia) y Move (anima un personaje usando el movimiento de un video de entrada).
+Este flujo de trabajo admite dos modos: Mix (reemplaza a un personaje de un video con un personaje de una imagen de referencia) y Move (anima a un personaje usando el movimiento de un video de entrada).
-### Wan2.2 Animate, Character Animation and Replacement {#video_wan2_2_14B_animate}
+### Wan2.2 Animate, animación y reemplazo de personajes {#video_wan2_2_14B_animate}
-Marco unificado de animación y reemplazo de personajes, con replicación precisa del movimiento y de las expresiones.
+Framework unificado de animación y reemplazo de personajes con replicación precisa de movimiento y expresiones.
-
+
@@ -63,10 +65,10 @@ Sube estos archivos a los nodos correspondientes:
- `LoadImage` nodo 10 · `video_wan2_2_14B_animate_reference_image.png`
+ Nodo `LoadImage` 10 · `video_wan2_2_14B_animate_reference_image.png`
- `LoadVideo` nodo 145 · `video_wan2_2_14B_animate_original_video.mp4`
+ Nodo `LoadVideo` 145 · `video_wan2_2_14B_animate_original_video.mp4`
@@ -76,23 +78,23 @@ Sube estos archivos a los nodos correspondientes:
### 2. Enlaces de modelos
-Todos los modelos que se usan en esta guía están [aquí](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/tree/main/split_files).
+Todos los modelos que se usan en esta guía están disponibles [aquí](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/tree/main/split_files).
**Modelos de difusión**
- Wan2_2-Animate-14B_fp8_e4m3fn_scaled_KJ.safetensors: Versión FP8 escalada del repositorio de Kijai
+ Wan2_2-Animate-14B_fp8_e4m3fn_scaled_KJ.safetensors: versión FP8 escalada del repositorio de Kijai
- wan2.2_animate_14B_bf16.safetensors: Pesos originales del modelo en bf16
+ wan2.2_animate_14B_bf16.safetensors: pesos originales del modelo en bf16
**CLIP Vision**
- clip_vision_h.safetensors: Codificador CLIP Vision
+ clip_vision_h.safetensors: codificador CLIP Vision
**LoRAs**
@@ -107,7 +109,7 @@ Todos los modelos que se usan en esta guía están [aquí](https://huggingface.c
**Codificadores de texto**
- umt5_xxl_fp8_e4m3fn_scaled.safetensors: Codificador de texto FP8 escalado
+ umt5_xxl_fp8_e4m3fn_scaled.safetensors: codificador de texto FP8 escalado
```
ComfyUI/
@@ -125,11 +127,11 @@ ComfyUI/
│ └── wan_2.1_vae.safetensors
```
-### 3. Instala los nodos personalizados
+### 3. Instalar nodos personalizados
-Descarga el siguiente archivo de flujo de trabajo y arrástralo a ComfyUI para cargarlo; si tienes instalado [ComfyUI-Manager](https://github.com/Comfy-Org/ComfyUI-Manager), basta con hacer clic en el botón `Install missing nodes` para instalar los nodos que falten.
+Descarga el siguiente archivo de flujo de trabajo y arrástralo a ComfyUI para cargar el flujo de trabajo. Si tienes [ComfyUI-Manager](https://github.com/Comfy-Org/ComfyUI-Manager) instalado, puedes hacer clic en el botón `Install missing nodes` para instalar los nodos faltantes.
-Necesitamos instalar los siguientes nodos personalizados:
+Necesitas instalar los siguientes nodos personalizados:
- [ComfyUI-KJNodes](https://github.com/kijai/ComfyUI-KJNodes)
- [ComfyUI-comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux)
@@ -138,30 +140,31 @@ Si no sabes cómo instalar nodos personalizados, consulta [Cómo instalar nodos
### 4. Instrucciones del flujo de trabajo
-Wan2.2 Animate tiene dos modos: Mix y Move
-- Mix: usa la imagen de referencia para reemplazar el personaje del video
-- Move: usa el movimiento del personaje del video de entrada para animar el personaje de la imagen de referencia (como en Wan2.2 Fun Control)
+Wan2.2 Animate tiene dos modos: Mix y Move.
+- Mix: usa la imagen de referencia para reemplazar al personaje en el video.
+- Move: usa el movimiento del personaje del video de entrada para animar al personaje de la imagen de referencia (como en Wan2.2 Fun Control).
#### 4.1 Modo Mix
-
-
-0. Si es la primera vez que ejecutas este flujo de trabajo, usa un tamaño pequeño para la generación de video, por si no tienes suficiente VRAM para ejecutarlo; además, por la limitación de `WanAnimateToVideo`, el ancho y el alto del video deben ser múltiplos de 16.
-1. Asegúrate de que todos los modelos se cargan correctamente
-2. Actualiza el prompt si quieres
-3. Sube la imagen de referencia: el personaje de esta imagen será el personaje objetivo
-4. La primera vez puedes usar los videos que proporcionamos como videos de entrada; el nodo **DWPose Estimator** de [comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux) preprocesará el video de entrada para obtener videos de control de pose y de rostro
-5. El nodo `Points Editor` viene de [KJNodes](https://github.com/kijai/ComfyUI-KJNodes/); por defecto no carga el primer fotograma del video de entrada, así que debes ejecutar el flujo de trabajo una vez o subir el primer fotograma manualmente
- - Debajo del nodo `Points Editor` hemos añadido una nota sobre cómo funciona este nodo y cómo editarlo. Consúltala
-6. El grupo "Video Extend" sirve para ampliar la duración del video de salida
- - Cada `Video Extend` amplía otros 77 fotogramas (alrededor de 4.8125 segundos)
- - Si tu video de entrada dura menos de 5 s, puede que no lo necesites
- - Si quieres ampliar más, tienes que copiar y pegar varias veces y enlazar el `batch_images` del último Video Extend con el siguiente, y también el `video_frame_offset` del último Video Extend con el siguiente
-7. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación del video
+
+
+0. Si ejecutas este flujo de trabajo por primera vez, usa un tamaño pequeño para la generación de video, en caso de que no tengas suficiente VRAM para ejecutarlo y, debido a la limitación de `WanAnimateToVideo`, el ancho o el alto del video deben ser múltiplos de 16.
+1. Asegúrate de que todos los modelos estén cargados correctamente.
+2. Actualiza el prompt si quieres.
+3. Sube la imagen de referencia; el personaje de esta imagen será el personaje objetivo.
+4. Puedes usar los videos que proporcionamos como videos de entrada la primera vez; el nodo **DWPose Estimator** en [comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux) preprocesará el video de entrada para obtener videos de control de pose y rostro.
+5. El `Points Editor` es de [KJNodes](https://github.com/kijai/ComfyUI-KJNodes/); de forma predeterminada, este nodo no cargará el primer fotograma del video de entrada, por lo que debes ejecutar el flujo de trabajo una vez o subir el primer fotograma manualmente.
+ - Debajo del nodo `Points Editor`, hemos añadido una nota sobre cómo funciona este nodo y cómo editarlo. Consúltala.
+6. El grupo "Video Extend" sirve para extender la duración del video de salida.
+ - Cada `Video Extend` extenderá otros 77 fotogramas (alrededor de 4.8125 segundos).
+ - Si tu video de entrada dura menos de 5s, es posible que no lo necesites.
+ - Si quieres extenderlo más, debes copiar y pegar varias veces; debes conectar el `batch_images` del último Video Extend con el siguiente, y también el `video_frame_offset` del último Video Extend con el siguiente.
+7. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video.
#### 4.2 Modo Move
-Usamos [Subgraph](/es/interface/features/subgraph) en el flujo de trabajo de Wan2.2 Animate; así es como se cambia al modo Move:
+Usamos [subgraph](/es/interface/features/subgraph) en el flujo de trabajo Wan2.2 Animate; así puedes cambiar al modo Move:

Si quieres cambiar al modo Move, puedes desconectar las entradas `background_video` y `character_mask` del nodo `Video Sampling and output(Subgraph)`.
+
diff --git a/es/tutorials/video/wan/wan2-2-fun-control.mdx b/es/tutorials/video/wan/wan2-2-fun-control.mdx
index 3947252f37..58ab19287e 100644
--- a/es/tutorials/video/wan/wan2-2-fun-control.mdx
+++ b/es/tutorials/video/wan/wan2-2-fun-control.mdx
@@ -2,22 +2,24 @@
title: "Wan2.2 Fun Control en ComfyUI: generación de video con control"
description: "Ejecuta el flujo de trabajo Wan2.2 Fun Control 14B en ComfyUI para generar video guiado por un video de control, con modelos de alto y bajo ruido y LoRAs de 4 pasos."
sidebarTitle: "Wan2.2 Fun Control"
-translationSourceHash: 5fe96707
+translationSourceHash: 713ec1d8
translationFrom: tutorials/video/wan/wan2-2-fun-control.mdx
translationBlockHashes:
"_intro": 239e24b6
"ComfyOrg Wan2.2 Fun InP & Control Youtube Live Stream Replay": 22557a2e
+ "Wan2.2 Fun Control Video Generation Workflow Example": 0a502468
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-**Wan2.2-Fun-Control** es un modelo de generación y control de video de nueva generación lanzado por el equipo de Alibaba PAI. Mediante un innovador mecanismo de Control Codes combinado con aprendizaje profundo y entradas condicionales multimodales, puede generar videos de alta calidad que cumplen con condiciones de control predefinidas. El modelo se publica bajo la **licencia Apache 2.0** y admite uso comercial.
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
+
+**Wan2.2-Fun-Control** es un modelo de generación y control de video de nueva generación lanzado por el equipo de Alibaba PAI. Gracias a un innovador mecanismo de Control Codes combinado con aprendizaje profundo y entradas condicionales multimodales, puede generar videos de alta calidad que respetan las condiciones de control predefinidas. El modelo se publica bajo la **licencia Apache 2.0** y admite uso comercial.
**Características principales**:
- **Control multimodal**: admite varias condiciones de control, como **Canny (arte lineal)**, **Profundidad**, **OpenPose (pose humana)**, **MLSD (bordes geométricos)** y **control de trayectoria**
- **Generación de video de alta calidad**: basado en la arquitectura Wan2.2, produce videos con calidad cinematográfica
- **Compatibilidad con varios idiomas**: admite prompts en varios idiomas, incluidos el chino y el inglés
-A continuación se muestran los pesos del modelo y los repositorios de código relevantes:
+A continuación, los pesos del modelo y los repositorios de código relevantes:
- [🤗Wan2.2-Fun-A14B-Control](https://huggingface.co/alibaba-pai/Wan2.2-Fun-A14B-Control)
- Repositorio de código: [VideoX-Fun](https://github.com/aigc-apps/VideoX-Fun)
@@ -37,23 +39,23 @@ A continuación se muestran los pesos del modelo y los repositorios de código r
Este flujo de trabajo ofrece dos versiones:
-1. Una versión con el LoRA de 4 pasos [Wan2.2-Lightning](https://huggingface.co/lightx2v/Wan2.2-Lightning) de lightx2v: puede provocar cierta pérdida de dinamismo en el video, pero ofrece mayor velocidad
+1. Una versión que usa el LoRA de 4 pasos de [Wan2.2-Lightning](https://huggingface.co/lightx2v/Wan2.2-Lightning) de lightx2v: puede causar cierta pérdida en el dinamismo del video, pero ofrece mayor velocidad
2. Una versión fp8_scaled sin LoRA de aceleración
-A continuación se muestran los resultados de las pruebas con una GPU RTX4090D de 24 GB de VRAM a una resolución de 640×640 con 81 fotogramas
+Estos son los resultados de las pruebas con una GPU RTX4090D de 24 GB de VRAM a una resolución de 640×640 con 81 fotogramas:
-| Tipo de modelo | Uso de VRAM | Tiempo de la primera generación | Tiempo de la segunda generación |
-| ------------------------ | ---------- | -------------------- | --------------------- |
-| fp8_scaled | 83% | ≈ 524s | ≈ 520s |
-| fp8_scaled + 4-step LoRA | 89% | ≈ 138s | ≈ 79s |
+| Tipo de modelo | Uso de VRAM | Tiempo de primera generación | Tiempo de segunda generación |
+| ------------------------ | ----------- | ---------------------------- | ---------------------------- |
+| fp8_scaled | 83% | ≈ 524s | ≈ 520s |
+| fp8_scaled + LoRA de 4 pasos | 89% | ≈ 138s | ≈ 79s |
-Como el LoRA de 4 pasos ofrece una mejor experiencia a quienes usan el flujo de trabajo por primera vez, aunque puede provocar cierta pérdida de dinamismo en el video, hemos activado por defecto la versión con LoRA de aceleración. Si quieres activar el otro flujo de trabajo, selecciónalo y usa **Ctrl+B** para habilitarlo.
+Como el LoRA de 4 pasos ofrece una mejor experiencia a quienes usan el flujo de trabajo por primera vez, pero puede causar cierta pérdida en el dinamismo del video, hemos habilitado la versión con LoRA de aceleración de forma predeterminada. Si quieres habilitar el otro flujo de trabajo, selecciónalo y usa **Ctrl+B** para activarlo.
-### 1. Descarga el flujo de trabajo y los materiales
+### 1. Descargar el flujo de trabajo y los materiales
-Actualiza tu ComfyUI a la última versión, luego descarga el archivo del flujo de trabajo y arrástralo a ComfyUI, o busca "Wan2.2 Fun Control" en la Biblioteca de plantillas en `Workflow` → `Browse Templates` → `Video`.
+Actualiza tu ComfyUI a la última versión y luego descarga el archivo del flujo de trabajo y arrástralo a ComfyUI, o busca "Wan2.2 Fun Control" en la Biblioteca de plantillas, en `Workflow` → `Browse Templates` → `Video`.
-
+
@@ -73,42 +75,42 @@ Descarga las siguientes imágenes y videos como materiales de entrada.
Fotograma inicial para la generación del video. Descarga y usa esta imagen, o reemplázala por la tuya.
- Video de control de pose ya preprocesado. Descarga y usa este video, o reemplázalo por el tuyo.
+ Video de control de pose preprocesado. Descarga y usa este video, o reemplázalo por el tuyo.
-> Aquí usamos un video ya preprocesado.
+> Aquí usamos un video preprocesado.
### 2. Modelos
-Todos los modelos que se usan en esta guía están [aquí](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/tree/main/split_files).
+Puedes encontrar todos los modelos de esta guía [aquí](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/tree/main/split_files).
**Modelos de difusión**
- wan2.2_fun_control_high_noise_14B_fp8_scaled.safetensors: Modelo de difusión de alto ruido
+ wan2.2_fun_control_high_noise_14B_fp8_scaled.safetensors: Modelo de difusión de ruido alto
- wan2.2_fun_control_low_noise_14B_fp8_scaled.safetensors: Modelo de difusión de bajo ruido
+ wan2.2_fun_control_low_noise_14B_fp8_scaled.safetensors: Modelo de difusión de ruido bajo
-**LoRA Wan2.2-Lightning (opcional, para acelerar)**
+**LoRA Wan2.2-Lightning (opcional, para aceleración)**
-
- wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors: LoRA de aceleración de 4 pasos para alto ruido
+
+ wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors: LoRA de aceleración de 4 pasos para ruido alto
-
- wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors: LoRA de aceleración de 4 pasos para bajo ruido
+
+ wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors: LoRA de aceleración de 4 pasos para ruido bajo
**VAE**
- wan_2.1_vae.safetensors: VAE de Wan2.1 para codificar y decodificar
+ wan_2.1_vae.safetensors: VAE Wan2.1 para codificar y decodificar
**Codificador de texto**
@@ -132,27 +134,28 @@ ComfyUI/
### 3. Guía del flujo de trabajo
-
+
- Este flujo de trabajo usa LoRA. Asegúrate de que el modelo de difusión y el LoRA correspondientes estén emparejados: los modelos y LoRA de alto ruido y de bajo ruido deben usarse de forma correspondiente.
+ Este flujo de trabajo usa LoRA. Asegúrate de que el modelo de difusión y la LoRA correspondientes coincidan: los modelos y las LoRA de ruido alto y ruido bajo deben usarse de forma correspondiente.
-1. Carga del modelo de **alto ruido** y del **LoRA**
+1. Carga del modelo de **ruido alto** y de la **LoRA**
- Asegúrate de que el nodo `Load Diffusion Model` cargue el modelo `wan2.2_fun_control_high_noise_14B_fp8_scaled.safetensors`
- - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue el `wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors`
-2. Carga del modelo de **bajo ruido** y del **LoRA**
+ - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue `wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors`
+2. Carga del modelo de **ruido bajo** y de la **LoRA**
- Asegúrate de que el nodo `Load Diffusion Model` cargue el modelo `wan2.2_fun_control_low_noise_14B_fp8_scaled.safetensors`
- - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue el `wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors`
+ - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue `wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors`
3. Asegúrate de que el nodo `Load CLIP` cargue el modelo `umt5_xxl_fp8_e4m3fn_scaled.safetensors`
4. Asegúrate de que el nodo `Load VAE` cargue el modelo `wan_2.1_vae.safetensors`
5. Sube el fotograma inicial en el nodo `Load Image`
-6. En el segundo nodo `Load video`, carga el video de control de pose. El video que se proporciona ya está preprocesado y puedes usarlo directamente
-7. Como proporcionamos un video de pose ya preprocesado, hay que desactivar el nodo de preprocesamiento de imagen de video correspondiente. Puedes seleccionarlo y usar `Ctrl + B` para desactivarlo
+6. En el segundo nodo `Load video`, carga el video de control de pose. El video proporcionado ya está preprocesado y puedes usarlo directamente
+7. Dado que proporcionamos un video de pose preprocesado, debes deshabilitar el nodo correspondiente de preprocesamiento de imágenes de video. Puedes seleccionarlo y usar `Ctrl + B` para deshabilitarlo
8. Modifica el prompt: puedes usar tanto chino como inglés
-9. En `Wan22FunControlToVideo`, modifica las dimensiones del video. Por defecto se usa una resolución de 640×640 para evitar tiempos de procesamiento excesivos en equipos con poca VRAM
-10. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter`, para ejecutar la generación del video
+9. En `Wan22FunControlToVideo`, modifica las dimensiones del video. La resolución predeterminada es de 640×640 para evitar tiempos de procesamiento excesivos en usuarios con poca VRAM
+10. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video
### Notas adicionales
-Como los nodos integrados de ComfyUI solo incluyen el preprocesador Canny, puedes usar herramientas como [ComfyUI-comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux) para aplicar otros tipos de preprocesamiento de imagen
+Como los nodos integrados de ComfyUI solo incluyen el preprocesador Canny, puedes usar herramientas como [ComfyUI-comfyui_controlnet_aux](https://github.com/Fannovel16/comfyui_controlnet_aux) para implementar otros tipos de preprocesamiento de imágenes.
+
diff --git a/es/tutorials/video/wan/wan2-2-fun-inp.mdx b/es/tutorials/video/wan/wan2-2-fun-inp.mdx
index 8b198033cd..55e805e3fc 100644
--- a/es/tutorials/video/wan/wan2-2-fun-inp.mdx
+++ b/es/tutorials/video/wan/wan2-2-fun-inp.mdx
@@ -2,25 +2,27 @@
title: "Wan2.2 Fun InP en ComfyUI: video con fotograma inicial y final"
description: "Ejecuta el flujo de trabajo Wan2.2 Fun InP 14B en ComfyUI para generar video entre un fotograma inicial y uno final, con modelos de alto y bajo ruido y LoRAs Lightning."
sidebarTitle: "Wan2.2 Fun Inp"
-translationSourceHash: 16cf1b1c
+translationSourceHash: ff570640
translationFrom: tutorials/video/wan/wan2-2-fun-inp.mdx
translationBlockHashes:
"_intro": 7a3595d7
"ComfyOrg Wan2.2 Fun InP & Control Youtube Live Stream Replay": 22557a2e
+ "Wan2.2 Fun Inp Start-End Frame Video Generation Workflow Example": bc339657
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-**Wan2.2-Fun-Inp** es un modelo de generación de video controlado por fotograma inicial y final, lanzado por el equipo de Alibaba PAI. Permite introducir **imágenes de fotograma inicial y final** para generar videos con la transición intermedia, lo que brinda a los creadores un mayor control creativo. El modelo se publica bajo la **licencia Apache 2.0** y admite uso comercial.
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
+
+**Wan2.2-Fun-Inp** es un modelo de generación de video controlado por fotograma inicial y final, lanzado por el equipo de Alibaba PAI. Admite la introducción de **imágenes de fotograma inicial y final** para generar videos de transición intermedios, lo que brinda a los creadores un mayor control creativo. El modelo se publica bajo la **licencia Apache 2.0** y permite uso comercial.
**Características principales**:
-- **Control por fotograma inicial y final**: permite introducir imágenes de fotograma inicial y final para generar videos con la transición intermedia, lo que mejora la coherencia del video y la libertad creativa
+- **Control por fotograma inicial y final**: admite la introducción de imágenes de fotograma inicial y final para generar videos de transición intermedios, lo que mejora la coherencia del video y la libertad creativa
- **Generación de video de alta calidad**: basado en la arquitectura Wan2.2, produce videos con calidad de nivel cinematográfico
- **Soporte para múltiples resoluciones**: permite generar videos en 512x512, 768x768, 1024x1024 y otras resoluciones para adaptarse a distintos escenarios
**Versión del modelo**:
- **Versión de alto rendimiento 14B**: el tamaño del modelo supera los 32GB, ofrece mejores resultados pero exige mucha VRAM
-A continuación encontrarás los pesos del modelo y los repositorios de código relevantes:
+A continuación se muestran los pesos del modelo y los repositorios de código correspondientes:
- [🤗Wan2.2-Fun-Inp-14B](https://huggingface.co/alibaba-pai/Wan2.2-Fun-A14B-InP)
- Repositorio de código: [VideoX-Fun](https://github.com/aigc-apps/VideoX-Fun)
@@ -35,30 +37,30 @@ A continuación encontrarás los pesos del modelo y los repositorios de código
allowFullScreen
>
-## Ejemplo de flujo de trabajo de video con fotograma inicial y final de Wan2.2 Fun Inp
+## Ejemplo de flujo de trabajo de generación de video con fotograma inicial y final de Wan2.2 Fun Inp
Este flujo de trabajo ofrece dos versiones:
-1. Una versión con el LoRA de 4 pasos [Wan2.2-Lightning](https://huggingface.co/lightx2v/Wan2.2-Lightning) de lightx2v para acelerar la generación de video
+1. Una versión que usa el LoRA de 4 pasos [Wan2.2-Lightning](https://huggingface.co/lightx2v/Wan2.2-Lightning) de lightx2v para acelerar la generación de video
2. Una versión fp8_scaled sin LoRA de aceleración
-A continuación se muestran los resultados de las pruebas con una GPU RTX4090D de 24 GB de VRAM a una resolución de 640x640 con 81 fotogramas
+A continuación se muestran los resultados de las pruebas con una GPU RTX4090D de 24GB de VRAM, a una resolución de 640x640 y con 81 fotogramas
| Tipo de modelo | Uso de VRAM | Tiempo de la primera generación | Tiempo de la segunda generación |
-| ------------------------ | ---------- | -------------------- | --------------------- |
-| fp8_scaled | 83% | ≈ 524s | ≈ 520s |
-| fp8_scaled + 4-step LoRA | 89% | ≈ 138s | ≈ 79s |
+| ------------------------ | ----------- | ------------------------------- | ------------------------------- |
+| fp8_scaled | 83% | ≈ 524s | ≈ 520s |
+| fp8_scaled + 4-step LoRA | 89% | ≈ 138s | ≈ 79s |
-Como la aceleración con LoRA es notable, pero se pierde dinamismo en el video, los flujos de trabajo incluidos activan por defecto la versión con LoRA de aceleración. Si quieres activar el otro flujo de trabajo, selecciónalo y usa **Ctrl+B** para habilitarlo.
+Como la aceleración con LoRA es significativa pero se pierde el dinamismo del video, los flujos de trabajo incluidos habilitan por defecto la versión con LoRA acelerado. Si quieres habilitar el otro flujo de trabajo, selecciónalo y usa **Ctrl+B** para activarlo.
-### 1. Descarga el archivo del flujo de trabajo
+### 1. Descargar el archivo del flujo de trabajo
-Actualiza tu ComfyUI a la última versión y busca "**Wan2.2 Fun Inp**" en el menú `Workflow` -> `Browse Templates` -> `Video` para cargar el flujo de trabajo.
+Actualiza ComfyUI a la última versión y busca "**Wan2.2 Fun Inp**" en el menú `Flujo de trabajo` -> `Explorar plantillas` -> `Video` para cargar el flujo de trabajo.
-O bien, después de actualizar ComfyUI a la última versión, descarga el flujo de trabajo de abajo y arrástralo a ComfyUI para cargarlo.
+O bien, después de actualizar ComfyUI a la última versión, descarga el flujo de trabajo que aparece abajo y arrástralo a ComfyUI para cargarlo.
-
+
@@ -75,48 +77,48 @@ Usa los siguientes materiales como fotogramas inicial y final
- Fotograma inicial para la generación del video. Descarga y usa esta imagen, o reemplázala por la tuya.
+ Fotograma inicial para la generación de video. Descarga y usa esta imagen, o reemplázala por una tuya.
- Fotograma final para la generación del video. Descarga y usa esta imagen, o reemplázala por la tuya.
+ Fotograma final para la generación de video. Descarga y usa esta imagen, o reemplázala por una tuya.
### 2. Modelos
-Todos los modelos que se usan en esta guía están [aquí](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/tree/main/split_files).
+Todos los modelos que se usan en esta guía están disponibles [aquí](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged/tree/main/split_files).
**Modelos de difusión**
-
- wan2.2_fun_inpaint_high_noise_14B_fp8_scaled.safetensors: Modelo de difusión de alto ruido para inpainting entre fotograma inicial y final
+
+ wan2.2_fun_inpaint_high_noise_14B_fp8_scaled.safetensors: modelo de difusión de ruido alto para relleno inteligente de fotogramas inicial y final
-
- wan2.2_fun_inpaint_low_noise_14B_fp8_scaled.safetensors: Modelo de difusión de bajo ruido para inpainting entre fotograma inicial y final
+
+ wan2.2_fun_inpaint_low_noise_14B_fp8_scaled.safetensors: modelo de difusión de ruido bajo para relleno inteligente de fotogramas inicial y final
-**LoRA Lightning (opcional, para acelerar)**
+**LoRA Lightning (opcional, para aceleración)**
-
- wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors: LoRA de aceleración de 4 pasos para el modelo de alto ruido
+
+ wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors: LoRA de aceleración de 4 pasos para el modelo de ruido alto
-
- wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors: LoRA de aceleración de 4 pasos para el modelo de bajo ruido
+
+ wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors: LoRA de aceleración de 4 pasos para el modelo de ruido bajo
**VAE**
-
- wan_2.1_vae.safetensors: VAE de Wan2.1 para codificar y decodificar
+
+ wan_2.1_vae.safetensors: VAE Wan2.1 para codificar y decodificar
**Codificador de texto**
- umt5_xxl_fp8_e4m3fn_scaled.safetensors: Codificador de texto FP8 escalado
+ umt5_xxl_fp8_e4m3fn_scaled.safetensors: codificador de texto FP8 escalado
```
ComfyUI/
@@ -135,23 +137,24 @@ ComfyUI/
### 3. Guía del flujo de trabajo
-
+
- Este flujo de trabajo usa LoRA. Asegúrate de que el modelo de difusión y el LoRA correspondientes estén emparejados.
+ Este flujo de trabajo usa LoRA. Asegúrate de que el modelo de difusión y la LoRA correspondientes coincidan.
-1. Carga del modelo de **alto ruido** y del **LoRA**
+1. Carga del modelo de **ruido alto** y de **LoRA**
- Asegúrate de que el nodo `Load Diffusion Model` cargue el modelo `wan2.2_fun_inpaint_high_noise_14B_fp8_scaled.safetensors`
- - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue el `wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors`
-2. Carga del modelo de **bajo ruido** y del **LoRA**
+ - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue el archivo `wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors`
+2. Carga del modelo de **ruido bajo** y de **LoRA**
- Asegúrate de que el nodo `Load Diffusion Model` cargue el modelo `wan2.2_fun_inpaint_low_noise_14B_fp8_scaled.safetensors`
- - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue el `wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors`
+ - Asegúrate de que el nodo `LoraLoaderModelOnly` cargue el archivo `wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors`
3. Asegúrate de que el nodo `Load CLIP` cargue el modelo `umt5_xxl_fp8_e4m3fn_scaled.safetensors`
4. Asegúrate de que el nodo `Load VAE` cargue el modelo `wan_2.1_vae.safetensors`
-5. Sube las imágenes de fotograma inicial y final como materiales
-6. Escribe tu prompt en el grupo Prompt
+5. Sube las imágenes del fotograma inicial y del fotograma final como materiales
+6. Introduce tu prompt en el grupo Prompt
7. Ajusta el tamaño y la duración del video en el nodo `WanFunInpaintToVideo`
- - Ajusta los parámetros `width` y `height`. El valor predeterminado es `640`. Nosotros hemos definido un tamaño más pequeño, pero puedes modificarlo según lo necesites.
- - Ajusta `length`, que es el número total de fotogramas. Los fps actuales del flujo de trabajo son 16. Por ejemplo, si quieres generar un video de 5 segundos, debes definirlo en 5*16 = 80.
-8. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter`, para ejecutar la generación del video
+ - Ajusta los parámetros `width` y `height`. El valor predeterminado es `640`. Usamos un tamaño más pequeño, pero puedes modificarlo según tus necesidades.
+ - Ajusta `length`, que es el número total de fotogramas. Los fps del flujo de trabajo actual son 16. Por ejemplo, si quieres generar un video de 5 segundos, debes establecerlo en 5*16 = 80.
+8. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video
+
diff --git a/es/tutorials/video/wan/wan2_2.mdx b/es/tutorials/video/wan/wan2_2.mdx
index f86a0dbe4b..ee8f703de0 100644
--- a/es/tutorials/video/wan/wan2_2.mdx
+++ b/es/tutorials/video/wan/wan2_2.mdx
@@ -2,7 +2,7 @@
title: "Ejemplo de flujo de trabajo nativo oficial de ComfyUI para generación de video con Wan2.2"
description: "Ejecuta flujos de video Wan2.2 en ComfyUI: modelo híbrido TI2V 5B y ejemplos 14B de texto a video, imagen a video y primer/último fotograma, con descargas."
sidebarTitle: Wan2.2
-translationSourceHash: bafc80f0
+translationSourceHash: 49dd13ed
translationFrom: tutorials/video/wan/wan2_2.mdx
translationBlockHashes:
"_intro": 3d02f6d3
@@ -10,11 +10,13 @@ translationBlockHashes:
"Wan2.2 Open Source Model Versions": 7ed2d913
"ComfyOrg Wan2.2 Live Streams": 48f6d6e0
"Wan2.2 TI2V 5B Hybrid Version Workflow Example": 927f40b9
+ "Wan2.2 14B T2V Text-to-Video Workflow Example": 339329e2
"Wan2.2 14B I2V Image-to-Video Workflow Example": c73a3ba4
"Wan2.2 14B FLF2V Workflow Example": 732db33d
"Community Resources": 7463b48b
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
-Wan 2.2 es un nuevo modelo generativo multimodal de nueva generación lanzado por WAN AI. Este modelo adopta una innovadora arquitectura MoE (Mixture of Experts), compuesta por modelos expertos de alto ruido y de bajo ruido. Puede dividir los modelos expertos según los pasos de eliminación de ruido (timesteps), generando así contenido de video de mayor calidad.
+Wan 2.2 es un modelo generativo multimodal de nueva generación lanzado por WAN AI. Este modelo adopta una innovadora arquitectura MoE (Mixture of Experts), formada por modelos expertos de alto ruido y de bajo ruido. Puede dividir los modelos expertos según los pasos de denoising (timesteps) y así generar contenido de video de mayor calidad.
-Wan 2.2 tiene tres características principales: control estético de nivel cinematográfico, que integra profundamente los estándares estéticos de la industria del cine profesional y admite control visual multidimensional como iluminación, color y composición; movimiento complejo a gran escala, que recrea con facilidad diversos movimientos complejos y mejora la fluidez y el control del movimiento; y cumplimiento semántico preciso, que destaca en escenas complejas y en la generación de múltiples objetos, reproduciendo mejor las intenciones creativas del usuario.
-El modelo admite varios modos de generación, como texto a video e imagen a video, y es adecuado para la creación de contenido, la creación artística, la educación y la capacitación, entre otros escenarios de aplicación.
+Wan 2.2 tiene tres características principales: control estético de nivel cinematográfico, que integra en profundidad los estándares estéticos de la industria del cine profesional y admite control visual multidimensional como iluminación, color y composición; movimiento complejo a gran escala, que reproduce con facilidad diversos movimientos complejos y mejora la fluidez y el control del movimiento; y cumplimiento semántico preciso, que destaca en escenas complejas y en la generación de múltiples objetos, reproduciendo mejor las intenciones creativas de los usuarios.
+El modelo admite varios modos de generación, como texto a video e imagen a video, y es adecuado para la creación de contenido, la creación artística, la educación y el entrenamiento, entre otros escenarios de aplicación.
-[Wan2.2 Prompt Guide](https://alidocs.dingtalk.com/i/nodes/EpGBa2Lm8aZxe5myC99MelA2WgN7R35y)
+[Guía de prompts de Wan2.2](https://alidocs.dingtalk.com/i/nodes/EpGBa2Lm8aZxe5myC99MelA2WgN7R35y)
## Aspectos destacados del modelo
-- **Control estético de nivel cinematográfico**: Lenguaje de cámara profesional, admite control visual multidimensional como iluminación, color y composición
-- **Movimiento complejo a gran escala**: Restaura suavemente diversos movimientos complejos, mejora la controlabilidad y naturalidad del movimiento
-- **Cumplimiento semántico preciso**: Comprensión de escenas complejas, generación de múltiples objetos, mejor restauración de las intenciones creativas
-- **Tecnología de compresión eficiente**: Versión 5B con VAE de alta relación de compresión, optimización de memoria, admite entrenamiento mixto
+- **Control estético de nivel cinematográfico**: lenguaje de cámara profesional, admite control visual multidimensional como iluminación, color y composición
+- **Movimiento complejo a gran escala**: restaura con suavidad diversos movimientos complejos, mejora la controlabilidad y la naturalidad del movimiento
+- **Cumplimiento semántico preciso**: comprensión de escenas complejas, generación de múltiples objetos, restaura mejor las intenciones creativas
+- **Tecnología de compresión eficiente**: versión 5B con VAE de alta relación de compresión, optimización de memoria, admite entrenamiento mixto
## Versiones de modelos de código abierto Wan2.2
@@ -50,7 +52,7 @@ Los modelos de la serie Wan2.2 se basan en la licencia de código abierto Apache
## Transmisiones en vivo de ComfyOrg Wan2.2
-Para usar ComfyUI Wan2.2, hemos realizado transmisiones en vivo que puedes ver para aprender a usarlos.
+Para el uso de ComfyUI Wan2.2, hemos realizado transmisiones en vivo que puedes ver para aprender a usarlos.
+
Abrir en Comfy Cloud
- Descarga el JSON o busca "Wan2.2 14B T2V" en la Biblioteca de plantillas
+ Descarga el JSON o busca "Wan2.2 14B T2V" en la biblioteca de plantillas
@@ -178,10 +180,10 @@ Todos los modelos mencionados están disponibles en [Comfy-Org/Wan_2.2_ComfyUI_R
- Modelo de difusión de alto ruido. Colócalo en ComfyUI/models/diffusion_models/
+ Modelo de difusión de ruido alto. Colócalo en ComfyUI/models/diffusion_models/
- Modelo de difusión de bajo ruido. Colócalo en ComfyUI/models/diffusion_models/
+ Modelo de difusión de ruido bajo. Colócalo en ComfyUI/models/diffusion_models/
@@ -220,17 +222,17 @@ ComfyUI/
2. Asegúrate de que el segundo nodo `Load Diffusion Model` cargue el modelo `wan2.2_t2v_low_noise_14B_fp8_scaled.safetensors`.
3. Asegúrate de que el nodo `Load CLIP` cargue el modelo `umt5_xxl_fp8_e4m3fn_scaled.safetensors`.
4. Asegúrate de que el nodo `Load VAE` cargue el modelo `wan_2.1_vae.safetensors`.
-5. (Opcional) En el nodo `EmptyHunyuanLatentVideo`, puedes ajustar las configuraciones de tamaño y el número total de fotogramas del video (`length`).
+5. (Opcional) En el nodo `EmptyHunyuanLatentVideo`, puedes ajustar la configuración de tamaño y el número total de fotogramas del video (`length`).
6. (Opcional) Si necesitas modificar los prompts (positivo y negativo), hazlo en el nodo `CLIP Text Encoder` del paso 5.
7. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video.
## Ejemplo de flujo de trabajo de imagen a video con Wan2.2 14B I2V
-### Wan 2.2 14B de imagen a video {#video_wan2_2_14B_i2v}
+### Wan 2.2 14B imagen a video {#video_wan2_2_14B_i2v}
-Transforma imágenes estáticas en videos dinámicos con control preciso del movimiento y conservación del estilo usando Wan 2.2.
+Transforma imágenes estáticas en videos dinámicos con un control preciso del movimiento y conservación del estilo usando Wan 2.2.
-
+
@@ -260,16 +262,16 @@ Sube este archivo al nodo `LoadImage` correspondiente:
### 2. Descargar los modelos manualmente
-Todos los modelos mencionados están disponibles en [Comfy-Org/Wan_2.2_ComfyUI_Repackaged](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged).
+Todos los modelos mencionados se encuentran en [Comfy-Org/Wan_2.2_ComfyUI_Repackaged](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged).
**Modelos de difusión**
- Modelo de difusión I2V de alto ruido. Colócalo en ComfyUI/models/diffusion_models/
+ Modelo de difusión I2V de ruido alto. Colócalo en ComfyUI/models/diffusion_models/
- Modelo de difusión I2V de bajo ruido. Colócalo en ComfyUI/models/diffusion_models/
+ Modelo de difusión I2V de ruido bajo. Colócalo en ComfyUI/models/diffusion_models/
@@ -300,7 +302,7 @@ ComfyUI/
│ └───📂 vae/
│ └── wan_2.1_vae.safetensors
```
-### 3. Seguir los pasos
+### 3. Sigue los pasos

1. Asegúrate de que el primer nodo `Load Diffusion Model` cargue el modelo `wan2.2_t2v_high_noise_14B_fp8_scaled.safetensors`.
@@ -309,18 +311,18 @@ ComfyUI/
4. Asegúrate de que el nodo `Load VAE` cargue el modelo `wan_2.1_vae.safetensors`.
5. En el nodo `Load Image`, sube la imagen que se usará como fotograma inicial.
6. Si necesitas modificar los prompts (positivo y negativo), hazlo en el nodo `CLIP Text Encoder` del paso 6.
-7. (Opcional) En `EmptyHunyuanLatentVideo`, puedes ajustar las configuraciones de tamaño y el número total de fotogramas del video (`length`).
-8. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación del video.
+7. (Opcional) En `EmptyHunyuanLatentVideo`, puedes ajustar las configuraciones de tamaño y el número total de fotogramas de video (`length`).
+8. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video.
## Ejemplo de flujo de trabajo Wan2.2 14B FLF2V
-El flujo de trabajo de primer y último fotograma usa las mismas ubicaciones de modelo que la sección I2V.
+El flujo de trabajo de primer y último fotograma usa las mismas ubicaciones de modelos que la sección I2V.
-### Wan 2.2 14B primer-último fotograma a video {#video_wan2_2_14B_flf2v}
+### Wan 2.2 14B de primer y último fotograma a video {#video_wan2_2_14B_flf2v}
Genera transiciones de video suaves definiendo los fotogramas inicial y final.
-
+
@@ -358,8 +360,8 @@ Sube estos archivos a los nodos `LoadImage` correspondientes:
3. Ajusta las configuraciones de tamaño en el nodo `WanFirstLastFrameToVideo`.
- De forma predeterminada, se establece un tamaño relativamente pequeño para evitar que los usuarios con poca VRAM consuman demasiados recursos.
- Si tienes suficiente VRAM, puedes probar una resolución de alrededor de 720P.
-4. Escribe prompts adecuados según tus fotogramas inicial y final.
-5. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video.
+4. Escribe los prompts adecuados según tus fotogramas inicial y final.
+5. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video.
## Recursos de la comunidad
diff --git a/es/tutorials/video/zai/scail2.mdx b/es/tutorials/video/zai/scail2.mdx
index 7e398aa607..2596589664 100644
--- a/es/tutorials/video/zai/scail2.mdx
+++ b/es/tutorials/video/zai/scail2.mdx
@@ -2,7 +2,7 @@
title: "Tutorial del flujo de trabajo de reemplazo de personaje con SCAIL-2 en ComfyUI"
description: "Anima una imagen de personaje de referencia con un video guía o reemplaza al personaje del video usando SCAIL-2."
sidebarTitle: "SCAIL-2"
-translationSourceHash: 2e9bdad8
+translationSourceHash: 2ebe58cb
translationFrom: tutorials/video/zai/scail2.mdx
translationBlockHashes:
"_intro": a41dfa9a
@@ -10,16 +10,18 @@ translationBlockHashes:
"How the Workflow Works": fad0cdce
"Two Modes": 639623de
"Inputs and Parameters": 5762889f
+ "Model Installation": afc8e5d3
---
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
-**SCAIL-2** es un modelo de animación de personajes de extremo a extremo construido sobre Wan2.1. Impulsa una imagen de referencia de un personaje con un video de conducción, lo que permite tanto la animación de personajes (hacer que un personaje ejecute el movimiento) como el reemplazo de personajes dentro del video (sustituir a una persona rastreada en un video por el personaje de referencia).
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
+
+**SCAIL-2** es un modelo de animación de personajes de extremo a extremo construido sobre Wan2.1. Impulsa una imagen de referencia de un personaje con un video guía, lo que permite tanto la animación de personajes (hacer que un personaje ejecute el movimiento) como el reemplazo de personajes dentro del video (sustituir a una persona rastreada en un video por el personaje de referencia).
**Características principales**:
-- **Animación de personajes de extremo a extremo**: Impulsa una imagen fija de un personaje con el movimiento de un video de conducción
-- **Dos modos**: Modo Animación (el personaje ejecuta el movimiento) y Modo Reemplazo (sustituye la persona rastreada por el personaje de referencia)
-- **Soporte para video largo**: Generación extendida basada en fragmentos con superposición de fotogramas entre segmentos
-- **Nodos integrados de ComfyUI**: Usa `WanSCAILToVideo`, `SCAIL2ColoredMask` y el seguimiento `SAM3` nativos. No se requieren nodos personalizados más allá de las descargas de modelos estándar.
+- **Animación de personajes de extremo a extremo**: impulsa una imagen fija de un personaje con el movimiento de un video guía
+- **Dos modos**: Modo Animación (el personaje ejecuta el movimiento) y Modo Reemplazo (sustituye a la persona rastreada por el personaje de referencia)
+- **Soporte para video largo**: generación extendida basada en fragmentos con superposición de fotogramas entre segmentos
+- **Nodos integrados de ComfyUI**: usa los nodos nativos `WanSCAILToVideo`, `SCAIL2ColoredMask` y el seguimiento `SAM3`. No necesitas nodos personalizados más allá de las descargas de modelos estándar.
**Enlaces relacionados**:
- [Hugging Face: SCAIL-2](https://huggingface.co/zai-org/SCAIL-2)
@@ -46,10 +48,10 @@ Reemplaza a un personaje en un video conservando el movimiento y el contexto de
- Descarga la imagen de referencia predeterminada del personaje o usa la tuya.
+ Descarga la imagen de referencia del personaje predeterminada o usa la tuya.
-
- Descarga el video conductor predeterminado o usa el tuyo.
+
+ Descarga el video guía predeterminado o usa el tuyo.
@@ -65,18 +67,19 @@ Este flujo de trabajo usa dos nodos de subgrafo: un subgrafo **Base** (primer se
4. Previsualiza el resultado y guárdalo
- Este flujo de trabajo usa nodos Subgraph para un procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y extender el flujo de trabajo.
+ Este flujo de trabajo usa nodos de subgrafo para un procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y extender el flujo de trabajo.
+
### Videos largos
-Para videos más largos, calcula el número de segmentos: `ceil(total_frames / 76)`. Todos los segmentos excepto el primero usan el subgrafo Extend. Duplica el nodo Extend para más segmentos, encadena la salida `previous_frames` e incrementa `segment_index`.
+Para videos más largos, calcula el número de segmentos: `ceil(total_frames / 76)`. Cada segmento excepto el primero usa el subgrafo Extend. Duplica el nodo Extend para más segmentos, encadena la salida `previous_frames` e incrementa `segment_index`.
> **Nota:** `WanSCAILToVideo` no puede poner en cola todos los segmentos automáticamente. Ejecuta cada segmento manualmente.
## Dos modos
-| Modo | `replace_mode` | Fondo de la máscara de conducción | Resumen |
-|------|:--------------:|:-------------------------------:|---------|
+| Modo | `replace_mode` | Fondo de la máscara del video de conducción | Resumen |
+|------|:--------------:|:-------------------------------------------:|---------|
| **Reemplazo** | `true` (predeterminado) | Blanco | Intercambia la persona rastreada en el video de conducción por el personaje de referencia |
| **Animación** | `false` | Negro | El personaje de referencia realiza el movimiento del video de conducción |
@@ -96,11 +99,11 @@ Establece el parámetro `replace_mode` en ambos nodos del subgrafo.
| `width` / `height` | Resolución de salida, por ejemplo `896×512`. Debe ser divisible entre 16 |
| `frame_count` | Fotogramas por segmento (predeterminado: 81) |
| `previous_frame_count` | Fotogramas de superposición entre segmentos (predeterminado: 5) |
-| `pose_strength` / `pose_start` / `pose_end` | Intensidad y sincronización del conditioning de pose |
+| `pose_strength` / `pose_start` / `pose_end` | Intensidad y sincronización del acondicionamiento de pose |
### Seguimiento con SAM3 (dos entradas)
-Las entradas `sam3_video_object` y `sam3_image_object` controlan el seguimiento de máscaras de SAM3, **no** el prompt de salida de SCAIL-2. Estas determinan qué objetos se rastrean para las máscaras de color:
+Las entradas `sam3_video_object` y `sam3_image_object` controlan el seguimiento de máscaras de SAM3, **no** el prompt de salida de SCAIL-2. Determinan qué objetos se rastrean para las máscaras de color:
| Entrada | Objetivo | Salida |
|-------|--------|--------|
@@ -113,9 +116,9 @@ Las entradas `sam3_video_object` y `sam3_image_object` controlan el seguimiento
## Instalación de modelos
-Actualiza ComfyUI a la última versión para tener los nodos integrados WanSCAILToVideo y SCAIL2ColoredMask.
+Primero actualiza ComfyUI a la última versión para usar los nodos integrados WanSCAILToVideo y SCAIL2ColoredMask.
-### Modelos necesarios
+### Modelos requeridos
**diffusion_models**
- [wan2.1_14B_SCAIL_2_fp16.safetensors](https://huggingface.co/Comfy-Org/SCAIL-2/blob/main/diffusion_models/wan2.1_14B_SCAIL_2_fp16.safetensors)
@@ -155,3 +158,4 @@ ComfyUI/
│ └── checkpoints/
│ └── sam3.1_multiplex_fp16.safetensors
```
+
 +
 +
 -
 +
 +
 -### 1. Flujo de trabajo y recurso de outpainting
+### 1. Flujo de trabajo de outpainting y recursos
### 2. Pasos para ejecutar el flujo de trabajo
-
+
1. Asegúrate de que el nodo `Load Diffusion Model` tenga cargado `flux1-fill-dev.safetensors`.
2. Asegúrate de que el nodo `DualCLIPLoader` tenga cargados los siguientes modelos:
diff --git a/es/tutorials/flux/flux-1-kontext-dev.mdx b/es/tutorials/flux/flux-1-kontext-dev.mdx
index c196d2edc8..d9952f2eaf 100644
--- a/es/tutorials/flux/flux-1-kontext-dev.mdx
+++ b/es/tutorials/flux/flux-1-kontext-dev.mdx
@@ -2,15 +2,17 @@
title: "FLUX.1 Kontext Dev en ComfyUI: edición de imágenes en local"
description: "Edita imágenes en local en ComfyUI con FLUX.1 Kontext Dev, el modelo de 12B de Black Forest Labs para ediciones consistentes, estilo y refinado iterativo."
sidebarTitle: "FLUX.1 Kontext Dev"
-translationSourceHash: 391031ed
+translationSourceHash: 6b87ee9a
translationFrom: tutorials/flux/flux-1-kontext-dev.mdx
translationBlockHashes:
"_intro": 51c48128
"About FLUX.1 Kontext Dev": bb2f00f7
+ "Model Download": e6b40970
"FLUX.1 Kontext Dev Workflow": 8408eb0d
---
+
import PromptTechniques from "/snippets/es/tutorials/flux/prompt-techniques.mdx";
-import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
+import UpdateReminder from '/snippets/es/tutorials/update-reminder.mdx'
## Descarga de modelos
-Para ejecutar correctamente los flujos de trabajo de esta guía, primero necesitas descargar los siguientes archivos de modelo. También puedes obtener directamente los enlaces de descarga de los modelos desde los flujos de trabajo correspondientes, que ya incluyen la información de descarga de los archivos de modelo.
+Para ejecutar los flujos de trabajo de esta guía correctamente, primero necesitas descargar los siguientes archivos de modelo. También puedes obtener directamente los enlaces de descarga de los modelos desde los flujos de trabajo correspondientes, que ya incluyen la información de descarga de los archivos de modelo.
**Modelo de difusión**
- [flux1-dev-kontext_fp8_scaled.safetensors](https://huggingface.co/Comfy-Org/flux1-kontext-dev_ComfyUI/blob/main/split_files/diffusion_models/flux1-dev-kontext_fp8_scaled.safetensors)
 +
 -**Salida de ejemplo**
+**Ejemplo de salida**
 +
 +
 +
 @@ -71,36 +73,36 @@ Este flujo de trabajo demuestra las capacidades principales de **generación de
- **Prompt de texto**: tu pregunta o instrucción
- **Imagen** (opcional): para tareas de comprensión visual (OCR, detección de objetos, lectura de gráficos, etc.)
- **Audio** (opcional): para reconocimiento de voz o transcripción
-- **Video** (opcional): la plantilla carga el video y lo divide con **Get Video Components**, pero esos fotogramas no están conectados al generador de texto, así que el video no afecta a la salida
+- **Video** (opcional): la plantilla carga el video y lo divide con **Obtener componentes de video**, pero esos fotogramas no están conectados al generador de texto, así que el video no afecta la salida
**Controles principales**:
- **Longitud máxima**: número máximo de tokens a generar (256 por defecto)
- **Modo de muestreo**: activa o desactiva el muestreo y ajusta temperatura, top-k, top-p, penalización por repetición y semilla
-- **Modo de razonamiento**: activa el razonamiento paso a paso antes de la respuesta final
+- **Modo de pensamiento**: activa el razonamiento paso a paso antes de la respuesta final
- **Usar plantilla predeterminada**: aplica el prompt de sistema integrado del modelo
**Salida**:
- **Texto generado**: la respuesta del modelo como una cadena de texto sin formato
 +
 +
 +
 +
 +
 +
 +
 +
 +
 +
 +
 +
 +
 +
 +
 +
 +
 @@ -184,7 +186,7 @@ Sube este archivo al nodo `LoadImage` correspondiente:
 +
 +
 +
 +
 +